
编码与格式 / 系统课时
音频设备采集
音频设备采集
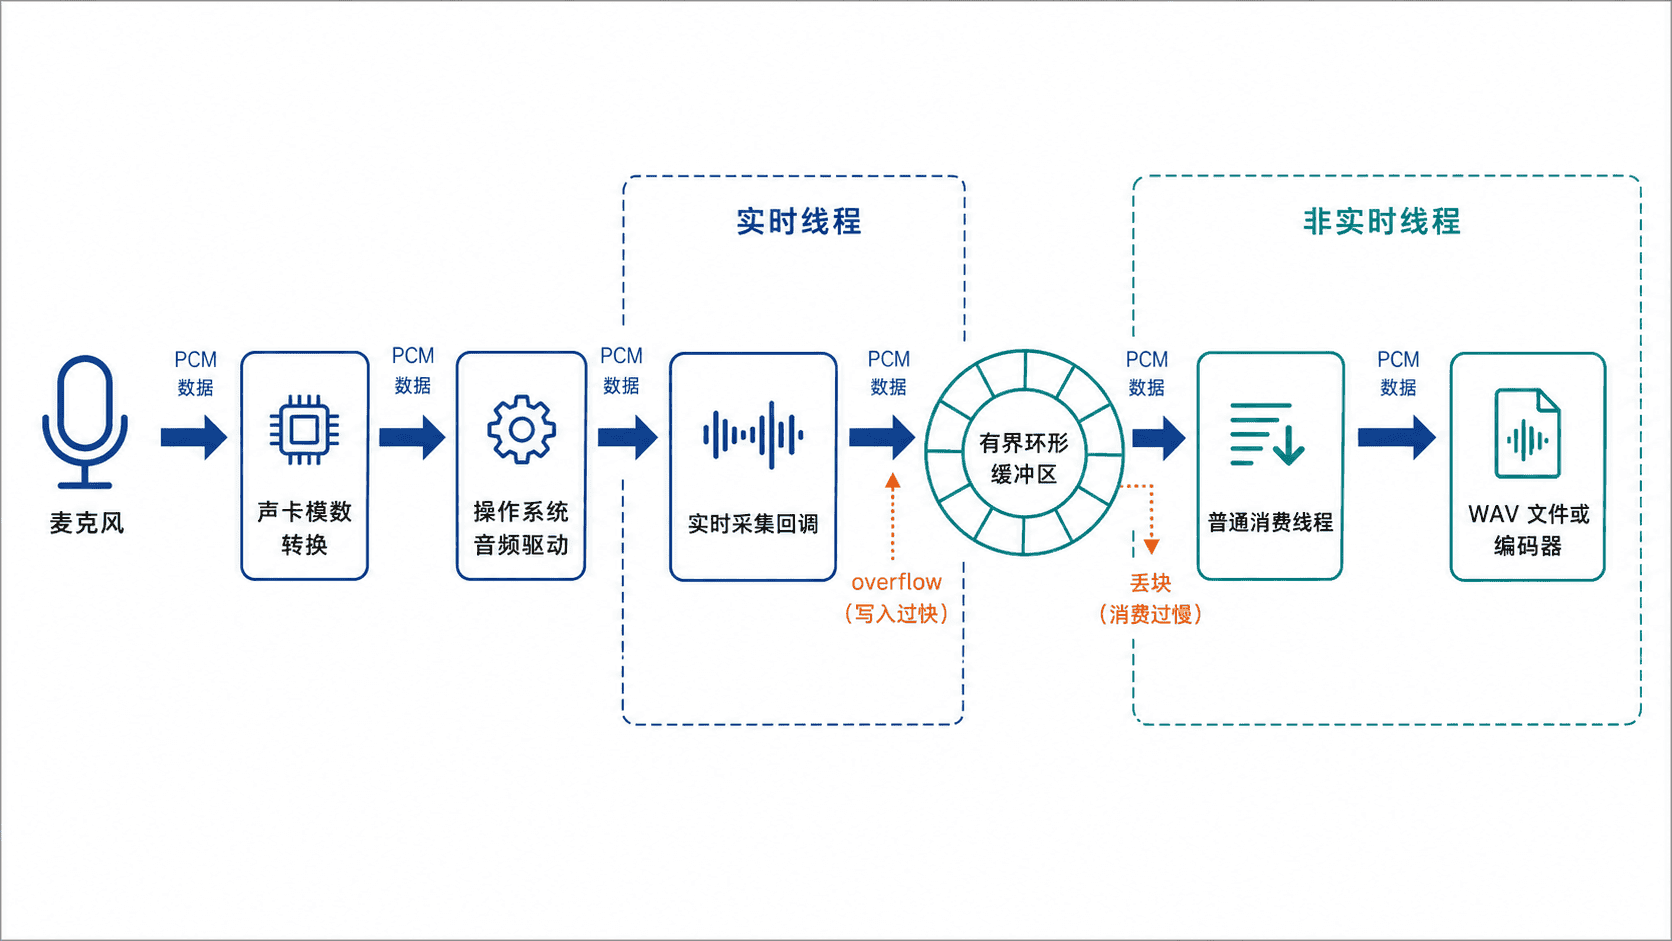
本课完成一条可运行的麦克风采集链路:设备回调按固定帧数接收 PCM,将数据快速写入有界队列,再由普通线程保存为 WAV。重点是把实时回调与磁盘、编码、网络等慢操作隔离,避免采集溢出和音频断裂。
学习目标
- 说清麦克风、驱动、采集回调与消费线程之间的数据流
- 根据采样率和块大小计算回调周期与缓冲容量
- 使用有界队列采集 16 位 PCM,并识别溢出和设备状态异常
采集链路与数据格式
麦克风先把声压变化转换为模拟电信号,声卡完成模数转换,操作系统音频接口再把样本按块交给应用。应用通常不会逐样本读取,而是由设备线程周期性触发回调,例如每 20 毫秒交付一块 PCM。
本课使用 48 kHz、单声道、16 位有符号整数。每秒原始数据量为 48000 × 1 × 2 = 96000 字节。块大小设为 960 帧时,每块正好覆盖 20 毫秒,单块大小为 1920 字节。
回调与缓冲区设计
采集回调的首要规则是“尽快返回”。回调中适合做数据复制、时间戳记录和无阻塞入队,不适合写文件、打印大量日志、执行网络请求或调用耗时编码器。因为这些操作一旦超过回调周期,设备缓冲区就可能被新数据覆盖。缓冲时长可按下式估算:
其中,N 是队列可容纳的块数,B 是每块帧数,F_s 是采样率。本例队列容量为 20 块,因此理论缓冲时长为 20 × 960 ÷ 48000 = 0.4 秒。容量太小容易溢出,容量太大又会增加端到端延迟和内存占用。
有界队列比无限队列更适合实时采集。无限队列会在消费端长期跟不上时持续吃内存,而有界队列能立即暴露处理能力不足的问题。队列满时,本例选择丢弃当前块并累计计数;实时通话也可根据业务改为丢弃最旧块,以优先保留最新声音。
完整采集示例
示例使用 sounddevice 访问默认输入设备,使用标准库 wave 写入 5 秒单声道 PCM WAV。先安装依赖:
python -m pip install numpy sounddevice预期结果:
Requirement already satisfied: <PACKAGE>
或
Successfully installed <PACKAGE_LIST>
下面的程序把设备回调限制为复制与入队,文件写入放在主线程执行。若系统没有默认麦克风、权限未开启或设备正被独占,程序会由底层音频库报告设备错误。
import queue
import wave
from pathlib import Path

import sounddevice as sd

SAMPLE_RATE = 48_000
CHANNELS = 1
BLOCK_FRAMES = 960
DURATION_SECONDS = 5
QUEUE_BLOCKS = 20
OUTPUT_FILE = Path("capture.wav")

audio_queue = queue.Queue(maxsize=QUEUE_BLOCKS)
dropped_blocks = 0
status_events = 0

def on_audio(indata, frames, time_info, status):
    global dropped_blocks, status_events

    if status:
        status_events += 1

    # 设备可能复用 indata 的底层内存,因此必须在回调返回前复制。
    pcm_bytes = indata.copy().tobytes()
    try:
        audio_queue.put_nowait(pcm_bytes)
    except queue.Full:
        # 回调不能等待消费者;队列满时记录并丢弃当前块。
        dropped_blocks += 1

def main():
    target_blocks = DURATION_SECONDS * SAMPLE_RATE // BLOCK_FRAMES
    written_blocks = 0
    block_ms = BLOCK_FRAMES / SAMPLE_RATE * 1000

    with wave.open(str(OUTPUT_FILE), "wb") as wav_file:
        wav_file.setnchannels(CHANNELS)
        wav_file.setsampwidth(2)
        wav_file.setframerate(SAMPLE_RATE)

        with sd.InputStream(
            samplerate=SAMPLE_RATE,
            channels=CHANNELS,
            dtype="int16",
            blocksize=BLOCK_FRAMES,
            callback=on_audio,
        ):
            print(
                f"开始采集:{SAMPLE_RATE} Hz,"
                f"{CHANNELS} 声道,{block_ms:.0f} ms/块"
            )

            # 慢操作留在普通线程,直到收够目标块数。
            while written_blocks < target_blocks:
                chunk = audio_queue.get(timeout=1.0)
                wav_file.writeframesraw(chunk)
                written_blocks += 1

    actual_seconds = written_blocks * BLOCK_FRAMES / SAMPLE_RATE
    print(
        f"已写入 {OUTPUT_FILE},音频时长 {actual_seconds:.2f} 秒,"
        f"丢弃块数 {dropped_blocks},状态事件 {status_events}"
    )

if __name__ == "__main__":
    main()
预期输出:
开始采集:48000 Hz,1 声道,20 ms/块
已写入 capture.wav,音频时长 5.00 秒,丢弃块数 0,状态事件 0
设备繁忙时,丢弃块数或状态事件可能大于 0;这不是应被隐藏的随机差异,而是需要继续定位的实时性信号。
结果验证与典型问题
正常完成后,当前目录会出现 capture.wav。播放器应能识别它为 48 kHz、单声道、16 位 PCM,时长约 5 秒。若声音过小,先检查系统输入增益和麦克风距离;不要直接在整数 PCM 上无限放大,否则容易削波。
出现断续声音时,先观察丢弃块数,再按顺序检查:主线程是否做了额外计算、队列容量是否过小、设备块大小是否过于激进、系统是否发生长时间调度停顿。单纯把队列调得很大只能掩盖消费端过慢,并会扩大延迟。
完全没有数据时,优先确认应用的麦克风权限、默认输入设备、声道数量和采样率是否被设备支持。某些设备只支持特定采样率,生产代码应枚举设备能力,并允许用户选择设备,而不是永久依赖系统默认项。