
C / C++ / 系统课时
指针越界为什么容易崩溃
指针越界为什么容易崩溃
指针运算本身不会记录“数组边界”。一旦解引用了数组范围之外的地址,程序就进入未定义行为:可能读到垃圾值、改坏别的数据,也可能立刻崩溃。排查这类问题的关键,是先确认合法地址区间,再检查每次偏移是否仍在区间内。
学习目标
- 理解指针越界与未定义行为的关系
- 区分越界读取和越界写入可能造成的后果
- 掌握用显式长度和边界检查避免越界
合法范围只覆盖数组元素
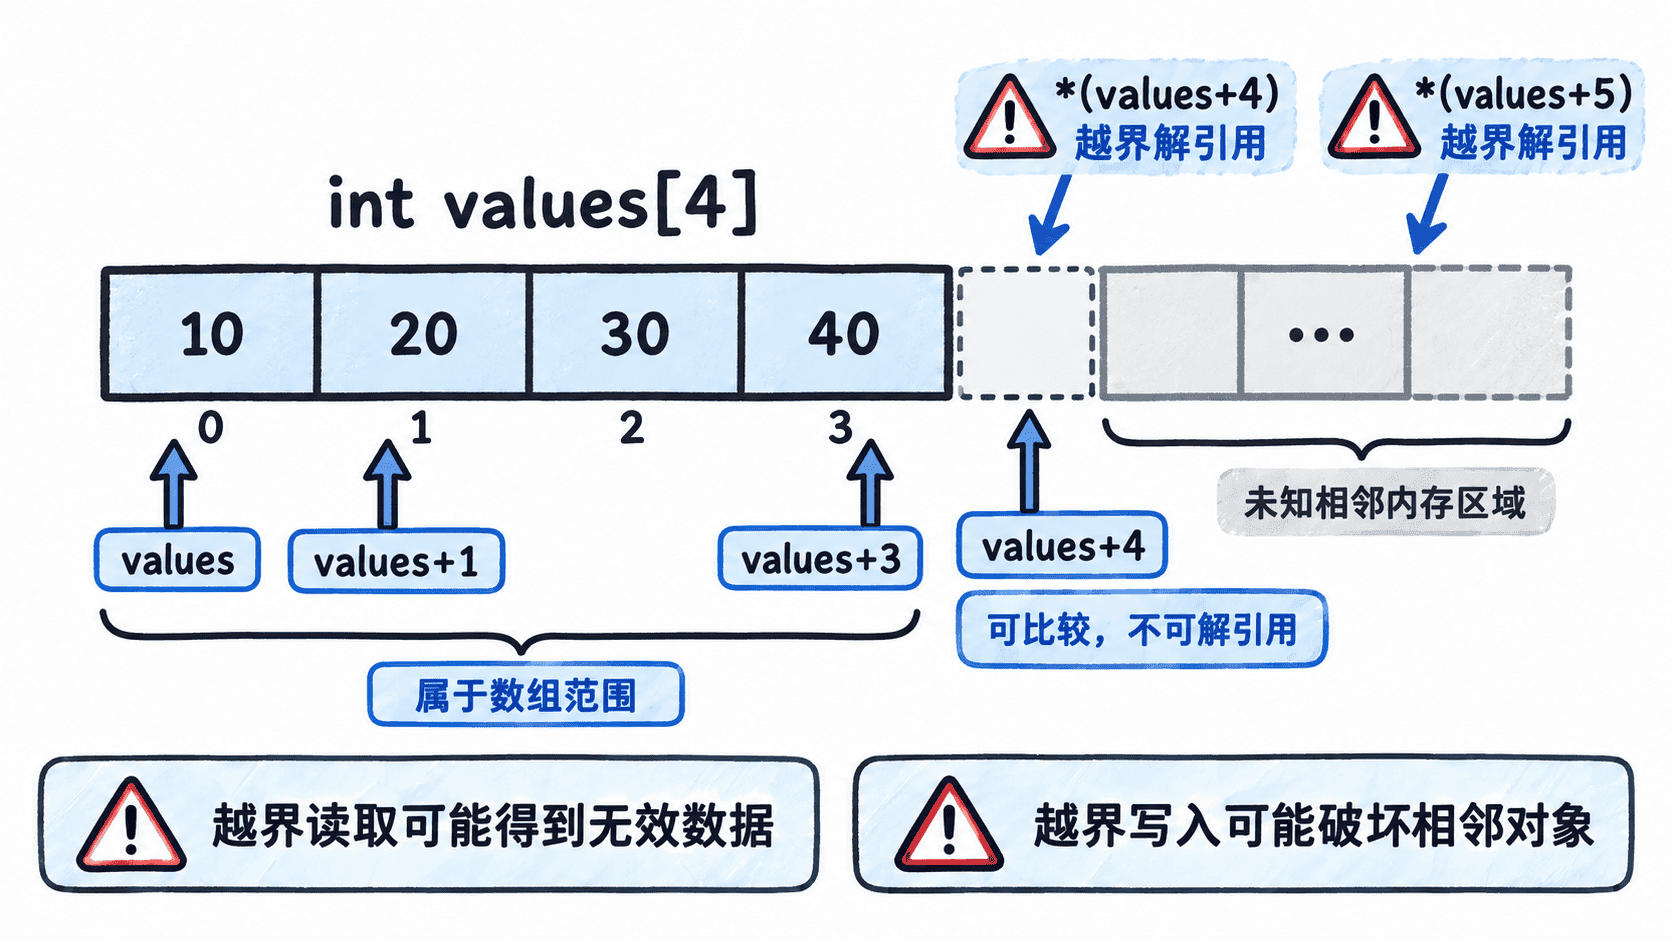
假设有 int values[4],可以形成指向 values[0] 到 values[3] 的指针,也可以形成“尾后一位”指针 values + 4 用于比较或循环终止。
但尾后一位指针不能被解引用。下面的访问都是越界:
int x = values[4];      // 片段示例:越界读取
values[4] = 99;         // 片段示例:越界写入
int y = *(values + 5);  // 片段示例:越界读取
这些片段依赖已定义的 int values[4] 上下文,且故意展示错误边界,不能作为正确代码直接使用。C 标准不会规定它们“应该返回什么”或“必须怎样崩溃”。
越界读取为什么不一定马上崩溃
越界读取只是去访问了一个不属于目标数组元素的地址。那个地址有时仍位于当前进程已映射的内存页内,所以硬件未必立刻报错,程序可能“看起来还能跑”。
这正是它危险的地方:未崩溃不等于合法。编译器可以基于“程序不会发生未定义行为”的前提做优化,因此同一段越界代码在不同编译选项、平台或输入下可能表现完全不同。
越界写入风险更高,因为它可能覆盖邻近变量、对象元数据或控制数据。真正出现崩溃的位置还可能晚于写坏内存的位置,让故障看起来像发生在完全无关的代码里。
用边界检查把访问限制在合法区间
下面的程序把“地址”和“元素数量”一起交给读取函数。只有下标小于 length 时才解引用指针,从接口层面阻止越界。
#include <stdio.h>
#include <stddef.h>
#include <stdbool.h>

static bool read_at(const int *values, size_t length, size_t index, int *out) {
    if (values == NULL || out == NULL || index >= length) {
        return false;
    }

    *out = values[index];
    return true;
}

int main(void) {
    int values[] = {11, 22, 33, 44};
    size_t length = sizeof(values) / sizeof(values[0]);
    int result = 0;

    if (read_at(values, length, 2, &result)) {
        printf("index 2: %d\n", result);
    }

    if (!read_at(values, length, 4, &result)) {
        printf("index 4: out of range\n");
    }

    return 0;
}
预期输出
index 2: 33
index 4: out of range
这里的关键不是 read_at 这个函数名,而是检查顺序:先验证指针和下标,再解引用。若先执行 values[index] 再判断是否越界,错误访问已经发生,检查就失去意义。
排查疑似越界时看什么
出现随机崩溃、数组数据莫名变化或只在优化版本出错时,先追踪三件事:基地址来自哪里、元素数量是多少、每一次偏移如何计算。特别关注循环条件中的 <= 与 <、负数转成 size_t 后变成超大正数,以及长度单位到底是“元素个数”还是“字节数”。
调试阶段可以开启编译器警告,并使用 AddressSanitizer 等动态检测工具定位非法访问;但工具只能帮助发现问题,代码本身仍应把长度作为明确契约并在解引用前完成边界检查。
指针可以指向数组内部元素,也可以形成尾后一位地址用于循环终止,但只有合法元素地址才能被解引用。把“起始地址 + 元素数量”视为不可拆开的边界信息,是避免这类内存错误最稳定的做法。