
C / C++ / 系统课时
栈和堆分别适合存什么
栈和堆分别适合存什么
写 C 程序时,局部变量通常直接放在栈上,而需要跨越当前作用域、大小在运行时决定或体积较大的数据,常常放到堆上。理解两者的申请方式、生命周期和释放责任,能帮助你避免栈溢出、内存泄漏和悬空指针。
学习目标
- 区分栈对象与堆对象的申请方式、生命周期和管理责任
- 根据数据大小和存活时间选择更合适的存储区域
- 正确配对
malloc与free,避免动态内存泄漏
栈和堆的核心差别
在典型 C 程序里,函数的局部自动变量通常具有自动存储期:进入作用域时可用,离开作用域后生命周期结束。程序员不需要显式释放它们,编译器和运行时会随着函数调用自动管理这些对象。
堆上的对象则通常由 malloc、calloc 或 realloc 动态申请。它们不会因为创建它们的函数返回就自动销毁,而是一直存在到程序调用 free,或者进程结束。灵活性的代价是:释放责任由程序自己承担。
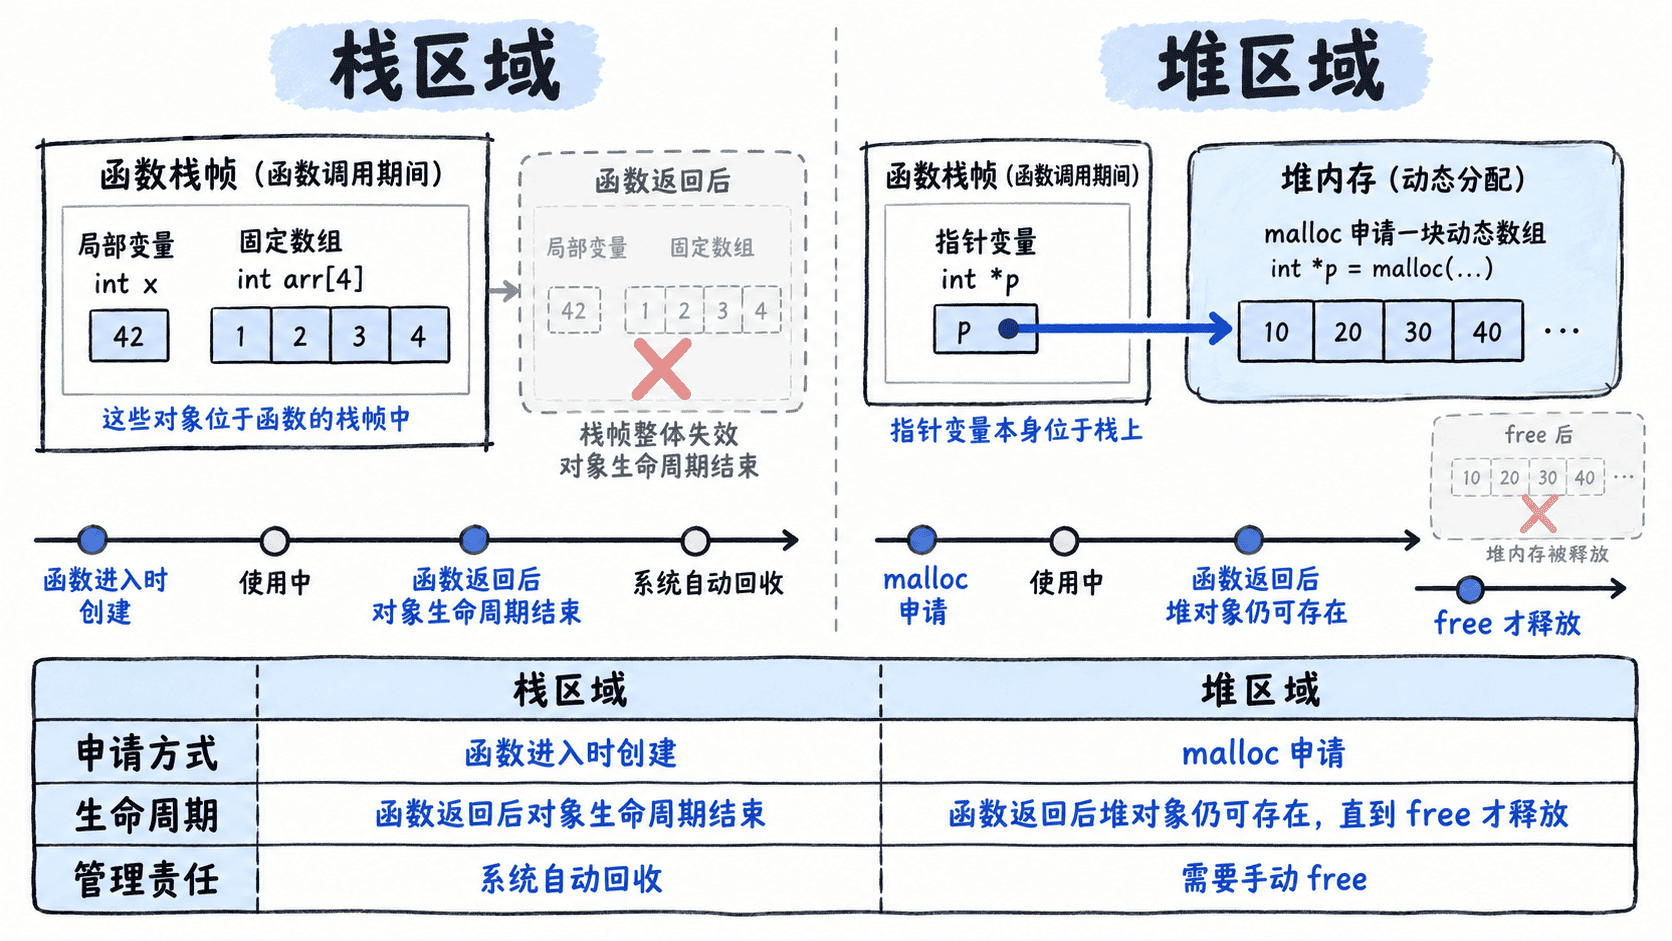
可以把选择问题压缩成三项:大小是否已知、需要活多久、谁负责释放。固定且较小的临时数据优先考虑栈;大小运行时决定、需要跨函数继续存在或对象较大时,才考虑堆。
用一段程序观察两种对象
下面的程序同时创建一个栈数组和一个堆数组。注意:dynamic_scores 这个指针变量本身通常仍是局部变量,而它指向的数据区域来自堆。
#include <stdio.h>
#include <stdlib.h>

int main(void) {
    int local_scores[3] = {90, 85, 88};

    size_t count = 5;
    int *dynamic_scores = malloc(count * sizeof *dynamic_scores);
    if (dynamic_scores == NULL) {
        fprintf(stderr, "memory allocation failed\n");
        return 1;
    }

    // 堆数组的大小可以由运行时变量 count 决定。
    for (size_t i = 0; i < count; ++i) {
        dynamic_scores[i] = (int)(70 + i);
    }

    printf("stack: %d %d %d\n",
           local_scores[0], local_scores[1], local_scores[2]);
    printf("heap: %d %d %d %d %d\n",
           dynamic_scores[0], dynamic_scores[1], dynamic_scores[2],
           dynamic_scores[3], dynamic_scores[4]);

    // 动态申请成功后,所有正常退出路径都应安排对应的 free。
    free(dynamic_scores);
    return 0;
}
预期输出:
stack: 90 85 88
heap: 70 71 72 73 74这里真正决定是否用堆的不是“数组”这个类型,而是需求:local_scores 的长度固定、只在 main 内使用,因此栈足够;dynamic_scores 的长度由变量决定,使用动态分配更合适。
什么情况下更适合放在栈上
当对象只服务于当前函数,尺寸较小且编译时就能确定时,栈通常最简单。常见例子包括计数器、状态标志、小型结构体、短生命周期的固定数组。
栈的优势是管理成本低:不需要手动释放,也不会产生忘记 free 的泄漏问题。但栈空间通常远小于进程可用的堆空间,因此不要把非常大的数组作为局部变量机械地塞进栈中。
什么情况下更适合放在堆上
当数据大小在运行时才知道、需要由多个函数共享、需要在创建函数返回后继续存在,或者对象体积较大时,堆更合适。典型场景包括动态数组、链表节点、树节点、可变长度缓冲区和需要返回给调用者长期使用的数据。
选择时关注生命周期而不是变量名
最实用的判断顺序是:先确定对象需要存活到什么时候,再看大小是否适合当前栈空间,最后决定是否需要动态分配。如果选择堆,就要同时设计所有权:谁创建、谁使用、谁最终调用 free。
栈和堆不是“局部变量与全局变量”的同义词,也不是某种 C 类型的固有属性。真正需要掌握的是对象的存储期和所有权:短生命周期、固定小对象优先栈;生命周期或尺寸需要动态控制时再使用堆。