
C / C++ / 系统课时
数组越界为何会破坏其他变量
数组越界为何会破坏其他变量
数组越界写入不是“只把数组自己写坏”,而是会把数组边界之外的内存当成自己的元素修改。最危险之处在于程序可能暂时不崩溃,却悄悄改变附近变量、控制数据或堆元数据,直到更晚才出现异常。
学习目标
- 解释越界写入为何可能影响数组之外的对象
- 从索引合法范围和真实容量两端检查边界
- 使用编译器与 AddressSanitizer 更快定位越界位置
越界写入的本质
假设定义了 int values[4],合法下标只有 0 到 3。表达式 values[4] = 99 不会自动扩容,也不会由 C 语言替你检查边界;它会尝试按照“第 5 个 int”的地址写入数据。
这已经属于未定义行为。后果可能是覆盖相邻变量、破坏栈帧中的其他数据,也可能暂时看不出问题。不同编译器、优化级别和运行环境下,表现都可能不同,因此不能把“这次没崩”当成正确。
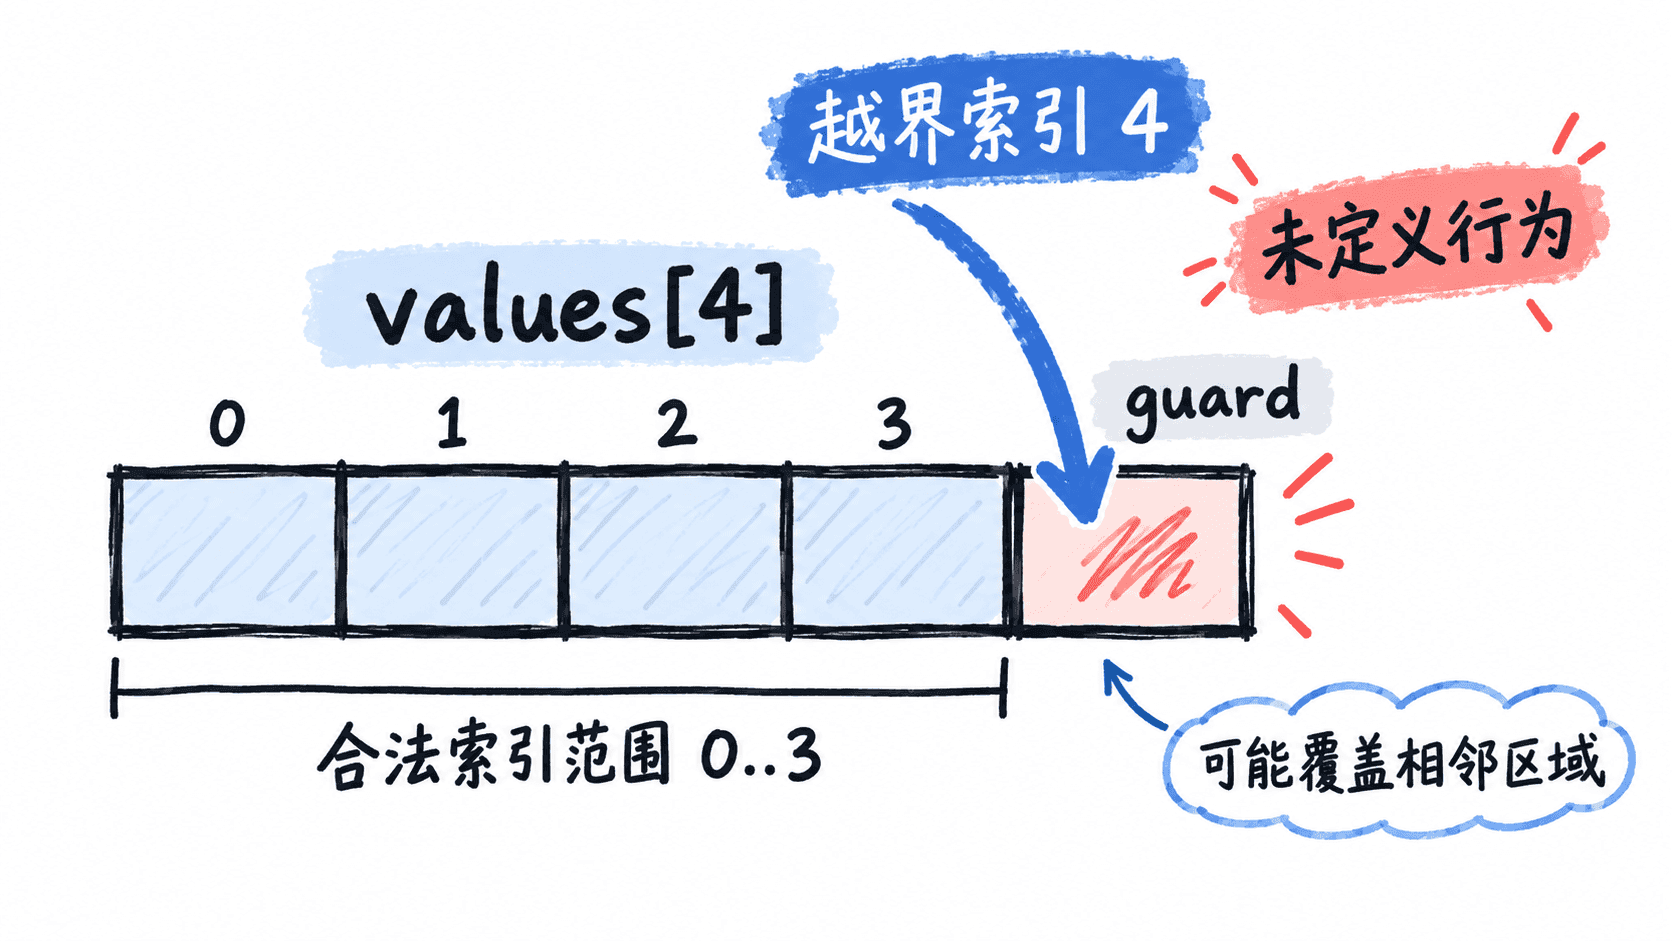
下面是一个典型的错误片段。它不能作为可靠程序行为来验证,因为最后一行本身已经触发未定义行为。
int values[4] = {10, 20, 30, 40};
int index = 4;

/* 片段示例:index 等于 4,已经超出合法范围 0..3。 */
values[index] = 99;
同时检查索引和容量
排查越界时不要只盯着循环条件,还要确认“数组实际有多大”。常见错误包括把元素个数和最后一个下标混淆、循环使用 <=、动态数组扩容后仍沿用旧容量,以及把字节数误当成元素数。
下面的完整示例通过数组长度计算和边界判断保证写入合法。
#include <stdio.h>

int main(void) {
    int values[4] = {10, 20, 30, 40};
    size_t count = sizeof values / sizeof values[0];
    size_t index = 3;

    if (index < count) {
        values[index] = 99;
        printf("values[%zu] = %d\n", index, values[index]);
    } else {
        printf("index out of range\n");
    }

    return 0;
}
预期输出
values[3] = 99关键规则是:对长度为 count 的数组,合法条件应是 index < count,而不是 index <= count。当索引来自用户输入、文件内容或计算结果时,写入前都应执行这一判断。
用 AddressSanitizer 定位越界
肉眼检查能发现简单错误,但复杂循环、指针偏移和多层调用更适合交给运行时检测工具。GCC 或 Clang 可使用 AddressSanitizer 编译程序:
cc -Wall -Wextra -fsanitize=address -g main.c -o main
./main
预期结果
如果程序发生越界访问,AddressSanitizer 会在运行时报告内存越界错误,并给出相关调用位置;具体地址、行号和日志格式会因代码与工具链而不同。如果没有触发越界,程序应正常结束。若触发报告,应先定位第一处非法访问,而不是只追查后续崩溃位置,因为后面的异常常常只是前一次内存破坏的结果。
修复时从两端核对
真正可靠的修复需要同时回答两个问题:索引是否在合法范围内,以及当前对象的容量是否就是代码认为的那个容量。对固定数组可由 sizeof 推导元素数;对动态内存则应显式保存容量,并在每次写入前比较。
对于长度为 N 的数组,循环通常写成 i < N。一旦看到 i <= N、buffer[len] = ...、指针连续递增却没有剩余容量检查,就应优先怀疑越界。越界错误的修复目标不是“让程序不崩”,而是保证每一次读写都发生在所属对象的有效范围内。