
C / C++ / 系统课时
动态二维数组怎样分配
动态二维数组怎样分配
动态二维数据常见于运行时才知道行列数的表格、图像和矩阵。C 语言没有一个专门的“动态二维数组”对象,通常用连续单块内存或“行指针数组 + 每行一块内存”来组织。本节用同一组数据比较两种布局、访问方式和释放顺序。
学习目标
- 用连续单块和逐行分配两种方式创建二维数据
- 根据内存布局选择正确的下标计算与释放方式
- 判断何时更看重连续性,何时需要每行独立分配
两种布局解决的是不同需求
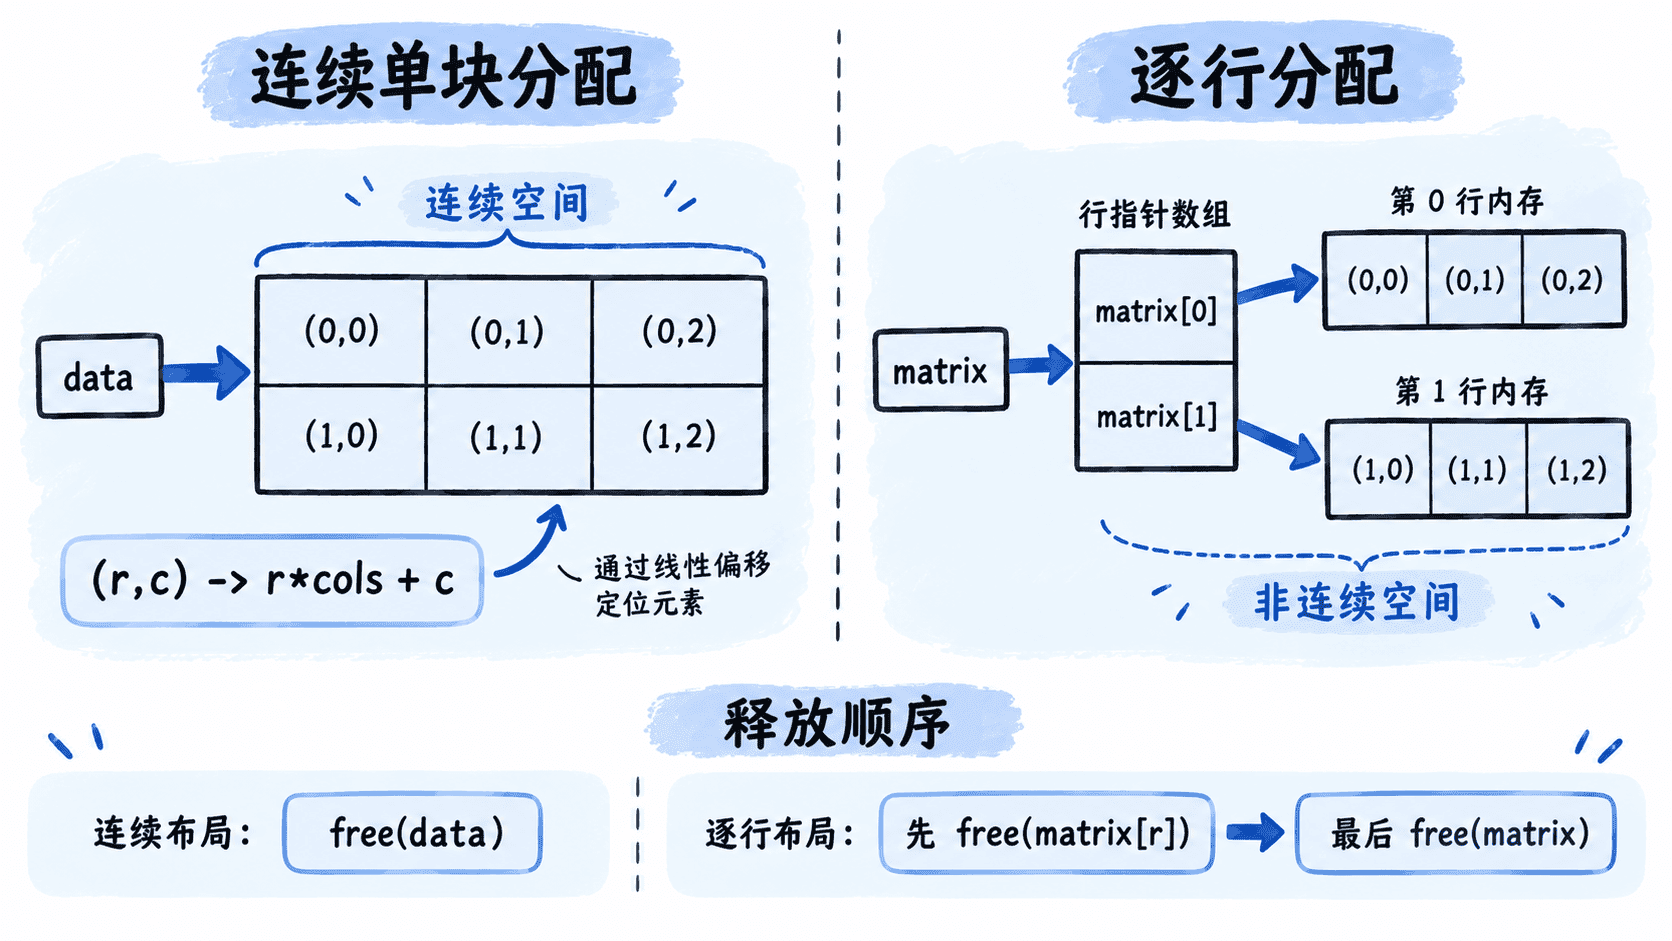
连续分配把全部元素放在一块动态内存中。若矩阵有 rows 行、cols 列,元素 (r, c) 的线性下标是 r * cols + c。它只需要一次主体分配和一次释放,内存局部性也较好。
逐行分配先创建一个 int * 指针数组,再为每一行单独 malloc。这样可以直接写 matrix[r][c],还可以让各行长度不同,但分配次数更多,释放时也必须逐行处理。
用同一程序比较两种实现
下面创建 2 × 3 的整数矩阵,分别按连续布局和逐行布局写入 1 到 6,再打印结果。逐行版本包含部分分配失败时的清理逻辑,这是实际代码不能省略的边界。
#include <stdio.h>
#include <stdlib.h>

static void print_flat(const int *data, size_t rows, size_t cols) {
    for (size_t r = 0; r < rows; ++r) {
        for (size_t c = 0; c < cols; ++c) {
            printf("%d%c", data[r * cols + c], c + 1 == cols ? '\n' : ' ');
        }
    }
}

static void print_rows(int *const *matrix, size_t rows, size_t cols) {
    for (size_t r = 0; r < rows; ++r) {
        for (size_t c = 0; c < cols; ++c) {
            printf("%d%c", matrix[r][c], c + 1 == cols ? '\n' : ' ');
        }
    }
}

int main(void) {
    const size_t rows = 2;
    const size_t cols = 3;

    /* 方案一:全部元素位于同一块连续内存。 */
    int *flat = malloc(rows * cols * sizeof *flat);
    if (flat == NULL) {
        return 1;
    }

    for (size_t i = 0; i < rows * cols; ++i) {
        flat[i] = (int)i + 1;
    }

    printf("contiguous:\n");
    print_flat(flat, rows, cols);

    /* 方案二:先分配行指针,再逐行分配元素。 */
    int **matrix = malloc(rows * sizeof *matrix);
    if (matrix == NULL) {
        free(flat);
        return 1;
    }

    size_t allocated_rows = 0;
    for (; allocated_rows < rows; ++allocated_rows) {
        matrix[allocated_rows] = malloc(cols * sizeof *matrix[allocated_rows]);
        if (matrix[allocated_rows] == NULL) {
            break;
        }
    }

    if (allocated_rows != rows) {
        for (size_t r = 0; r < allocated_rows; ++r) {
            free(matrix[r]);
        }
        free(matrix);
        free(flat);
        return 1;
    }

    for (size_t r = 0; r < rows; ++r) {
        for (size_t c = 0; c < cols; ++c) {
            matrix[r][c] = (int)(r * cols + c + 1);
        }
    }

    printf("row-by-row:\n");
    print_rows(matrix, rows, cols);

    for (size_t r = 0; r < rows; ++r) {
        free(matrix[r]);
    }
    free(matrix);
    free(flat);

    return 0;
}
预期输出(分配成功时):
contiguous:
1 2 3
4 5 6
row-by-row:
1 2 3
4 5 6
两种方案打印结果相同,但内存结构并不相同。连续布局中,从一个元素移动到下一个元素只是在同一块内存内前进;逐行布局中,每个 matrix[r] 都可能位于完全不同的地址。
怎样选择布局
如果每一行列数相同,而且需要频繁顺序遍历、批量复制或与要求连续缓冲区的函数交互,连续分配通常更简单。它还减少了多次 malloc 的管理成本,释放路径也只有一次 free(flat)。
如果行长度可能不同,或者某一行需要单独替换、扩容和释放,逐行分配更灵活。代价是要维护行指针数组,任何中途失败都必须释放已经成功分配的那些行,最终释放顺序也必须是“先元素行,后行指针数组”。
还要检查尺寸边界
示例中的尺寸很小,因此 rows * cols * sizeof *flat 不会溢出。若行列数来自文件、网络或用户输入,生产代码应在乘法前验证尺寸上限,避免 size_t 溢出后只分配到比预期更小的缓冲区。
动态二维数组没有唯一标准写法。固定列数、强调连续访问时优先考虑单块分配;需要每行独立生命周期或不规则行长时使用逐行分配。无论选哪一种,访问公式必须和实际布局一致,释放顺序也必须与分配结构成对。