
基础设施即代码 / 系统课时
用 Block Rescue Always 处理异常
用 Block Rescue Always 处理异常
当一组部署任务可能中途失败时,只靠单任务重试很难保证回滚与清理。本课用 block、rescue、always 把“正常执行、失败补救、必做清理”组织成一个可预测的异常处理单元。
学习目标
- 说明
block、rescue、always的执行顺序与触发条件 - 在
rescue中读取失败任务信息并执行补救动作 - 识别无法被
rescue接管的错误边界
看懂三段式执行路径
block 中的任务按顺序执行。某个任务进入 failed 状态后,该主机不再执行这个 block 中尚未开始的任务,而是进入 rescue。如果 block 全部成功,则跳过 rescue。无论前面的正常路径还是补救路径结果如何,always 都承担最后必须执行的清理或记录动作。
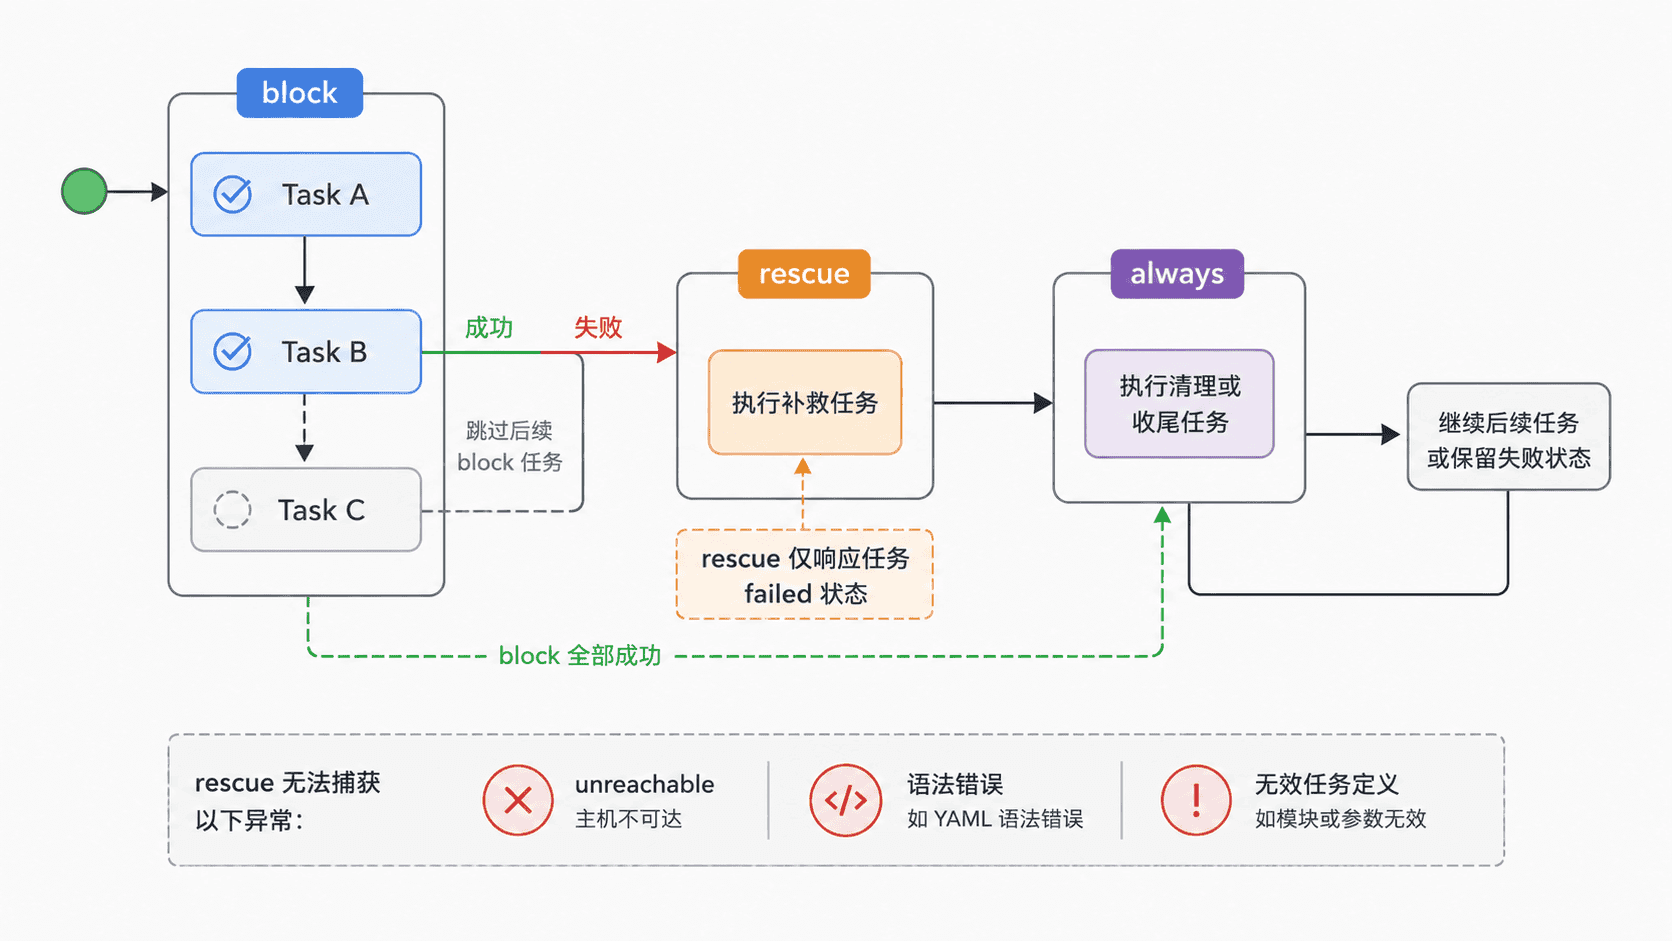
这与编程语言的异常处理相似,但不能简单等同于 try/catch/finally。Ansible 的判断单位是“某台主机上的任务结果”,所以同一个块在多台主机上可能同时走不同路径。
用可运行示例观察补救与清理
下面的 playbook 在本机创建一个临时标记,然后故意执行失败命令。失败后 rescue 读取 ansible_failed_task.name,最后由 always 删除标记。示例不修改系统服务,适合直接观察控制流。
---
- name: Demonstrate block rescue always
  hosts: localhost
  connection: local
  gather_facts: false
  vars:
    marker_path: /tmp/anystack-deploy.lock

  tasks:
    - name: Run deployment transaction
      block:
        - name: Create deployment marker
          ansible.builtin.file:
            path: "{{ marker_path }}"
            state: touch
            mode: "0600"

        - name: Simulate deployment failure
          ansible.builtin.command: /bin/false
          changed_when: false

        - name: This task is skipped after failure
          ansible.builtin.debug:
            msg: "should not run"
      rescue:
        - name: Report failed task
          ansible.builtin.debug:
            msg: "rescued={{ ansible_failed_task.name }}"
      always:
        - name: Remove deployment marker
          ansible.builtin.file:
            path: "{{ marker_path }}"
            state: absent

        - name: Confirm cleanup
          ansible.builtin.debug:
            msg: "cleanup complete"
将内容保存为 block-recovery.yml 后执行:
ansible-playbook block-recovery.yml预期结果:
触发失败:Simulate deployment failure
进入 rescue:rescued=Simulate deployment failure
执行 always:cleanup complete
最终状态:/tmp/anystack-deploy.lock 已被删除
实际终端还会包含任务状态、主机名和 play recap,格式会随 Ansible 版本与输出回调插件略有不同;应重点核对任务顺序与清理结果。
在 Rescue 中利用失败上下文
rescue 内可读取 ansible_failed_task 和 ansible_failed_result。前者用于判断失败发生在哪个任务,后者相当于捕获了该失败任务的返回结果,可用于记录返回码、错误文本或按失败类型选择不同补救动作。
如果 rescue 自身成功,原先的任务失败会被视为已救援,主机可以继续执行后续任务。需要让整个 play 仍然失败时,应在补救完成后显式使用 ansible.builtin.fail 重新抛出失败,而不是假设进入过 rescue 就一定会留下 fatal 状态。
识别不能被捕获的边界
rescue 只会在块内任务实际返回 failed 时触发。主机不可达、任务定义无效、语法解析失败等问题不属于这个可补救路径;不要把关键清理完全寄托在这类错误发生后还能进入 always。
对部署、变更或数据迁移这类多任务操作,最稳妥的设计是让 block 只包含一个业务事务范围,rescue 负责恢复该事务,always 只做幂等清理。这样失败路径既清晰,也不会把不相关任务塞进同一个异常域。