
基础设施即代码 / 系统课时
编排滚动部署与健康检查
编排滚动部署与健康检查
滚动部署的关键不是“逐台重启”,而是让每台主机都经历可验证的安全链路:先退出负载均衡,再更新并启动服务,健康检查通过后才重新接流量;任何一台失败都立即停止后续批次。
学习目标
- 使用
serial把多主机发布切成可控批次。 - 把下线流量、升级服务、健康检查和恢复流量串成一个闭环。
- 让健康检查失败的主机保持下线,并阻止后续主机继续发布。
把滚动发布拆成单机闭环
假设三台应用主机 app01、app02、app03 位于 HAProxy 后端。安全顺序应是:禁用当前节点流量 → 更新 Nginx → 重启服务 → 从节点本机检查 HTTP → 重新启用流量。只有这台主机完成闭环,Ansible 才进入下一台。
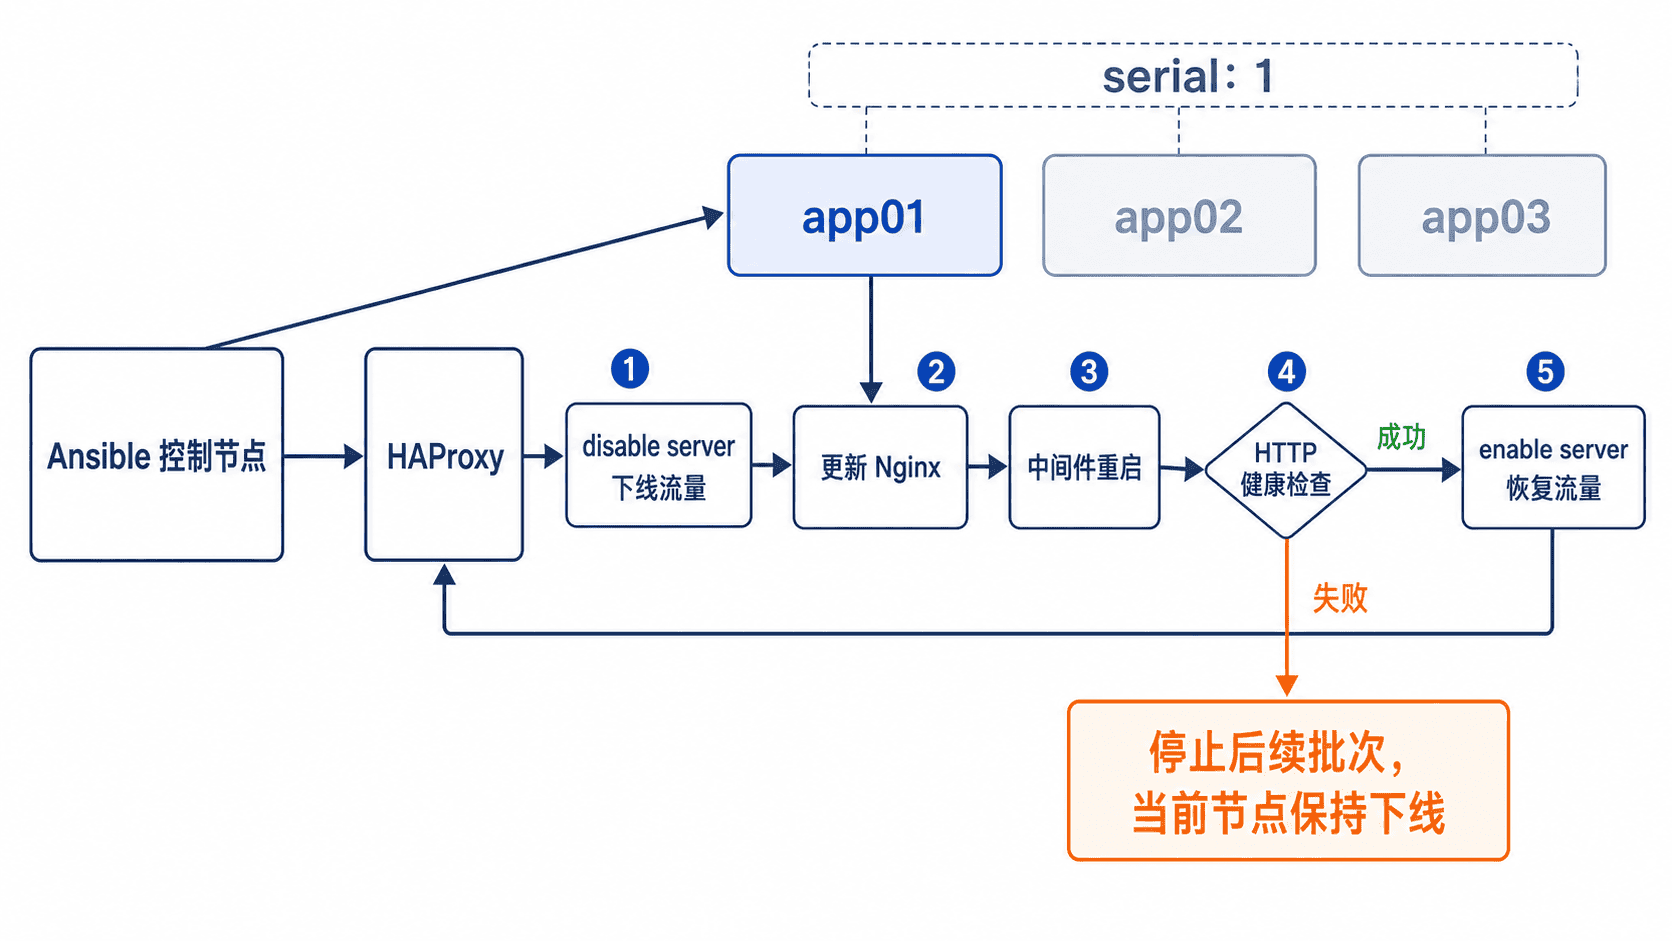
serial: 1 是这里最重要的安全边界:当前批次只有一台主机。再配合 max_fail_percentage: 0,任意一台失败都会终止剩余批次,避免故障版本继续扩散。
编写滚动部署 Playbook
下面示例假设 HAProxy 在 lb01,已开启 Runtime API Unix Socket /run/haproxy/admin.sock,后端名为 app_backend,并且三台应用主机名与 HAProxy server 名一致。lb01 需要安装 socat;应用主机使用 Debian/Ubuntu 系并提供 Nginx 默认 HTTP 页面。
[lb]
lb01 ansible_host=<IP>

[app]
app01 ansible_host=<IP>
app02 ansible_host=<IP>
app03 ansible_host=<IP>

[all:vars]
ansible_user=ops
这是清单配置,实际 <IP> 按环境替换。Playbook 只在需要系统权限的远端任务上使用提权,并把 HAProxy 操作委派给 lb01。
- name: Rolling upgrade Nginx safely
  hosts: app
  serial: 1
  max_fail_percentage: 0
  gather_facts: false

  pre_tasks:
    - name: Disable current node in HAProxy
      become: true
      ansible.builtin.command:
        argv:
          - socat
          - stdio
          - /run/haproxy/admin.sock
        stdin: "disable server app_backend/{{ inventory_hostname }}\n"
      delegate_to: lb01
      changed_when: true

  tasks:
    - name: Upgrade Nginx package
      become: true
      ansible.builtin.apt:
        name: nginx
        state: latest
        update_cache: true

    - name: Restart Nginx
      become: true
      ansible.builtin.systemd_service:
        name: nginx
        state: restarted
        enabled: true

    - name: Wait until local HTTP health check succeeds
      ansible.builtin.uri:
        url: http://127.0.0.1/
        status_code: 200
        return_content: false
      register: health
      retries: 12
      delay: 5
      until: health.status == 200

  post_tasks:
    - name: Enable healthy node in HAProxy
      become: true
      ansible.builtin.command:
        argv:
          - socat
          - stdio
          - /run/haproxy/admin.sock
        stdin: "enable server app_backend/{{ inventory_hostname }}\n"
      delegate_to: lb01
      changed_when: true
执行前可先用 --check 检查大部分配置任务,但 HAProxy Runtime API 与服务重启属于真实变更链路,最终仍应在测试环境执行一次完整发布。
ansible-playbook -i inventory.ini rolling.yml --ask-become-pass预期输出
PLAY [Rolling upgrade Nginx safely] ********************************

TASK [Disable current node in HAProxy] ******************************
changed: [app01 -> lb01]

TASK [Upgrade Nginx package] ***************************************
changed: [app01]

TASK [Restart Nginx] ***********************************************
changed: [app01]

TASK [Wait until local HTTP health check succeeds] *****************
ok: [app01]

TASK [Enable healthy node in HAProxy] *******************************
changed: [app01 -> lb01]

PLAY RECAP *********************************************************
app01 : ok=<VALUE> changed=<VALUE> unreachable=0 failed=0
app02 : ok=<VALUE> changed=<VALUE> unreachable=0 failed=0
app03 : ok=<VALUE> changed=<VALUE> unreachable=0 failed=0
<VALUE> 会随包是否真的升级、任务是否命中变更而变化;关键验收条件是三台主机都 failed=0,并且每台都是在健康检查成功之后才重新启用流量。
让失败自动阻断后续批次
健康检查任务使用 retries、delay 和 until,最多等待约 60 秒。如果状态始终不是 200,该主机会失败;因为它没有进入 post_tasks,HAProxy 中仍保持禁用,同时 max_fail_percentage: 0 使后续主机不再发布。
生产环境还应让健康检查覆盖真实依赖,而不只是进程存活。例如检查应用是否能访问数据库、消息系统或关键本地资源;但探针本身要足够快,避免因为外部抖动造成不必要的发布中断。
验收滚动发布是否安全
发布完成后,除了看 PLAY RECAP,还应检查 HAProxy 后端状态与业务探针。最重要的不是“所有任务都 changed”,而是发布期间始终保留可服务节点,失败节点不会被重新接流量,且后续批次在首个不可恢复错误处停止。
当节点数量较多时,可以把 serial 从 1 改成固定数量或百分比,但批次必须小于可承受的容量冗余。滚动发布的核心约束始终不变:先隔离流量,后变更;先验证健康,后恢复流量。