
基础设施即代码 / 系统课时
控制 Handler 的执行时机
控制 Handler 的执行时机
Handler 会把配置变化后的重启或重载延后执行。多阶段变更若必须先应用 Handler,再做健康检查或继续发布,就要用 meta: flush_handlers 主动刷新通知队列,并理解后续通知仍可再次触发同一 Handler。
学习目标
- 理解
notify只负责登记通知,Handler 默认不会在通知点立即执行。 - 使用
meta: flush_handlers在阶段边界立即运行当前已通知的 Handler。 - 识别重复通知合并、再次通知和任务失败对 Handler 时机的影响。
看懂通知队列与阶段边界
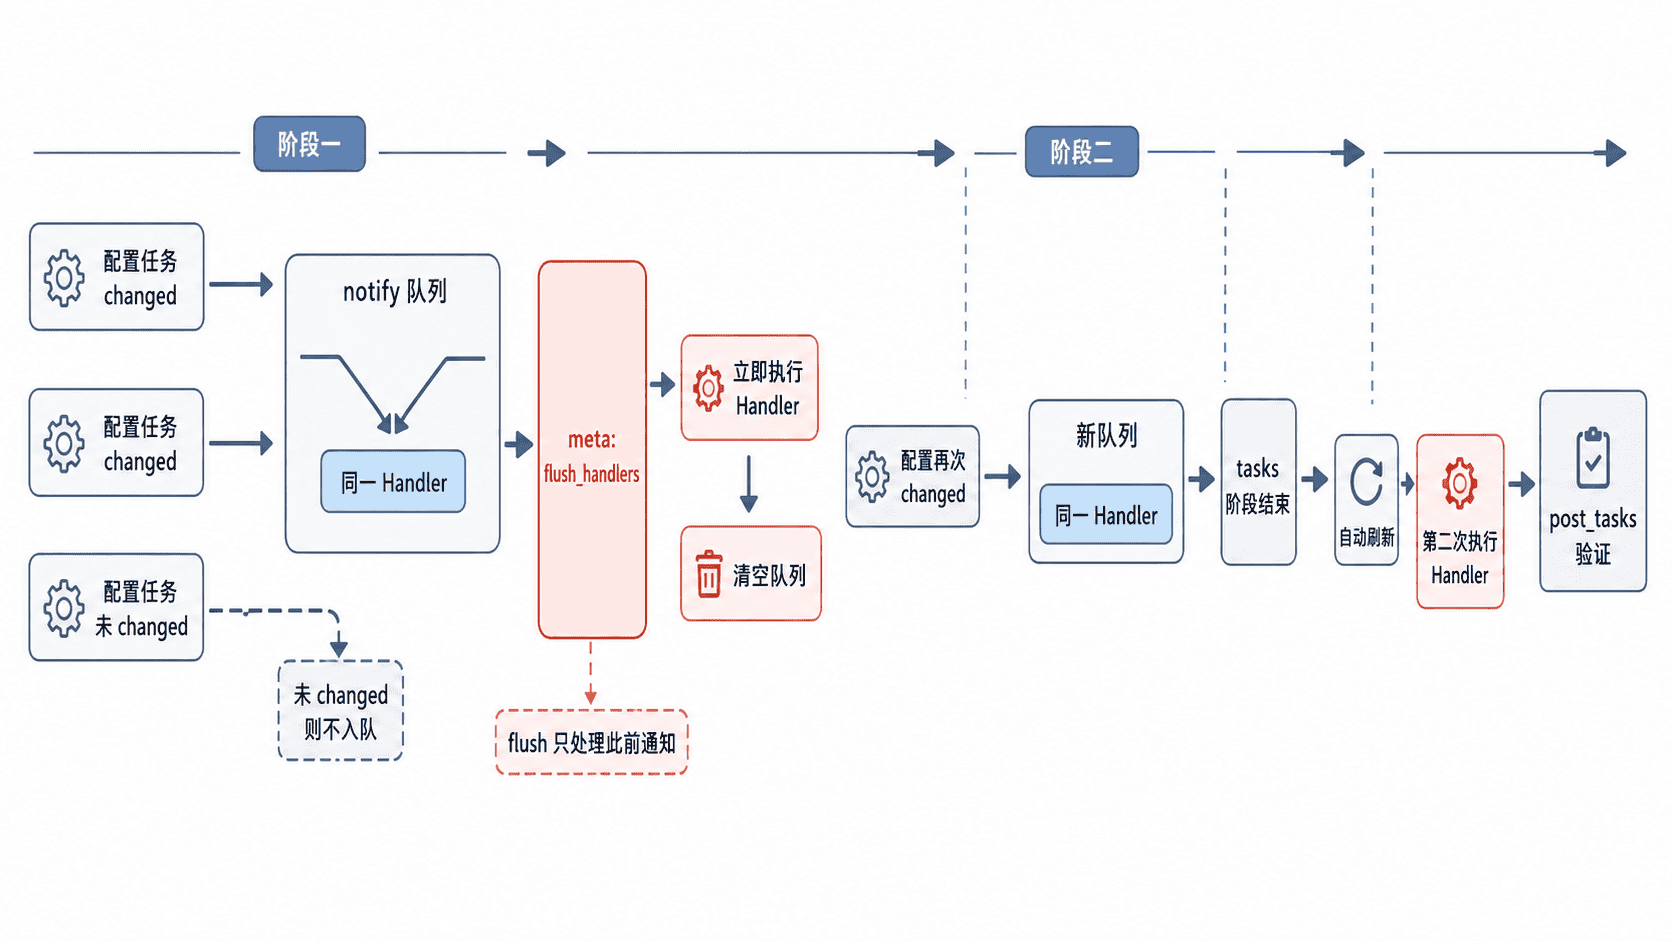
任务只有在状态为 changed 时才会触发 notify。同一个 Handler 在一次待处理队列中被多次通知,通常仍只执行一次;执行顺序按 Handler 定义顺序,而不是 notify 出现顺序。默认情况下,Ansible 会在 pre_tasks、角色或普通 tasks、post_tasks 等阶段边界刷新 Handler。
meta: flush_handlers 相当于在当前位置插入一个主动刷新点:此前已经排队的 Handler 立即执行,队列随后清空。如果后面的任务再次产生 changed 并再次通知同一个 Handler,它仍会在后续刷新点重新执行。
构造两阶段变更
下面仍用本机连接模拟两台应用主机。保存为 inventory.ini:
[app]
app01 ansible_connection=local
app02 ansible_connection=local
保存 handlers.yml。示例先修改第一阶段配置并通知 Handler,然后强制刷新;第二阶段再修改另一份配置并再次通知。Handler 用追加一行日志模拟“重载服务”,便于准确观察执行次数。
- name: 演示 Handler 的阶段化执行
  hosts: app
  gather_facts: false
  vars:
    demo_dir: "/tmp/ansible-handler-{{ inventory_hostname }}"

  tasks:
    - name: 清理演示目录
      ansible.builtin.file:
        path: "{{ demo_dir }}"
        state: absent

    - name: 创建演示目录
      ansible.builtin.file:
        path: "{{ demo_dir }}"
        state: directory
        mode: "0755"

    - name: 写入第一阶段配置
      ansible.builtin.copy:
        dest: "{{ demo_dir }}/app.conf"
        content: "version=2\n"
        mode: "0644"
      notify: reload demo service

    - name: 在健康检查前立即执行已通知的 Handler
      ansible.builtin.meta: flush_handlers

    - name: 读取第一次 Handler 执行标记
      ansible.builtin.command:
        argv:
          - /usr/bin/wc
          - -l
          - "{{ demo_dir }}/handler.log"
      register: first_count
      changed_when: false

    - name: 显示第一次执行次数
      ansible.builtin.debug:
        msg: "handler count={{ first_count.stdout.split()[0] }}"

    - name: 写入第二阶段路由配置
      ansible.builtin.copy:
        dest: "{{ demo_dir }}/route.conf"
        content: "route=enabled\n"
        mode: "0644"
      notify: reload demo service

  handlers:
    - name: reload demo service
      ansible.builtin.shell: >-
        printf 'handler-ran\n' >> "{{ demo_dir }}/handler.log"
      changed_when: true

  post_tasks:
    - name: 读取第二次 Handler 执行标记
      ansible.builtin.command:
        argv:
          - /usr/bin/wc
          - -l
          - "{{ demo_dir }}/handler.log"
      register: final_count
      changed_when: false

    - name: 显示最终执行次数
      ansible.builtin.debug:
        msg: "handler count={{ final_count.stdout.split()[0] }}"
真实服务应使用对应的 service、systemd 或应用专用模块完成重载;这里用日志追加只是为了让“执行了几次”可观察。flush_handlers 只刷新已经收到的通知,不会预先执行尚未被通知的 Handler。
运行并验证两次刷新
执行:
ansible-playbook -i inventory.ini handlers.yml预期输出应先看到一次 Handler,随后在第二阶段结束后再次看到同名 Handler,并在 post_tasks 中得到计数 2。
TASK [在健康检查前立即执行已通知的 Handler] ***

RUNNING HANDLER [reload demo service] ***
changed: [app01]
changed: [app02]

TASK [显示第一次执行次数] ***
ok: [app01] => {"msg": "handler count=1"}
ok: [app02] => {"msg": "handler count=1"}

RUNNING HANDLER [reload demo service] ***
changed: [app01]
changed: [app02]

TASK [显示最终执行次数] ***
ok: [app01] => {"msg": "handler count=2"}
ok: [app02] => {"msg": "handler count=2"}
第一次 RUNNING HANDLER 来自显式 flush_handlers;第二次来自后续任务再次 changed 后,在普通 tasks 阶段结束时自动刷新。若第二阶段配置没有变化,就不会产生第二次通知,最终计数会保持 1,这正是 Handler 保持幂等编排的重要特性。
把刷新点放在真正的依赖边界
不要因为想“尽快重启”就在每个通知后都调用 flush_handlers,否则会失去通知合并的价值,还可能让同一服务在一次发布中被反复重启。更合理的刷新点是:后续步骤确实依赖新进程状态,例如健康检查、Schema 迁移后的连接验证、切流前探活。
还要注意失败语义:主机在通知 Handler 后若后续任务失败,默认情况下该主机的待处理 Handler 可能不会继续执行。对于“即使后续失败也必须应用已完成变更”的场景,应评估 Play 级 force_handlers 或命令行 --force-handlers,同时确认失败后强制重启不会扩大故障。
Handler 的关键不是“把重启写到最后”,而是建立一条明确的变更依赖链:任务产生变化、通知进入队列、在正确阶段刷新、再验证新状态。flush_handlers 只应出现在这种依赖关系真正需要同步的边界上。