
流媒体与实时通信 / 系统课时
Opus 为什么适合实时语音
Opus 为什么适合实时语音
实时语音既要压低带宽和延迟,又要承受网络抖动、丢包以及内容从说话切到音乐的变化。Opus 的优势不是“压得最小”,而是能在一套编码器里动态调节帧长、码率、带宽和工作模式,让通话质量与实时性之间保持可控。
学习目标
- 理解帧长、码率与实时延迟、抗丢包能力之间的取舍
- 认识 Opus 在语音、音乐和混合内容之间自适应的原因
- 能在浏览器中确认 WebRTC 音频能力是否包含 Opus
Opus 解决的是实时链路的多目标取舍
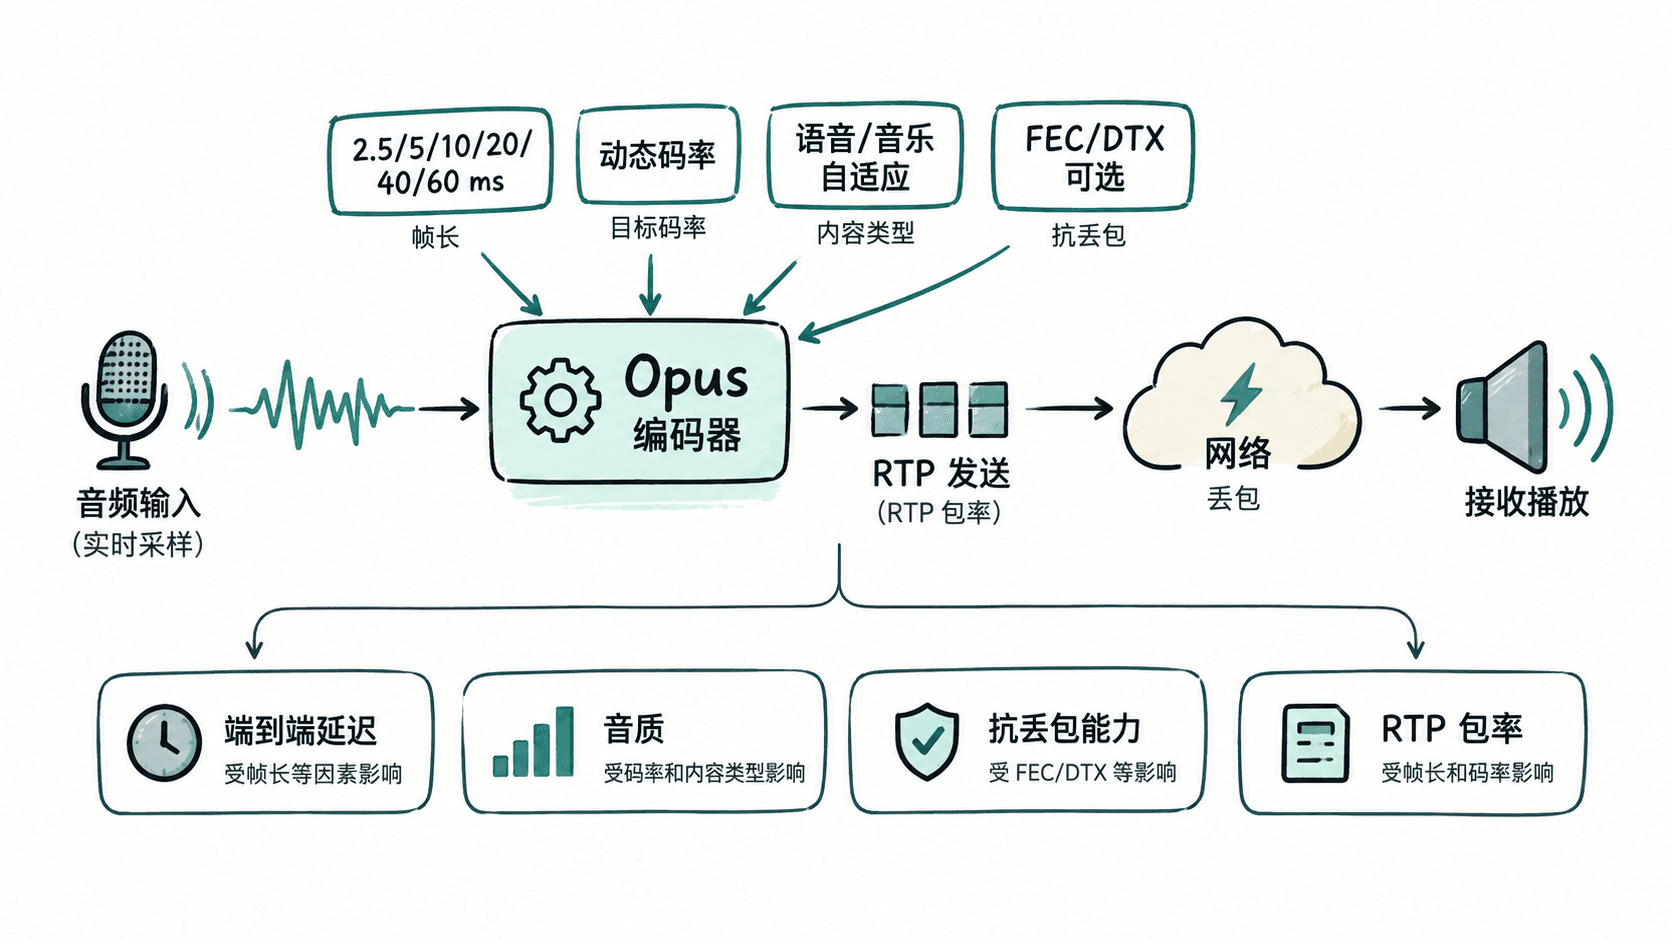
实时通信不能只追求压缩率。帧越长,通常编码效率越高、包头开销越低,但必须先积累更多采样才能编码,而且一旦丢包会一次损失更长的音频。帧越短,交互延迟和单包损失范围更小,却会增加每秒 RTP 包数量与协议开销。
Opus 原生支持 2.5、5、10、20、40、60 ms 编码帧,还可以在一个 RTP 包中组合多个帧。实时语音常把 20 ms 作为很实用的起点:每秒约 50 个编码帧,延迟、包率和编码效率较均衡。需要极低时延时可以尝试更短帧,但要接受更高包率和 CPU、网络开销。
码率不是越高越适合通话
Opus 支持很宽的码率范围,并允许在会话过程中动态调整。以 20 ms 帧为例,宽带语音常能在较低码率获得良好可懂度,而全带宽音乐通常需要更高码率。工程上更重要的是根据网络预算和内容选择目标区间,而不是固定追求某个“最佳值”。
同样平均码率下,VBR 通常能把更多比特分配给复杂片段,因此语音通信里更常见。CBR 的价值主要在带宽必须更可预测的场景。码率过低时,首先丢失的是细节与自然度;码率过高则可能在拥塞链路上制造更多排队和丢包,最终反而恶化实时体验。
语音和音乐不需要切换两套编解码器
Opus 内部结合了更偏语音建模的 SILK 与更适合高质量音频的 CELT 思路,并能根据内容、码率和带宽条件选择或组合工作模式。应用层通常不需要在“语音编码器”和“音乐编码器”之间手工切换,也不需要因为说话者突然播放音乐就重新协商整个会话。
这也是它很适合 WebRTC 的原因:通话内容、可用带宽和网络状态会持续变化,而编码器可以在当前流内调整。对实时系统来说,减少重建媒体链路和重新协商的次数,比单次静态编码效率更有价值。
在浏览器里确认 Opus 能力
现代 WebRTC 实现通常会在音频 RTP 能力中暴露 Opus。下面代码可直接粘贴到支持 WebRTC 的浏览器开发者工具控制台,用标准 API 检查发送端能力。
const codecs = RTCRtpSender.getCapabilities("audio")?.codecs ?? [];
const opus = codecs.find(
  (codec) => codec.mimeType.toLowerCase() === "audio/opus"
);

console.log(Boolean(opus));

if (opus) {
  console.log(opus.mimeType, opus.clockRate, opus.channels);
}
预期输出
true
audio/opus 48000 2
这里的 48000 是 RTP 时钟频率;它不等于“应用必须把所有原始音频都先固定成 48 kHz 才能工作”。Opus 在 RTP 中按 48 kHz 时钟推进时间戳,而编码器本身可以处理不同音频带宽。channels 为 2 是 Opus 在 SDP/RTP 映射中的标准声明方式,并不代表实际发送内容一定是立体声。
什么时候该调帧长与码率
如果目标是普通语音通话,可以从 20 ms 帧和适中的语音码率开始,再依据实际网络统计调整。网络稳定但延迟预算严格时,优先评估更短帧;弱网或移动网络下,应先控制总发送码率,并结合 WebRTC 的拥塞控制、抖动缓冲和丢包恢复机制一起观察,而不是只改编码器。
当业务包含高质量音乐、乐器或共享系统声音时,需要提高码率并确认立体声、全带宽等协商结果。Opus 的价值就在于这些场景仍可使用同一种 RTP 音频格式,再通过参数和运行时自适应完成取舍,而不是为每类声音重新设计一条媒体链路。