
流媒体与实时通信 / 系统课时
实时语音最值得监控哪些指标
实时语音最值得监控哪些指标
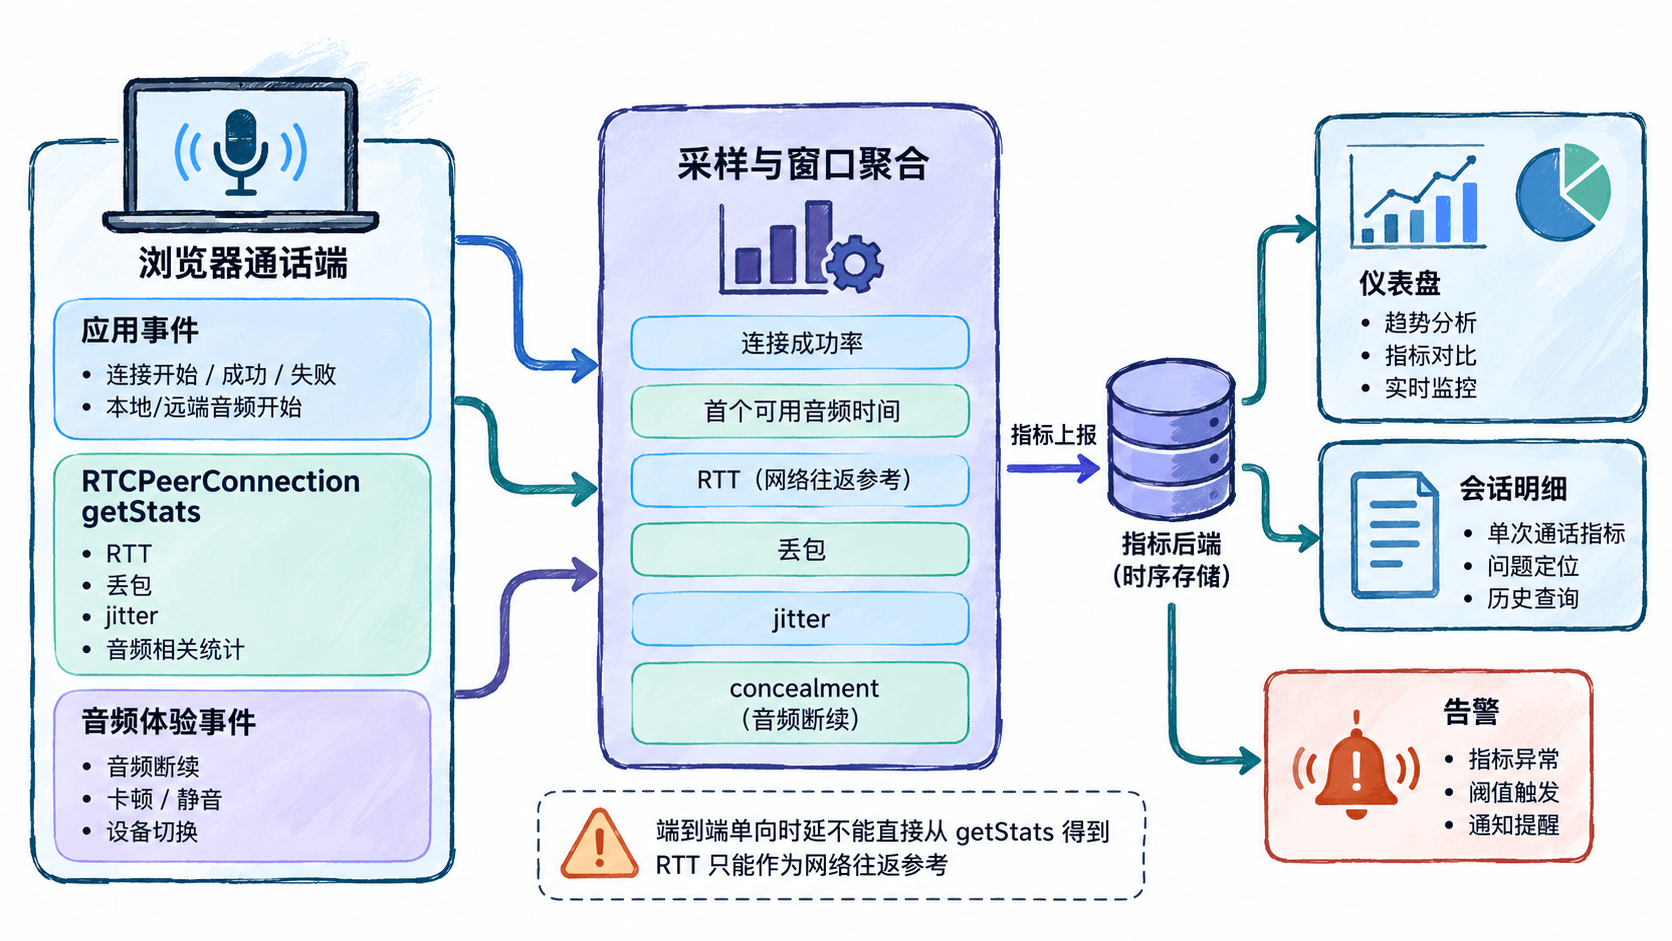
实时语音出问题时,只看“连接成功”远远不够。最小可用的观测体系应同时覆盖建连结果、网络质量和实际听感,并明确哪些指标来自 WebRTC getStats(),哪些必须由应用自己打点。
学习目标
- 建立连接、传输和听感三个层次的核心指标
- 从
RTCPeerConnection.getStats()读取 RTT、丢包、抖动和音频隐藏事件 - 避免把 RTT、平均值或单次采样误当成真实端到端体验
先把指标分成三个层次
同一个“通话失败”可能来自完全不同的阶段。建议先定义清楚分母和时间点,再做聚合,否则成功率和时延数据会互相矛盾。
| 层次 | 建议指标 | 主要来源 | 说明 |
|---|---|---|---|
| 建连 | 连接成功率、ICE 失败率、首个可用音频时间 | 应用事件 + WebRTC 状态 | 成功率必须固定“发起通话”还是“进入连接流程”为分母 |
| 传输 | RTT、接收丢包、抖动、抖动缓冲 | getStats() |
适合按会话和时间窗口计算变化量 |
| 听感 | 隐藏样本、隐藏事件、长静音或断续次数 | getStats() + 音频业务打点 |
比单纯网络丢包更接近用户实际听到的问题 |
从 getStats 读取传输与音频统计
下面是片段示例,依赖当前通话中已经存在的 RTCPeerConnection 实例 pc。代码优先通过 transport.selectedCandidatePairId 找到当前候选对,再读取入站音频统计。
async function collectAudioMetrics(pc) {
  const stats = await pc.getStats();
  let inboundAudio = null;
  let selectedPair = null;

  for (const report of stats.values()) {
    if (report.type === "inbound-rtp" && report.kind === "audio") {
      inboundAudio = report;
    }

    if (report.type === "transport" && report.selectedCandidatePairId) {
      selectedPair = stats.get(report.selectedCandidatePairId) ?? selectedPair;
    }
  }

  // 个别实现没有暴露 selectedCandidatePairId 时,退回到已提名且成功的候选对。
  if (!selectedPair) {
    for (const report of stats.values()) {
      if (
        report.type === "candidate-pair" &&
        report.state === "succeeded" &&
        report.nominated
      ) {
        selectedPair = report;
        break;
      }
    }
  }

  return {
    rttMs: selectedPair?.currentRoundTripTime != null
      ? Math.round(selectedPair.currentRoundTripTime * 1000)
      : null,
    packetsReceived: inboundAudio?.packetsReceived ?? null,
    packetsLost: inboundAudio?.packetsLost ?? null,
    jitterMs: inboundAudio?.jitter != null
      ? Math.round(inboundAudio.jitter * 1000)
      : null,
    concealmentEvents: inboundAudio?.concealmentEvents ?? null
  };
}

collectAudioMetrics(pc)
  .then(metrics => console.log(JSON.stringify(metrics, null, 2)))
  .catch(console.error);
预期输出
{
  "rttMs": <RTT_MS>,
  "packetsReceived": <COUNT>,
  "packetsLost": <COUNT>,
  "jitterMs": <JITTER_MS>,
  "concealmentEvents": <COUNT_OR_NULL>
}
实际数值会随网络和浏览器实现变化;不支持某个统计项时应保留 null,不要把缺失值当成 0。
两类关键指标不能只靠 getStats
“首个可用音频时间”通常需要应用自己记录时间点,例如从用户点击呼叫、远端接受或进入连接阶段开始,到首次确认远端音频已经可播放为止。团队必须统一起点和终点,否则不同客户端的数据无法比较。
端到端单向时延也没有一个通用的 getStats() 字段可以直接读取。currentRoundTripTime 表示当前网络候选对的往返时间,它不包含完整的采集、编码、抖动缓冲、解码和播放链路,因此不要简单用 RTT 除以 2 当作精确的一端到另一端延迟。
用时间窗口而不是单点值判断异常
packetsLost、packetsReceived 和隐藏事件都更适合比较相邻采样的增量。例如一个 5 秒窗口内,可以用“丢失增量 ÷(丢失增量 + 接收增量)”得到该窗口的接收侧丢包率;直接拿会话累计值做告警,会让早期抖动长期污染后续判断。
告警也不要只依赖一个阈值。更稳妥的是组合条件,例如连续多个窗口出现高丢包或高抖动,同时 concealmentEvents 持续增加,再把该会话标记为音频质量异常。阈值应从自己的设备、地区和网络基线校准,而不是照搬通用数字。
一套最小监控至少能回答什么
上线前应确保每个会话都能回答几个问题:是否成功建立、多久出现可用音频、网络是否持续丢包或抖动、浏览器是否频繁进行音频隐藏、异常发生在哪个时间窗口。聚合层再看成功率、P50/P95 时延和异常会话占比,而不是只看全局平均值。
这样设计后,连接问题、网络问题和真实听感问题会落在不同证据链上。排障时可以先定位层次,再下钻到具体会话的原始统计,避免用一个“平均延迟”解释所有语音故障。