
流媒体与实时通信 / 系统课时
丢包后声音为什么会断
丢包后声音为什么会断
音频包一旦在网络中丢失,接收端就会在原本连续的媒体时间轴上遇到空洞。真正决定“会不会听见断音”的,不只是丢了几个包,还包括乱序等待时间、播放截止时间以及 PLC、FEC 或重传能否在截止前补上缺失音频。
学习目标
- 区分真正丢包与 RTP 包乱序
- 理解 jitter buffer、PLC、FEC 和重传各自解决什么问题
- 能沿着“序列号缺口到听感”的链路定位断音原因
先判断缺的是包还是顺序
RTP sequence number 每发一个包递增一次,因此接收端看到 100、102、101 时,不能在 102 到达的瞬间就断定 101 已经丢失。网络可能只是让 102 先到了。jitter buffer 会在有限时间内等待并重排序,只有缺失包超过可等待的播放截止时间,才需要进入恢复或隐藏路径。
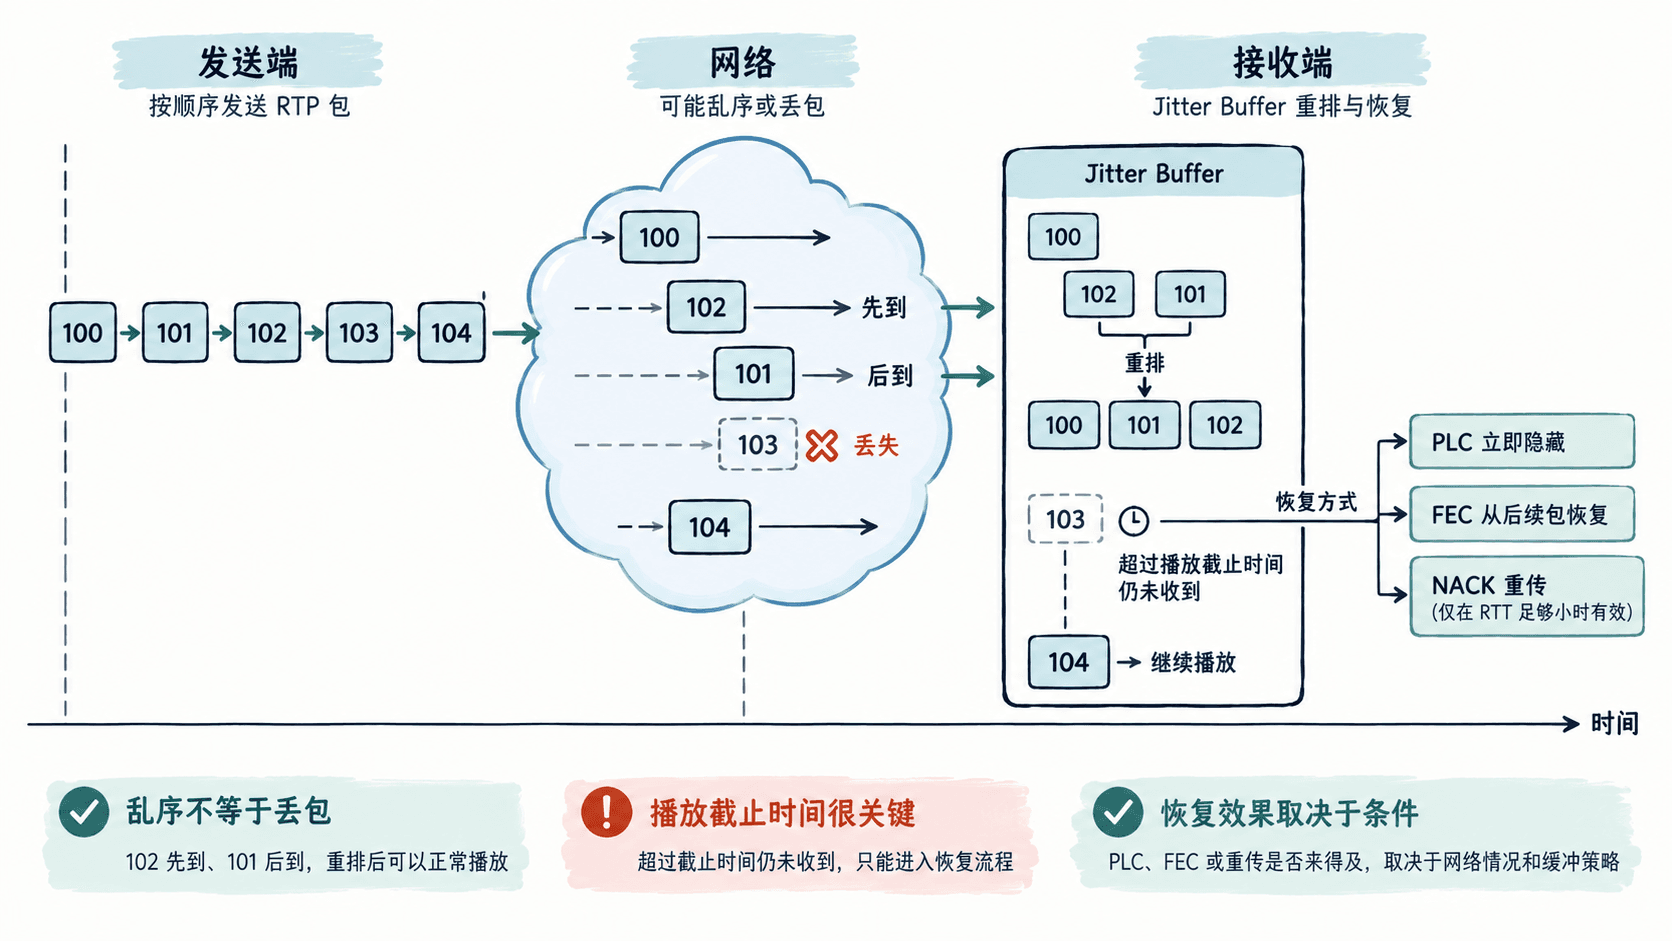
抖动缓冲先吸收乱序
下面的可运行示例不是 WebRTC 源码,而是一个最小模型:先把乱序包放进缓冲区,只要期望的序列号已经到达就连续取出;当 103 到播放截止时间仍缺失时,用 PLC 代表“生成一帧隐藏音频”,然后继续播放后面的 104。
arrivals = [
    (100, "A"),
    (102, "C"),
    (101, "B"),
    (104, "E"),
]

expected = 100
buffer = {}
played = []

for seq, payload in arrivals:
    buffer[seq] = payload
    while expected in buffer:
        played.append((expected, buffer.pop(expected)))
        expected += 1

# 模拟 seq=103 已到播放截止时间,不能继续等待。
played.append((expected, "PLC"))
expected += 1

while expected in buffer:
    played.append((expected, buffer.pop(expected)))
    expected += 1

print(played)
print(f"buffer_left={buffer}")
预期输出
[(100, 'A'), (101, 'B'), (102, 'C'), (103, 'PLC'), (104, 'E')]
buffer_left={}这个模型说明了两个关键点:102 早到不会直接造成断音,因为 101 仍可在缓冲窗口内补回;真正棘手的是 103 超过播放截止时间仍然缺失,此时接收端必须在“继续等”和“按时播”之间做取舍。
缺失帧怎样被补救
PLC(Packet Loss Concealment)不恢复原始比特,而是根据前后音频估计一个可听上更平滑的替代帧。连续丢包越多,可利用的上下文越少,PLC 越容易从“轻微音质变化”退化成明显断裂或静音。
FEC 的目标是让后续数据携带足以恢复前面缺失音频的信息。以 Opus in-band FEC 为例,接收端通常需要等待后一个包才能尝试恢复前一帧,所以会增加一点等待需求;如果 jitter buffer 太紧,即使网络传来了可恢复信息,也可能错过播放截止时间。
NACK/重传则受 RTT 约束。音频是实时媒体,缺失包即使最终重传成功,只要到达时播放时刻已经过去,价值也很低。因此“重传成功”不等于“听感已经修复”。
为什么连续丢包更容易听见
单个短帧丢失时,PLC 往往可以把波形过渡做得比较自然;连续多帧丢失会同时拉长媒体空洞,并削弱恢复算法的参考信息。若丢包同时伴随较大网络抖动,jitter buffer 还可能频繁扩张或收缩,听感就会从偶发瑕疵变成卡顿、断续甚至明显静音。
排查断音时可按顺序判断:先看 sequence number 是否有真实缺口,再看缺包是否在缓冲窗口内晚到;确认确实缺失后,再检查 PLC/FEC 是否启用且来得及生效,最后再评估 RTT 是否让重传仍有意义。这样可以把“网络丢包”“缓冲太小”和“恢复机制没有赶上截止时间”分开处理。