
流媒体与实时通信 / 系统课时
怎样区分客户端和网络故障
怎样区分客户端和网络故障
语音卡顿、单向无声或连接失败并不等于“网络差”。可靠判断要把客户端运行状态、浏览器 Stats、服务端信令记录放在同一时间窗中比较,先确认故障发生在哪一层,再决定由客户端、网络还是服务端继续排查。
学习目标
- 建立客户端、媒体网络与信令服务三层证据边界
- 用 Stats 指标和系统日志判断故障更接近哪一侧
- 避免把单个丢包率、错误码或 ICE 状态当成最终结论
先按证据来源划分责任层
客户端证据回答“设备和应用是否正常工作”,例如麦克风权限、采集线程、音频设备切换、CPU 卡顿和页面生命周期。网络证据主要来自 WebRTC Stats 与 ICE 状态,包括候选对、RTT、抖动、丢包和收发字节变化。服务端证据则关注信令请求、会话状态、鉴权、SDP 交换和候选转发是否按预期完成。
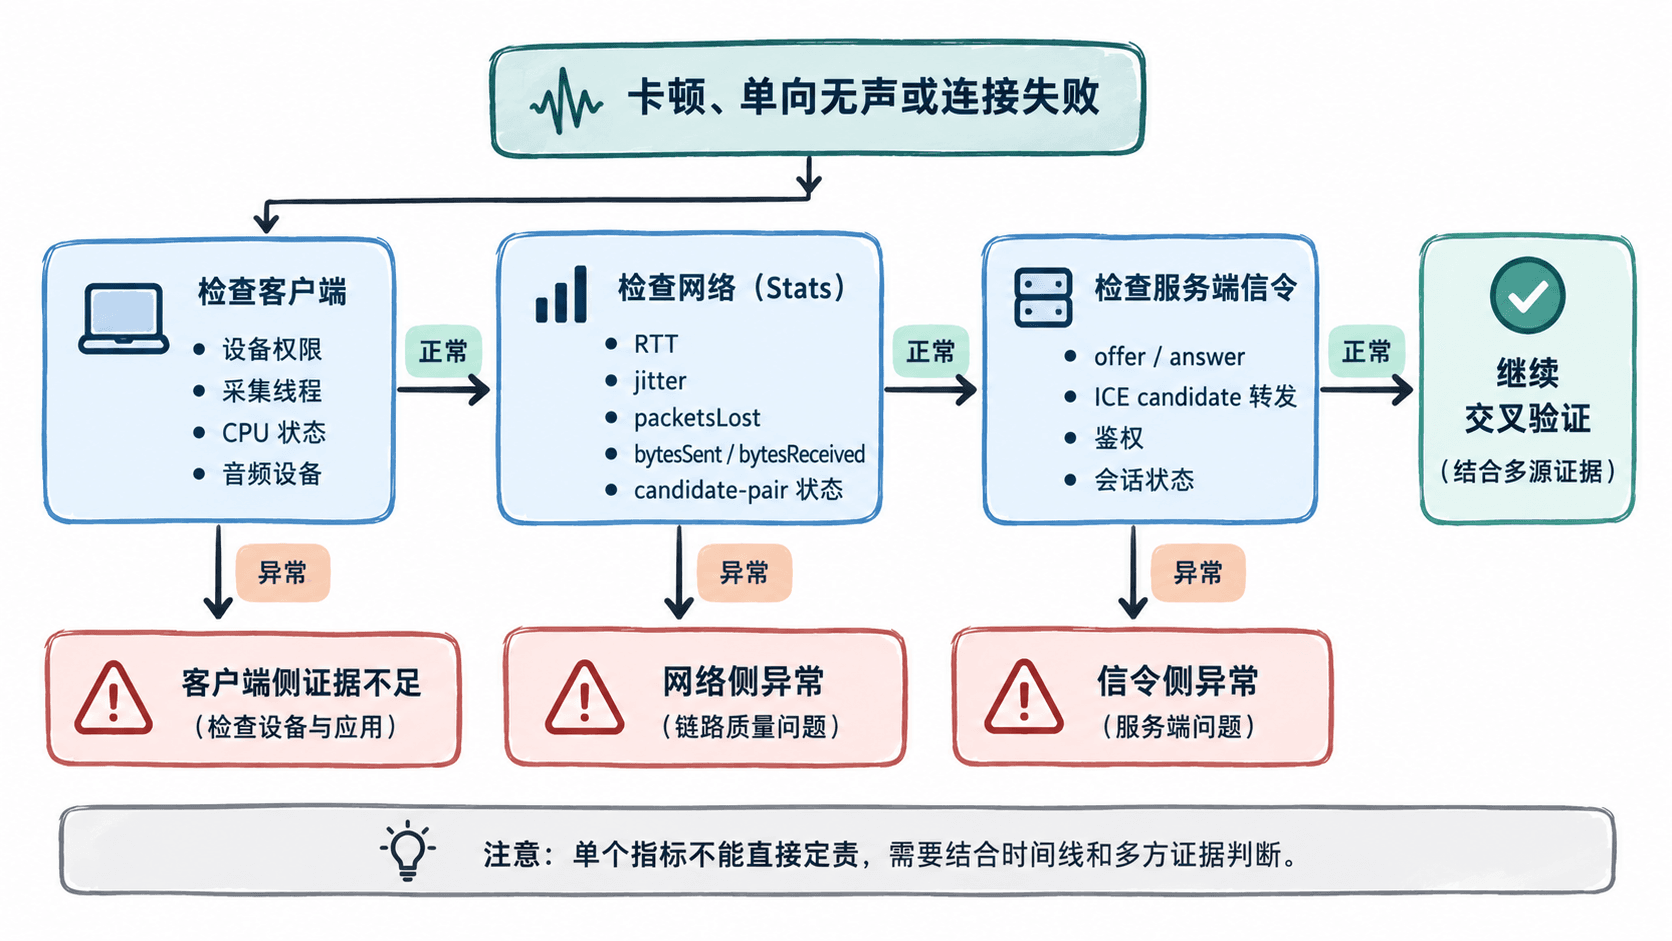
按固定顺序排除,而不是看到指标就下结论
先确认本地是否真的在采集和发送音频:设备权限正常、track 未结束、应用没有被系统挂起。随后查看 getStats() 对应的 RTP 与 candidate-pair 指标,判断是否存在高 RTT、持续丢包、抖动上升或字节计数停止。最后再把这些时间点与服务端信令日志对齐,确认协商是否成功、候选是否完整转发。
用一个最小分类器验证排障思路
下面示例把已经采集好的指标归一化为一个判断结果。阈值只是团队自己的告警策略,不是 WebRTC 标准值;生产环境应根据设备、网络和业务基线调整。保存为 classify.js 后可直接用 Node.js 运行。
const sample = {
  client: {
    micPermission: true,
    audioThreadBlocked: false
  },
  network: {
    packetLossPct: 8.2,
    rttMs: 420,
    jitterMs: 73,
    candidatePairState: "succeeded"
  },
  signaling: {
    offerAccepted: true,
    answerReceived: true,
    candidateForwardingErrors: 0
  }
};

function classify(s) {
  if (!s.client.micPermission || s.client.audioThreadBlocked) {
    return "client";
  }

  if (
    s.network.candidatePairState !== "succeeded" ||
    s.network.packetLossPct >= 5 ||
    s.network.rttMs >= 300 ||
    s.network.jitterMs >= 50
  ) {
    return "network";
  }

  if (
    !s.signaling.offerAccepted ||
    !s.signaling.answerReceived ||
    s.signaling.candidateForwardingErrors > 0
  ) {
    return "signaling";
  }

  return "uncertain";
}

console.log(
  `${classify(sample)}: loss=${sample.network.packetLossPct}%, ` +
  `rtt=${sample.network.rttMs}ms, jitter=${sample.network.jitterMs}ms`
);
预期输出
network: loss=8.2%, rtt=420ms, jitter=73ms这个结果只说明“当前证据更集中在网络层”。若同一时间客户端日志出现音频线程长时间阻塞,就不能仅凭这段输出把责任归给外部网络。
看方向,才能避免常见误判
上行异常时,应优先比较本端 outbound-rtp、远端反馈以及发送字节是否持续增长;下行异常则重点看 inbound-rtp 的接收、丢包和抖动。ICE 已连接但音频仍然卡顿,说明“能建立路径”和“路径质量稳定”是两件事;信令 HTTP 成功也只证明控制面可用,不代表媒体路径没有问题。
服务端同样可能造成看似网络的问题,例如候选转发延迟、会话状态提前清理或 TURN 配置错误。因此责任边界应以多源证据交叉确认,而不是只看客户端错误提示。
用同一时间窗形成可复核证据
排障时至少保留三组时间:客户端事件时间、Stats 采样时间、服务端信令时间。它们都应带相同 session_id 和 peer_id,并尽量使用可比较的时钟来源。最终结论应能指出“异常从哪一秒开始、哪组指标先变化、另一层是否同时出现错误”。
只要每次定责都能回到同一会话、同一方向和同一时间窗,团队就能把“感觉像网络问题”变成可验证的边界判断,也更容易决定下一步该抓客户端日志、网络数据还是服务端信令。