
单片机与物联网 / 系统课时
处理串口缓冲区与连续数据
处理串口缓冲区与连续数据
连续发送时,一次读取不一定恰好得到一帧完整数据;本课通过观察驱动缓冲区与应用读取长度的变化,建立“串口是字节流”的实际认识,为后续按帧解析打基础。
学习目标
- 能区分发送、驱动缓冲和应用读取之间的关系
- 能用
in_waiting观察当前可读字节数,并理解读取长度为何变化 - 能判断连续数据为什么不能按“一次 read 就是一帧”处理
先看清数据经过了哪里
串口设备收到电气信号后,串口控制器和驱动会先把字节放入接收缓冲区,应用程序再从这个缓冲区读取。连续发送时,应用读取动作与设备发送动作是两个独立节奏,因此一次 read() 可能只拿到部分数据,也可能一次拿到多批已经到达的字节。
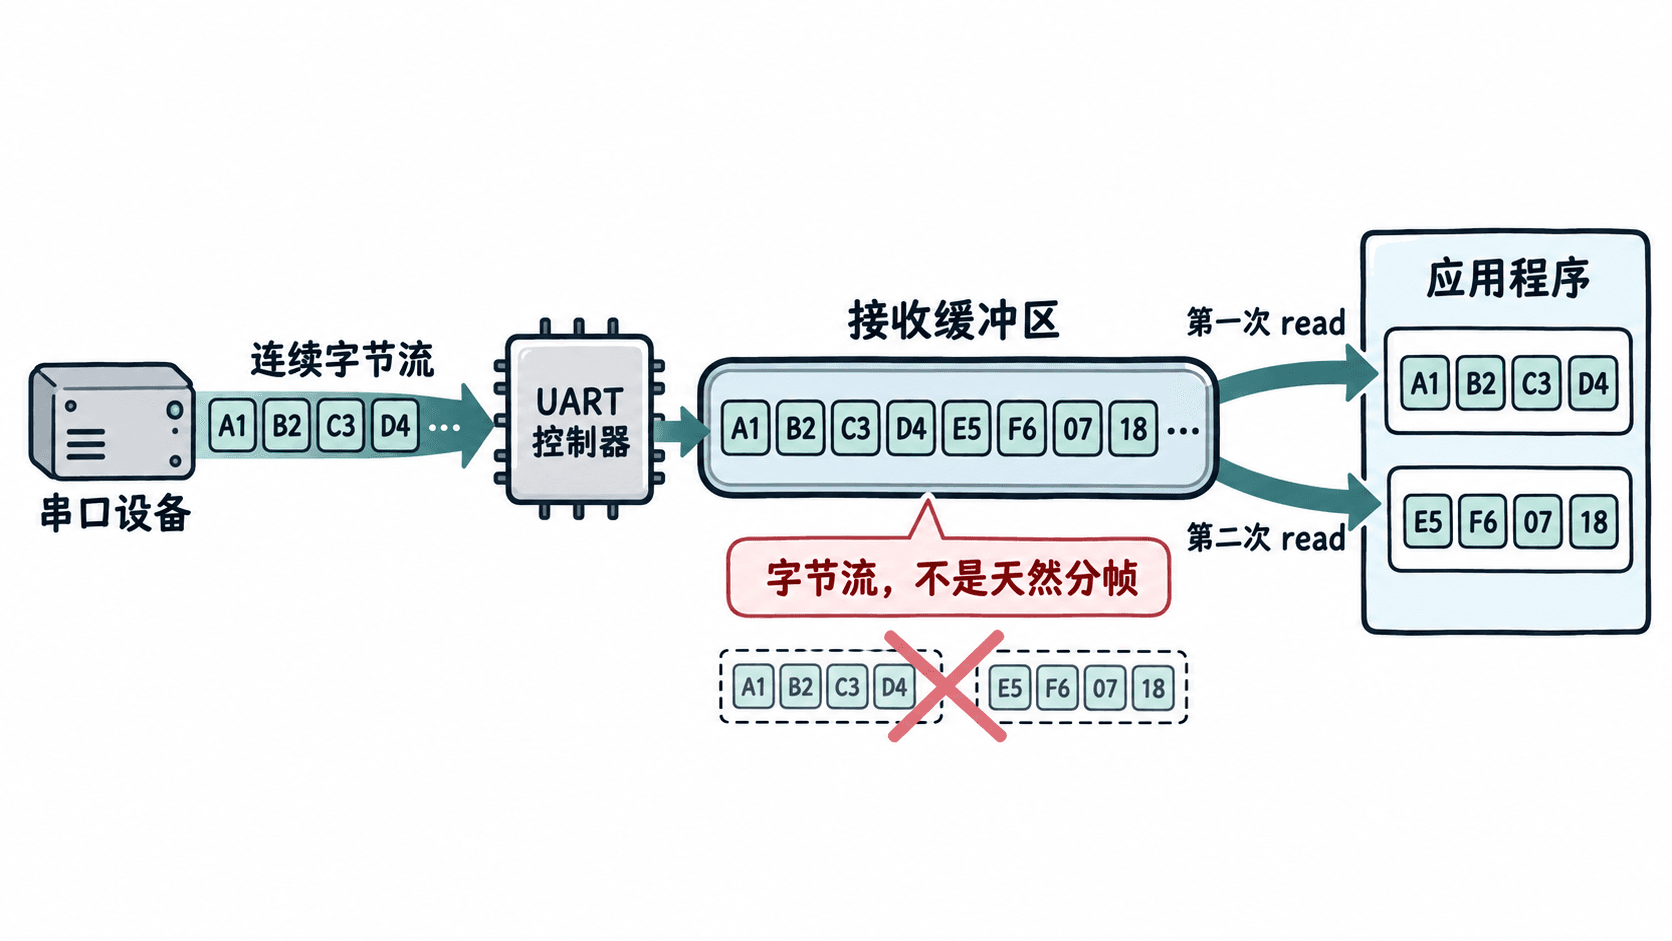
例如设备持续发送 ABCDEF,应用先读 3 字节,再过一小段时间读取剩余数据。这里的 3 和 3 只是某一次时序下的结果,不能当成协议帧长度。
观察当前缓冲区有多少字节
下面用 Python 的 pyserial 读取串口,并在每次读取前查看 in_waiting。示例假设设备连接在 <PATH>,波特率为 115200,设备会持续发送文本或字节数据。
import time
import serial

PORT = "<PATH>"
BAUDRATE = 115200

with serial.Serial(PORT, BAUDRATE, timeout=0.2) as ser:
    print(f"opened {PORT} at {BAUDRATE} baud")
    for _ in range(10):
        available = ser.in_waiting
        if available:
            data = ser.read(available)
            print(f"buffer={available}, read={len(data)}, data={data!r}")
        else:
            print("buffer=0, read=0")
        time.sleep(0.2)
预期输出
opened <PATH> at 115200 baud
buffer=6, read=6, data=b'ABCDEF'
buffer=3, read=3, data=b'GHI'
buffer=0, read=0
buffer=9, read=9, data=b'JKLMNOPQ'实际字节内容、buffer 数值和每次 read 的长度会随设备发送节奏、操作系统调度以及 timeout 设置变化;重点观察的是:当前可读长度不是固定值,读取结果也不等于协议帧边界。
为什么连续数据会被拆开
假设设备连续发送两帧:<FRAME-A> 和 <FRAME-B>。如果应用读取时第一帧还没有全部到达,第一次 read() 可能只取得前半段;如果两帧已经同时进入缓冲区,也可能一次读出两帧甚至更多数据。串口驱动负责保存已经收到的字节,但通常不会替你的业务协议判断哪里是一帧。
因此,协议解析应该建立在“读取到任意长度字节块”的假设上。常见做法是把每次 read() 得到的数据追加到应用层缓存,再根据帧头、长度字段、结束符或校验规则判断是否已经形成完整帧。
读取策略怎么选
实时协议通常会采用“已有多少读多少,再交给解析器”的方式。这样可以减少因为等待固定长度而造成的阻塞;真正的完整性判断交给上层帧解析逻辑。
对于固定长度协议,可以累计到指定长度后再解析;对于带长度字段的协议,应先读取帧头,再根据长度字段决定还需要多少字节;对于结束符协议,则持续查找结束标记。无论哪种方式,都应允许一次读取包含半帧、一帧或多帧。
实际调试时,最有价值的观察项通常是“收到多少、读走多少、缓存还剩多少”。一旦把这三个量分开,很多所谓的“串口丢包”其实会变成更明确的读取时序或帧解析问题。