
单片机与物联网 / 系统课时
用接收缓冲区持续拆帧
用接收缓冲区持续拆帧
面对串口半包、多帧连读和粘连数据,稳定做法不是猜下一次 read 会返回什么,而是维护一个持续增长的接收缓冲区:先追加新字节,再根据帧头和长度判断是否够一帧,够了就消费,剩余字节继续等待解析。
学习目标
- 能设计“追加→检查帧头→读取长度→判断完整→消费”的拆帧流程
- 能处理半包、多帧连读以及无效字节混入的情况
- 理解为什么解析后必须只移除已经确认属于完整帧的字节
把读取和拆帧分成两个职责
接收线程每次拿到一段数据,都先追加到同一个缓冲区。解析器不关心这批数据来自一次还是十次读取,只处理“当前缓冲区里已经累计了哪些连续字节”。
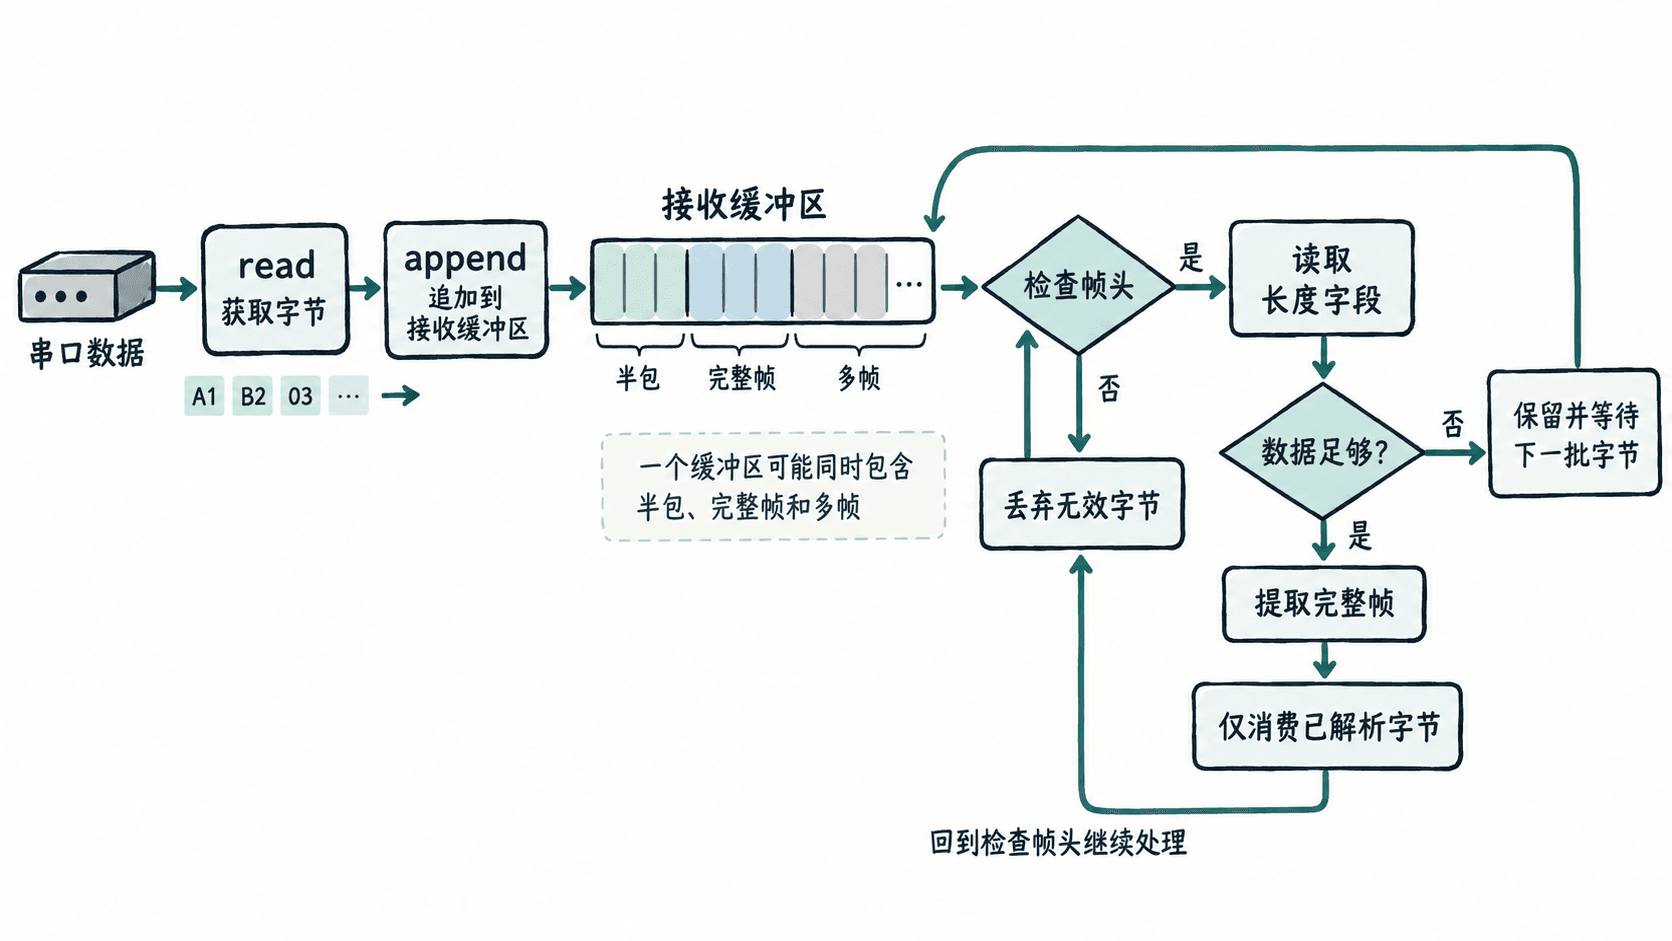
以固定协议 AA 55 + LEN + PAYLOAD 为例,其中 LEN 表示载荷长度。解析器每次循环都先确认至少拥有 3 个字节,再从长度字段计算整帧长度:frameLength = 3 + LEN。若缓冲区长度不足,就立即停止本轮解析,等待下一次读取。
一个可运行的拆帧实现
下面的 Python 示例模拟串口分批到达的数据,核心逻辑与真实串口接收线程一致。为了便于验证,示例还故意把一帧拆成两批,并让最后一批同时包含一帧和下一帧的一部分。
from collections import deque

HEADER = b"\xAA\x55"
MIN_FRAME_LEN = 3


def build_frame(payload: bytes) -> bytes:
    if len(payload) > 255:
        raise ValueError("payload too long")
    return HEADER + bytes([len(payload)]) + payload


def parse_stream(chunks: list[bytes]) -> list[bytes]:
    buffer = bytearray()
    frames: list[bytes] = []

    for chunk in chunks:
        buffer.extend(chunk)

        while True:
            start = buffer.find(HEADER)
            if start < 0:
                # 没有帧头时只保留最后一个字节,避免丢掉跨批次的半个帧头。
                if len(buffer) > len(HEADER) - 1:
                    del buffer[: len(buffer) - (len(HEADER) - 1)]
                break

            if start > 0:
                del buffer[:start]

            if len(buffer) < MIN_FRAME_LEN:
                break

            payload_len = buffer[2]
            frame_len = MIN_FRAME_LEN + payload_len
            if len(buffer) < frame_len:
                break

            frames.append(bytes(buffer[:frame_len]))
            del buffer[:frame_len]

    return frames


frames = parse_stream([
    b"\xAA\x55\x03\x10",
    b"\x20\x30\xAA\x55\x02",
    b"\x7F\x01",
])

for frame in frames:
    print(frame.hex(" "))
预期输出
AA 55 03 10 20 30
AA 55 02 7f 01
这里最关键的是 buffer 从头到尾持续存在。第一批只有半帧时不消费;第二批补齐后立即得到第一帧,同时保留第二帧的半包;第三批到来后,再从剩余字节中得到第二帧。
为什么解析后只能消费已确认的数据
假设缓冲区当前是:
AA 55 05 10 20长度字段说明整帧需要 8 个字节,但当前只有 5 个。此时不能删除这 5 个字节,因为它们仍然是未来完整帧的一部分。正确动作是保留原数据,等下一次读取追加剩余字节。
当缓冲区已经拥有完整帧时,也不能执行“全部清空”。应该只删除 [0:frameLength],然后继续检查新的缓冲区开头,因为一次读取可能已经携带下一帧。
处理错误帧头与异常长度
真实设备可能出现噪声、丢字节或协议切换,导致缓冲区开头不是 AA 55。因此解析器需要先寻找下一个合法帧头,再决定是否继续。
长度字段也不能无限信任。实际协议通常需要定义最大帧长,例如规定载荷最多 256 字节。若读到明显超出限制的长度,应该丢弃当前候选帧头并继续搜索,而不是让缓冲区永久等待一个不可能到来的超长帧。
片段示例:下面的条件应嵌入具体协议解析器,用于限制长度字段。
MAX_PAYLOAD_LEN = 256

payload_len = buffer[2]
if payload_len > MAX_PAYLOAD_LEN:
    del buffer[:2]
    continue
预期结果
当长度字段超过协议允许范围时,当前候选帧头被丢弃,解析器继续寻找后续合法帧头。这套流程为什么抗碎片
无论底层一次返回 1 字节、整帧,还是连续返回多帧,解析器看到的始终只是“缓冲区发生变化”。因此网络抖动、串口读取时机和线程调度不会直接改变协议判断结果。
实际项目里可以把这套状态继续扩展为校验和、CRC、转义字节、超时和最大帧长检查,但核心原则不变:读取层负责收集字节,解析层负责确认边界,只有完整且合法的帧才允许从缓冲区被消费。