
单片机与物联网 / 系统课时
加入轮询超时与重试控制
加入轮询超时与重试控制
多设备串口通信最容易出现的问题之一,是一个离线节点拖住整个轮询循环。本篇用请求标识、超时和有限重试组成可控的轮询器,让一个节点等待失败后仍能继续服务其他节点。
学习目标
- 理解请求、响应匹配、超时和重试之间的关系
- 实现有限次数重试,并避免单节点无限等待
- 验证离线设备不会阻塞后续节点
把一次请求划成明确状态
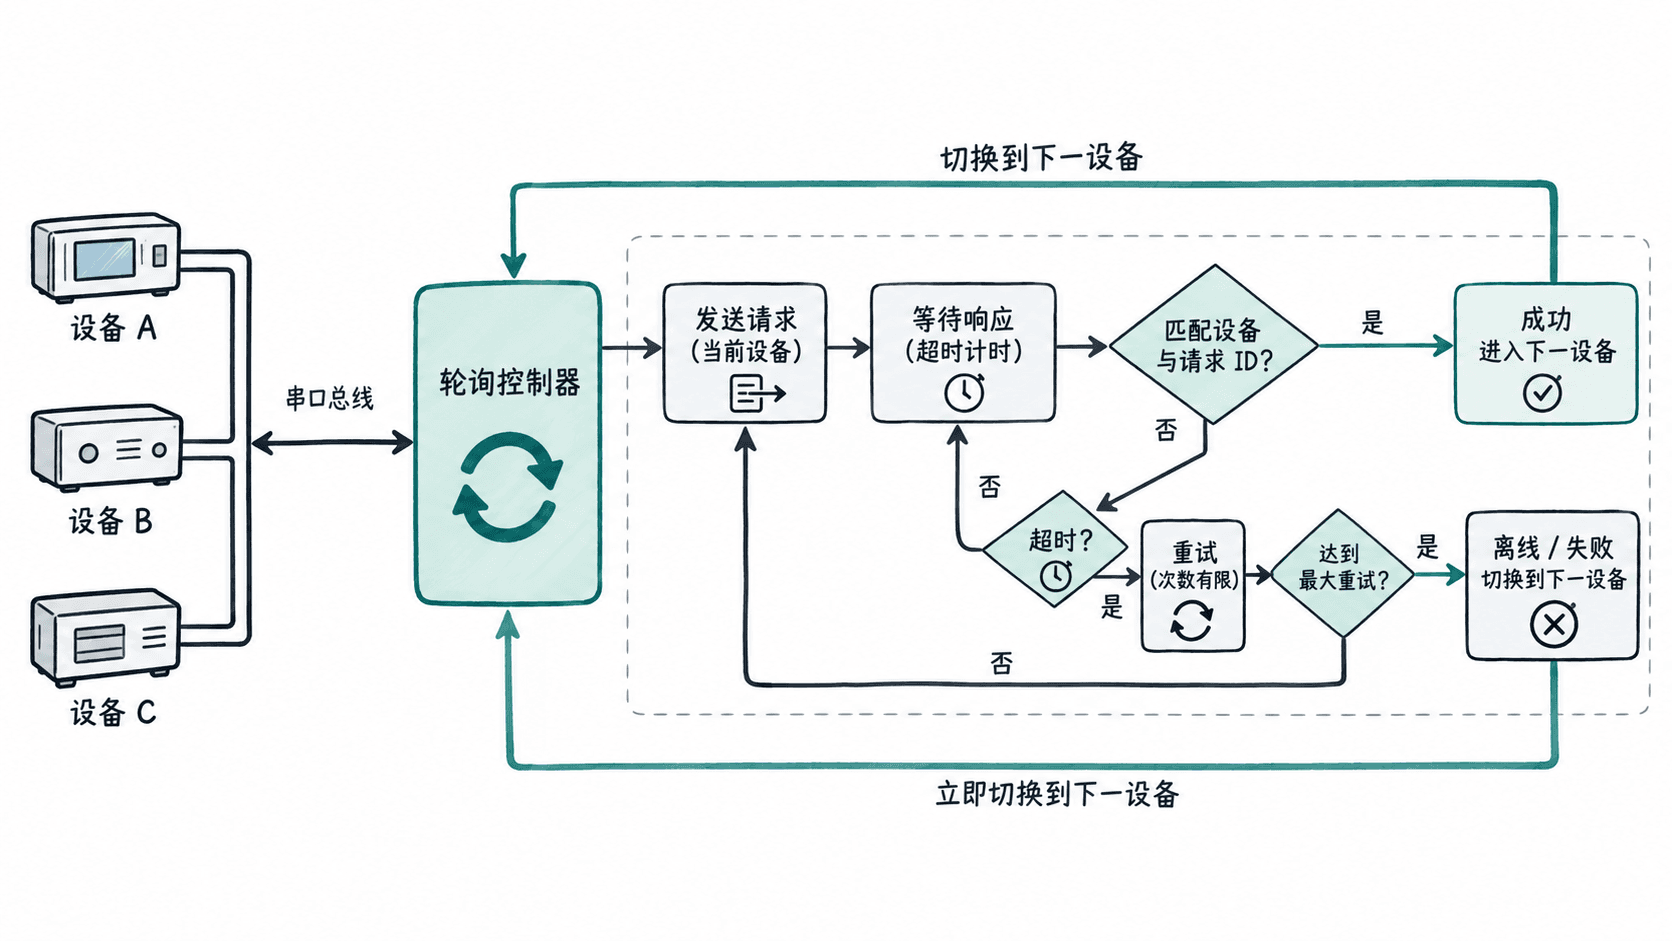
一次轮询至少需要区分“已发送、等待响应、收到匹配响应、超时、重试、最终失败”。尤其要注意:收到响应不等于收到正确响应,响应中的设备地址和请求标识必须与当前请求匹配。
请求必须有匹配条件
如果总线上同时轮询多个节点,收到任何一帧都不能直接当作当前请求的响应。示例中使用 device_id 和 request_id 双重匹配;实际协议可能没有请求 ID,此时可以根据设备地址、功能码和请求顺序组合判断。
一个安全的判断逻辑是:先确认设备身份,再确认消息类型,最后确认请求标识。只有全部匹配,等待状态才结束。
用有限重试控制等待时间
下面的示例不依赖真实串口,使用一个可控的模拟传输层验证轮询算法。timeout 表示单次请求允许等待的最长时间,max_retries 表示超时后最多再次发送多少次。
from dataclasses import dataclass


@dataclass
class Response:
    device_id: int
    request_id: int
    value: int


class FakeTransport:
    def __init__(self, online_devices: set[int]):
        self.online_devices = online_devices
        self.request_id = 0

    def request(self, device_id: int) -> Response | None:
        self.request_id += 1
        if device_id not in self.online_devices:
            return None
        return Response(device_id, self.request_id, 42 + device_id)


def poll_devices(device_ids: list[int], timeout: float, max_retries: int) -> None:
    transport = FakeTransport({1, 3})

    for device_id in device_ids:
        request_id = transport.request_id + 1
        result = None

        for attempt in range(max_retries + 1):
            response = transport.request(device_id)
            print(f"device={device_id} attempt={attempt + 1}")

            # 示例中用立即返回模拟响应;真实串口应在 timeout 内等待匹配帧。
            if response and response.device_id == device_id and response.request_id == transport.request_id:
                result = response
                break

            print(f"device={device_id} timeout={timeout}s")

        if result is None:
            print(f"device={device_id} offline")
        else:
            print(f"device={device_id} value={result.value}")


poll_devices([1, 2, 3], timeout=0.2, max_retries=2)
预期输出
device=1 attempt=1
device=1 value=43
device=2 attempt=1
device=2 timeout=0.2s
device=2 attempt=2
device=2 timeout=0.2s
device=2 attempt=3
device=2 timeout=0.2s
device=2 offline
device=3 attempt=1
device=3 value=45
这个模拟程序把 request() 的阻塞行为简化成立即返回,重点验证的是控制流程:节点 2 最多尝试 3 次,失败后立刻切换到节点 3。真实实现应由串口接收线程或事件循环持续喂入解析器,再由轮询器等待匹配响应,而不是直接阻塞在底层读取上。
不要把超时和重试写成无限循环
超时控制至少需要两个边界。第一是单次等待边界,防止一次请求卡死;第二是总尝试边界,防止某个离线设备被反复请求。
可以把一次节点的最坏等待时间粗略理解为:,其中 是重试次数。这个估算用于规划轮询周期,不代表底层库一定严格按该公式执行。
生产环境还要区分“没有收到响应”和“收到明确错误响应”。前者通常适合超时重试;后者是否重试,应依据协议语义决定,例如参数错误、权限错误通常重复发送也不会改变结果。
验证离线节点不会拖住链路
可以把测试设备设置为在线、离线、在线三种状态,观察轮询日志是否始终从第一个节点推进到最后一个节点。验收重点不是“所有节点都成功”,而是任何单节点失败都有确定上限,并且失败后能够继续下一节点。
当响应可能迟到时,还要记录请求 ID 或序列号,并在收到过期响应时直接丢弃,不能把上一轮的迟到数据误认成当前轮响应。这样,超时、重试和流式解析才能真正组合成一条不会因单个设备异常而失控的通信链路。