
单片机与物联网 / 系统课时
用状态机逐字节解析协议
用状态机逐字节解析协议
把串口输入当作连续字节流时,一次 read 可能只拿到半帧,也可能同时包含多帧。用状态机逐字节消费数据,可以让帧头、固定字段、长度、负载和 CRC 的边界明确,并且天然适应碎片输入。
学习目标
- 能按协议字段设计逐字节解析状态
- 能处理半帧、连续帧和字段跨越多次读取
- 能通过状态迁移定位解析错误
先把协议拆成状态
下面用一个简化协议说明方法:帧头为 0xAA 0x55,随后是 1 字节类型、1 字节长度、长度字节数的负载,最后是 1 字节异或校验。解析器不关心一次收到多少字节,只关心当前状态消费了哪个字节。
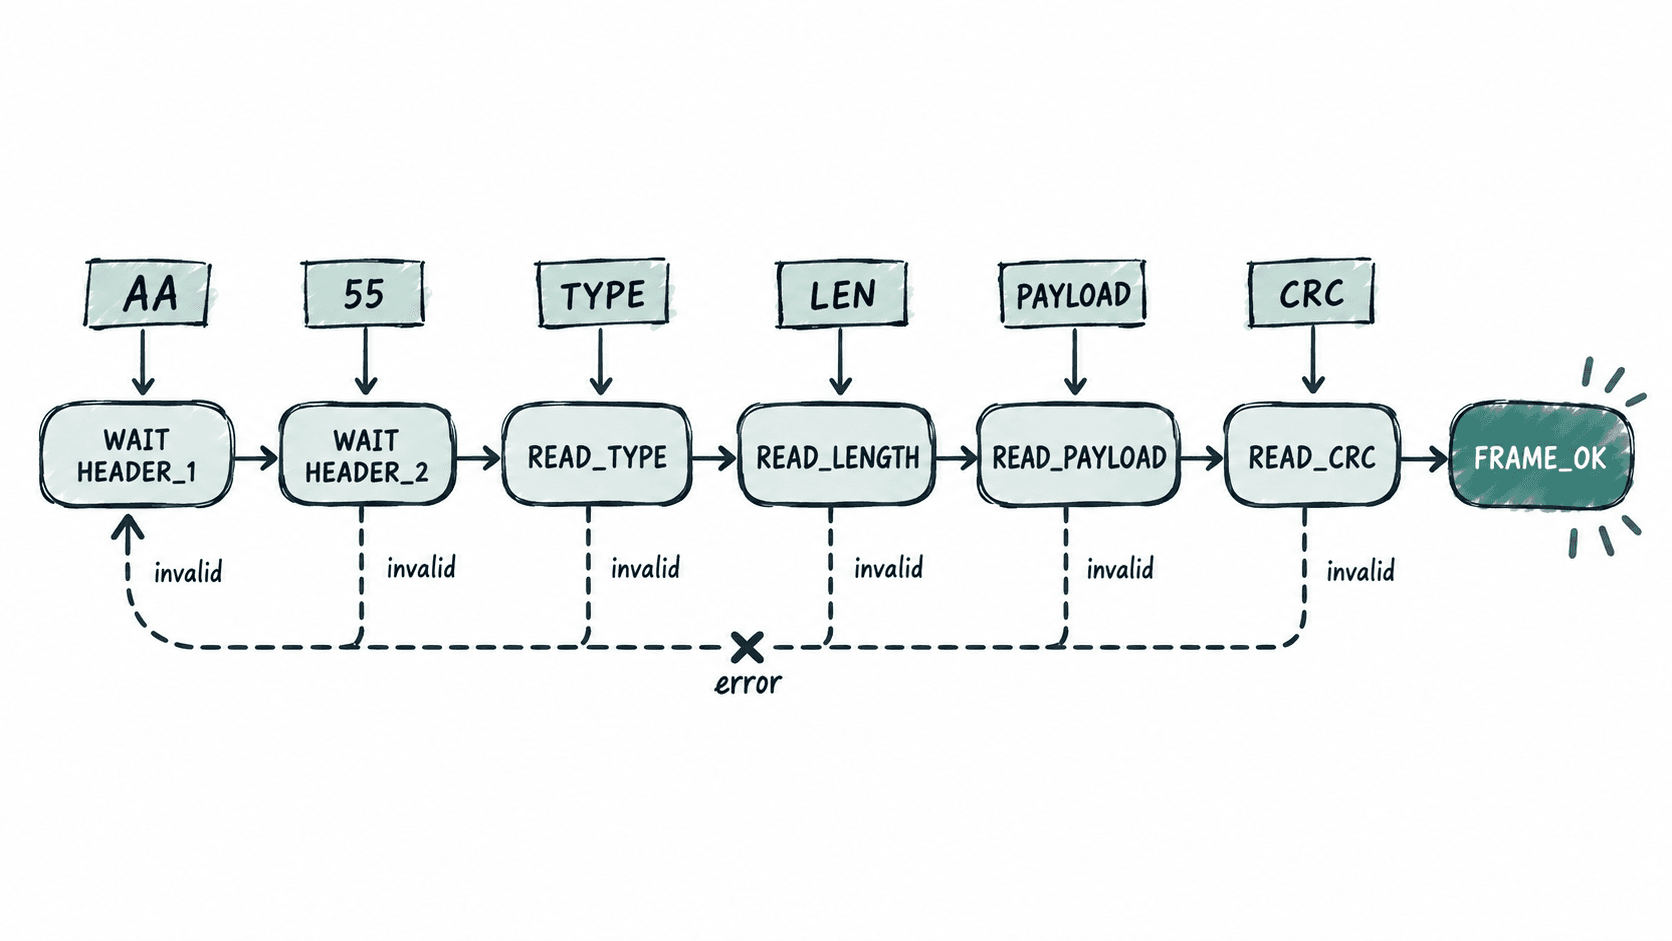
建议把“正在读取什么”作为状态,而不是把一个完整操作封装成状态。例如读长度时进入 READ_LENGTH,拿到长度后立即初始化剩余字节计数,再进入 READ_PAYLOAD。这样每个状态都只有一个明确职责。
逐字节消费的实现
下面是一个可独立运行的 Python 示例。输入故意拆成多个碎片,第三段还包含下一帧,验证解析器不会依赖读取边界。
HEADER_1 = 0xAA
HEADER_2 = 0x55

class Parser:
    WAIT_HEADER_1 = 0
    WAIT_HEADER_2 = 1
    READ_TYPE = 2
    READ_LENGTH = 3
    READ_PAYLOAD = 4
    READ_CRC = 5

    def __init__(self):
        self.state = self.WAIT_HEADER_1
        self.frame = bytearray()
        self.remaining = 0
        self.expected_crc = 0

    def feed(self, data):
        frames = []
        for byte in data:
            result = self._consume(byte)
            if result is not None:
                frames.append(result)
        return frames

    def _consume(self, byte):
        if self.state == self.WAIT_HEADER_1:
            if byte == HEADER_1:
                self.frame = bytearray([byte])
                self.state = self.WAIT_HEADER_2
            return None

        if self.state == self.WAIT_HEADER_2:
            if byte == HEADER_2:
                self.frame.append(byte)
                self.state = self.READ_TYPE
            elif byte == HEADER_1:
                self.frame = bytearray([byte])
            else:
                self.state = self.WAIT_HEADER_1
                self.frame.clear()
            return None

        if self.state == self.READ_TYPE:
            self.frame.append(byte)
            self.state = self.READ_LENGTH
            return None

        if self.state == self.READ_LENGTH:
            self.frame.append(byte)
            self.remaining = byte
            if self.remaining == 0:
                self.state = self.READ_CRC
            else:
                self.state = self.READ_PAYLOAD
            return None

        if self.state == self.READ_PAYLOAD:
            self.frame.append(byte)
            self.remaining -= 1
            if self.remaining == 0:
                self.state = self.READ_CRC
            return None

        if self.state == self.READ_CRC:
            self.frame.append(byte)
            crc = 0
            for value in self.frame[:-1]:
                crc ^= value
            if crc == byte:
                result = bytes(self.frame)
                self.state = self.WAIT_HEADER_1
                self.frame.clear()
                return result
            self.state = self.WAIT_HEADER_1
            self.frame.clear()
            return None

        self.state = self.WAIT_HEADER_1
        self.frame.clear()
        return None

parser = Parser()
chunks = [
    bytes.fromhex("AA"),
    bytes.fromhex("55 01 03"),
    bytes.fromhex("10 20 30 9D AA 55 02 01 7F 62")
]

for chunk in chunks:
    for frame in parser.feed(chunk):
        print(frame.hex(" "))
预期输出
AA 55 01 03 10 20 30 9D
AA 55 02 01 7F 62
这里的关键不是代码长度,而是 feed() 每次都从当前状态继续处理。即使 AA 和 55 分属两次读取,解析器也不会丢失帧头;一个读取块包含两帧时,也会连续产出两个结果。
状态迁移要守住的边界
READ_LENGTH 是重要分界点。长度字段一旦被接受,就应该固定本帧需要消费多少个负载字节,不能根据后续读取块大小动态改变。这样即使负载中恰好出现 AA 55,也不会被误判为新帧。
对于长度为零的协议,通常应明确约定状态是否直接进入 CRC。不要让 READ_PAYLOAD 依赖“至少收到一个字节”这一隐含假设,否则空负载帧很容易卡在错误状态。
每个状态都应有失败出口。帧头状态遇到不匹配字节可以重新等待帧头;字段状态遇到非法值则应结束当前候选帧并重新同步,而不是继续沿错误长度读取。
调试状态机时看什么
最有效的调试日志不是只打印“解析失败”,而是记录输入字节、旧状态、新状态和关键计数。例如定位长度异常时,重点检查进入 READ_PAYLOAD 时的 remaining 是否正确;定位 CRC 异常时,检查参与计算的字节范围是否包含了错误字段。
状态机真正解决的是“输入边界不可靠”问题。只要每个字节都有确定的消费规则,串口驱动怎样拆包并不影响协议层;解析器最终得到的是完整帧,而不是某一次读取得到的偶然片段。