
单片机与物联网 / 系统课时
设备忙时怎样返回错误
设备忙时怎样返回错误
设备收到请求并不代表它一定能立即执行。运动控制、参数写入、Flash 操作或已有事务尚未完成时,设备可能正处于“忙”状态。本篇设计可判别的错误响应,让主站知道应该重试、终止还是记录告警,而不是把所有失败都当成通信超时。
学习目标
- 区分设备忙、非法命令、参数错误和内部故障。
- 设计稳定的错误码和可行动的响应内容。
- 根据错误类型决定重试、终止或告警策略。
先把失败原因分开
最常见的问题是设备只返回一个模糊的失败标志,例如 ERROR。主站看到它以后无法判断是暂时繁忙、命令写错、参数越界,还是设备内部异常,于是容易出现无意义的无限重试。
更实用的分类是:忙表示请求本身可能有效,但当前资源或状态暂时不能处理;非法命令表示设备不认识该操作;参数错误表示命令存在,但参数不满足约束;内部故障表示设备无法完成原本允许的操作。
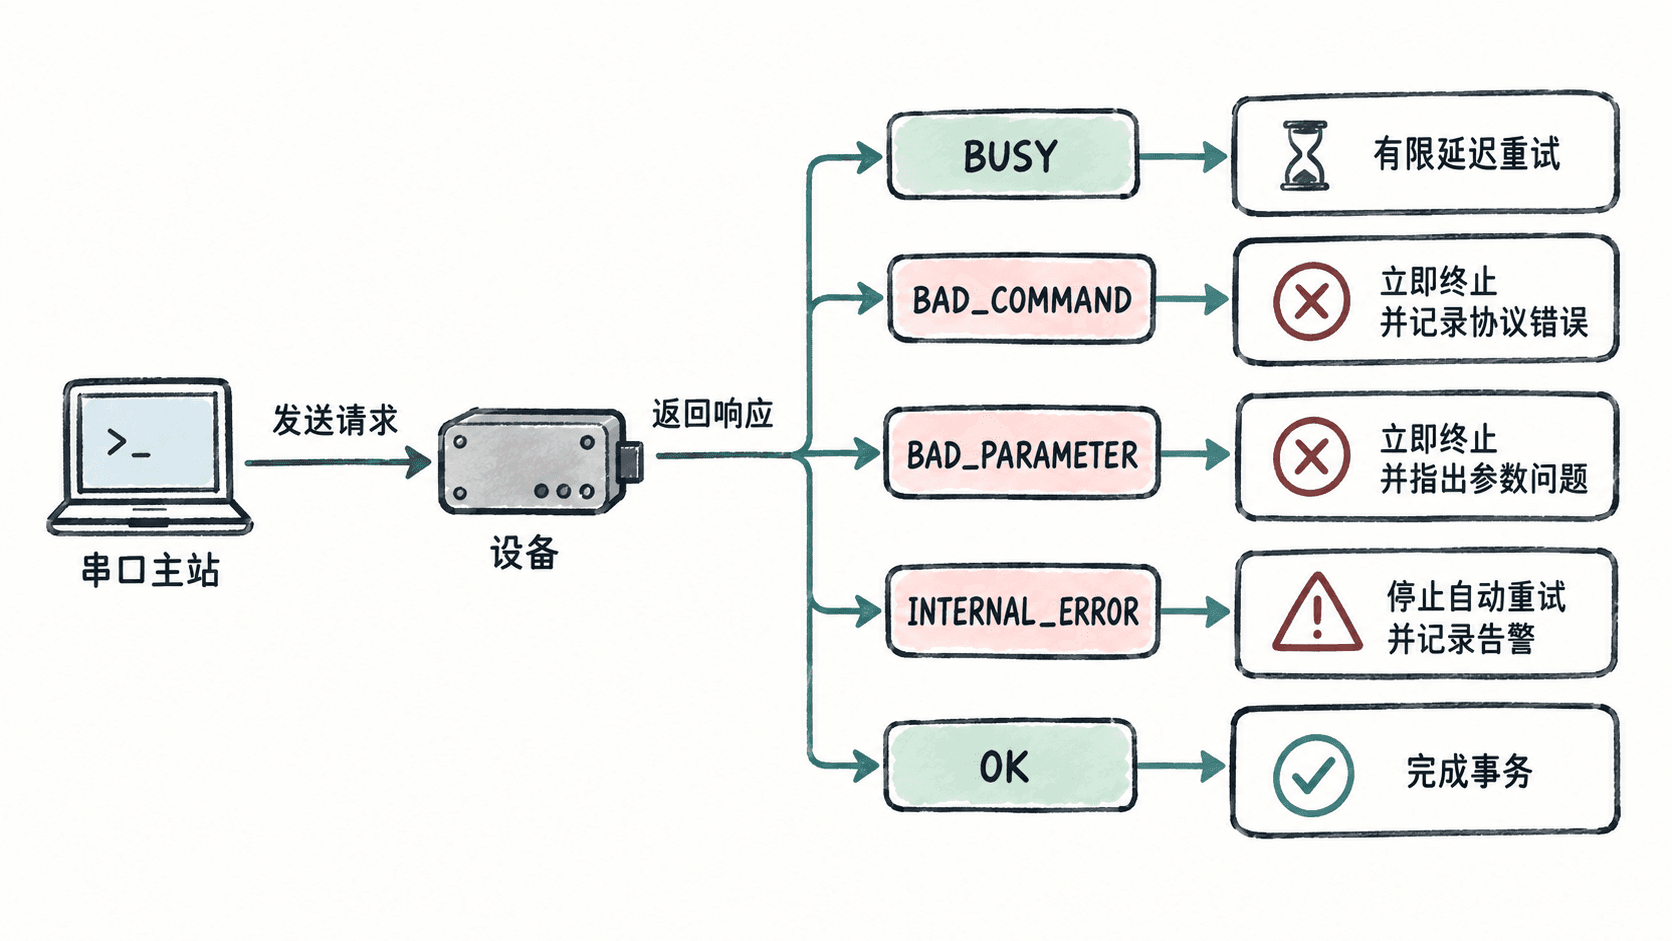
错误码要服务于主站决策
错误码不只是给日志看的。每个错误至少要能回答两个问题:这是暂时性错误还是永久性错误?主站拿到它以后下一步该做什么?因此可以把协议响应设计成“结果码 + 可选错误细节”,例如:
| 错误类型 | 典型含义 | 主站动作 |
|---|---|---|
BUSY |
当前操作未准备好 | 延迟后有限次数重试 |
BAD_COMMAND |
命令码不支持 | 终止并记录协议错误 |
BAD_PARAMETER |
参数非法或越界 | 修正参数后再发送 |
INTERNAL_ERROR |
设备内部处理失败 | 停止自动重试并告警 |
这里不要把“超时”混进设备错误码。超时意味着主站没有得到完整响应,可能是设备未处理、响应丢失或链路异常;它与设备明确回复 BUSY 的语义不同。
响应示例
下面是一个独立的 Python 片段示例,用于模拟主站收到错误码后的决策。它依赖前文约定的响应字段,不涉及具体串口驱动。
def decide_action(response: dict) -> str:
    code = response.get("code")

    if code == "OK":
        return "DONE"
    if code == "BUSY":
        return "RETRY_LATER"
    if code in {"BAD_COMMAND", "BAD_PARAMETER"}:
        return "STOP"
    if code == "INTERNAL_ERROR":
        return "ALERT"
    return "PROTOCOL_ERROR"

responses = [
    {"code": "BUSY"},
    {"code": "BAD_PARAMETER"},
    {"code": "INTERNAL_ERROR"},
]

for response in responses:
    print(response["code"], "->", decide_action(response))
预期输出
BUSY -> RETRY_LATER
BAD_PARAMETER -> STOP
INTERNAL_ERROR -> ALERT
这样主站就能把“可恢复失败”和“应立即停止的失败”分开处理。
BUSY 最容易设计错的地方
BUSY 不应该等同于“设备坏了”。例如设备正在执行上一条动作命令,而新命令确实合法,这时返回 BUSY 可以让主站稍后再试。但重试策略必须有限制,否则设备持续忙时,主站会形成高频轮询,反而加重设备压力。
常见做法是让主站采用递增等待时间,并设置最大重试次数。设备若能提供预计等待时间,也可以把它放入错误详情字段;如果没有这个能力,至少保证 BUSY 的语义稳定,不要同一设备上有时表示排队、有时表示内部故障。
内部故障要避免误重试
对于 INTERNAL_ERROR,自动重试需要谨慎。若失败来自传感器异常、存储错误或内部状态损坏,重复发送同一命令通常不会修复根因。此时更重要的是记录错误码、关联请求标识和关键设备状态,必要时进入人工恢复流程。
最终,错误响应应该围绕主站的决策设计,而不是围绕“设备把错误打印出来”设计。只要主站能够明确知道哪些情况可以稍后再试、哪些必须修改请求、哪些需要立即告警,请求响应链路就从“只有成功或失败”升级成了可恢复、可排障的协议行为。