
单片机与物联网 / 系统课时
一次 read 为什么不是一帧
一次 read 为什么不是一帧
串口接收的是连续字节流,read 返回的是当前能够取得的一段数据,而不是协议主动帮你切好的完整帧。本篇用半包、完整帧和多帧连读三个结果建立正确的读取模型,避免把一次读取边界误当成协议边界。
学习目标
- 理解串口
read返回长度为什么可能与帧长度不同 - 能识别半包、完整帧和一次读到多帧三种常见情况
- 知道应用层为什么必须自己依据帧头、长度或结束标志拆帧
read 返回的是可用字节,不是消息
假设协议规定一帧是 AA 55 03 10 20 30,总长度为 6 字节。串口驱动接收的是连续字节,因此调用一次读取时,返回值只表示“这次拿到了多少字节”,并不表示“这里正好结束了一帧”。
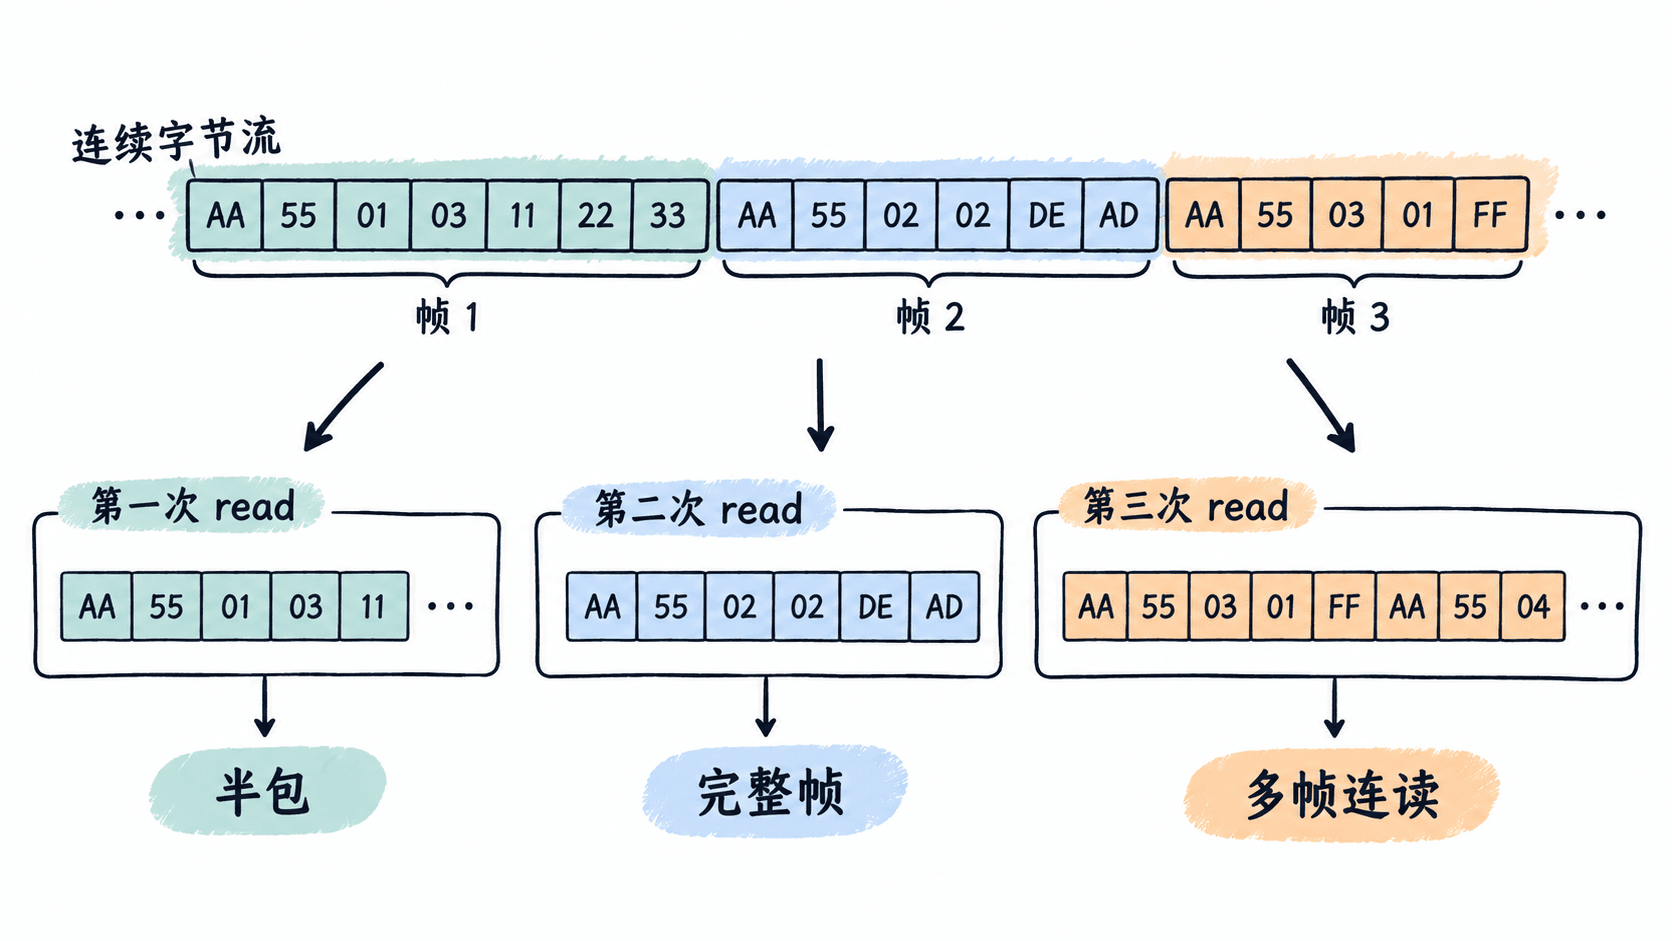
如果发送端连续发送多帧,而接收线程每次请求读取 64 字节,那么实际结果可能是 2 字节、6 字节、17 字节,也可能一次拿到多帧。返回长度受当前缓冲区已有数据、调度时机、驱动行为以及读取参数影响。
三种结果都合法
以两帧连续数据为例:
AA 55 03 10 20 30
AA 55 02 7F 01
一次读取可能只得到前 3 个字节:
AA 55 03预期结果
本次得到 3 字节:属于第一帧的半包,不能立即按完整帧处理。下一次读取可能得到剩余内容和第二帧的一部分:
10 20 30 AA 55预期结果
本次得到 5 字节:补齐第一帧,同时已经包含第二帧的帧头。也可能一次读取直接得到两帧:
AA 55 03 10 20 30 AA 55 02 7F 01预期结果
本次得到 11 字节:包含 2 个完整协议帧,不能只处理第一帧后丢弃剩余字节。用流读取模拟边界变化
下面用 Python 的 socketpair 模拟一个连续字节流。它不是 UART 驱动,但同样体现“发送的数据边界”和“接收端一次 recv 的返回边界”彼此独立的特点。
import socket

sender, receiver = socket.socketpair()
sender.sendall(b"AA5503" + b"102030" + b"AA55027F01")

part1 = receiver.recv(3)
part2 = receiver.recv(5)
part3 = receiver.recv(16)

print(part1)
print(part2)
print(part3)

sender.close()
receiver.close()
预期输出
b'AA5'
b'50310'
b'2030AA55027F01'
这个结果的重点不是具体字节数,而是 recv(3)、recv(5) 和后续读取只是消费连续流中的字节。协议帧本身并不会因为调用了 read 或 recv 就自动对齐。
为什么不能用一次 read 判断“帧结束”
假设代码写成“读取一次,然后把返回内容当成一帧”,那么半包会被误解析。例如收到 AA 55 03 时,虽然已经读到合法帧头和长度字段,但载荷还没有到齐,此时必须等待后续字节。
相反,一次读到多帧时,如果代码只解析第一帧并清空接收缓冲区,第二帧就会被一并删除,最终表现为偶发丢包。真正可靠的做法是把读取和拆帧分成两个独立阶段:读取只负责不断获取字节,解析器负责根据协议规则判断边界。
什么时候可以直接处理一次读取
只有当上层接口本身已经明确提供消息边界,或者协议层已经帮你完成了完整报文组装,才可以把一次返回值直接当作一条消息。原始 UART 通常只提供字节流,因此业务协议需要额外的拆帧逻辑。
记住一个简单判断:UART 给你的是“现在有多少字节”,协议解析器要解决的是“这些字节属于哪些帧”。只要这两个职责分开,半包和多帧连读都不会再被误认为异常。