
数据库原理与选型 / 系统课时
数据库迁移与自动化测试
数据库迁移与自动化测试
当程序版本升级需要改变表结构时,不能依赖人工“记得执行几条 SQL”。更可靠的做法是给每个迁移分配递增版本号,把已执行版本记录在数据库中,并让生产环境和测试环境运行同一套迁移逻辑。这样才能稳定复现升级路径并验证数据访问代码。
学习目标
- 设计最小可用的迁移版本表和迁移执行顺序
- 让结构变更与版本记录在同一事务中成功或回滚
- 使用临时 SQLite 文件自动化验证迁移和数据访问逻辑
迁移的最低契约
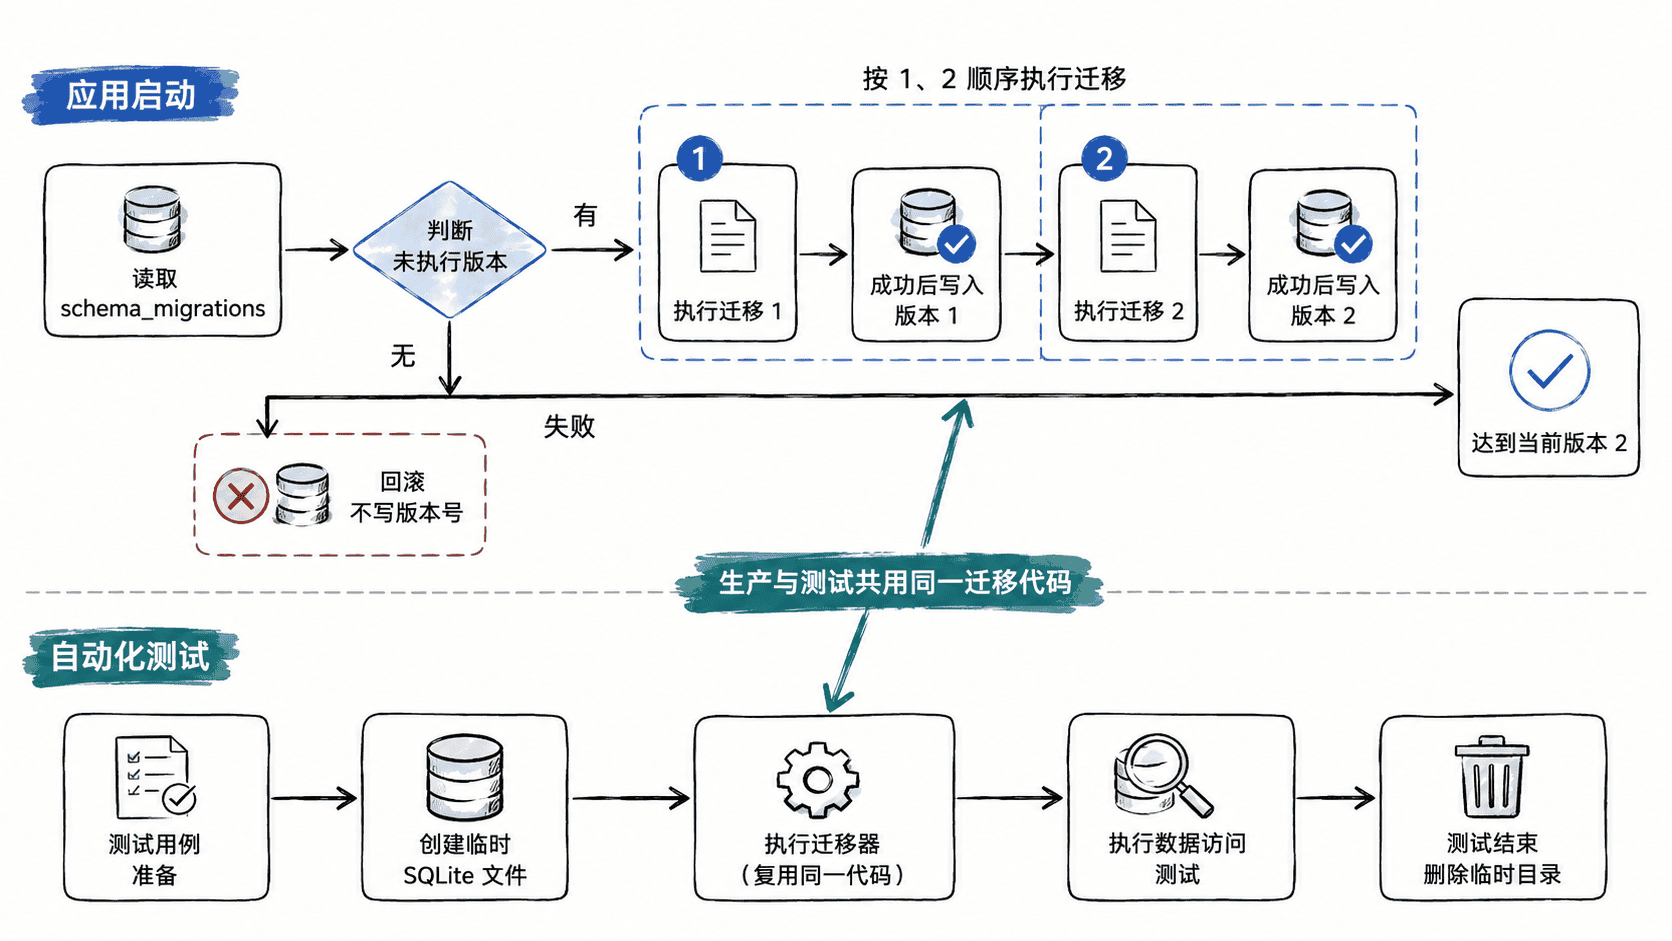
一个可维护的迁移系统至少需要两部分:按顺序排列的迁移代码,以及记录“哪些版本已经应用”的版本表。启动程序或部署任务时,先读取版本表,再执行尚未应用的迁移。已经发布的旧迁移不要原地改写,否则不同环境可能拥有相同版本号却得到不同结构。
版本号使用 1、2、3... 就足够。更重要的是原子性:一次迁移中的结构变更和版本登记必须一起提交。若新增列成功但版本号没有记录,下次启动可能重复执行;若只登记版本而结构未变化,后续代码又会误判数据库已经升级。
编写迁移器并自动化验证
下面的完整脚本包含两个迁移:版本 1 创建 users 表,版本 2 增加 email 列。执行器先读取 schema_migrations,再对未应用版本显式开启事务;BEGIN IMMEDIATE 还会在迁移开始时取得写事务,避免多个写入者同时修改结构。
测试使用临时目录中的数据库文件,并在每个测试开始时连续调用两次迁移器。第二次调用不应重复执行 ALTER TABLE,因此同时验证了迁移的幂等执行入口。
from pathlib import Path
from tempfile import TemporaryDirectory
from typing import Callable
import sqlite3
import unittest

Migration = tuple[int, Callable[[sqlite3.Connection], None]]

def migration_1(conn: sqlite3.Connection) -> None:
    conn.execute(
        "CREATE TABLE users ("
        "id INTEGER PRIMARY KEY, "
        "name TEXT NOT NULL"
        ")"
    )

def migration_2(conn: sqlite3.Connection) -> None:
    conn.execute("ALTER TABLE users ADD COLUMN email TEXT")

MIGRATIONS: list[Migration] = [
    (1, migration_1),
    (2, migration_2),
]

def run_migrations(conn: sqlite3.Connection) -> None:
    conn.execute(
        "CREATE TABLE IF NOT EXISTS schema_migrations ("
        "version INTEGER PRIMARY KEY, "
        "applied_at TEXT NOT NULL DEFAULT CURRENT_TIMESTAMP"
        ")"
    )
    conn.commit()

    applied = {
        row[0]
        for row in conn.execute(
            "SELECT version FROM schema_migrations"
        ).fetchall()
    }

    for version, upgrade in MIGRATIONS:
        if version in applied:
            continue

        # 显式事务保证结构变更与版本登记一起提交或一起回滚。
        conn.execute("BEGIN IMMEDIATE")
        try:
            upgrade(conn)
            conn.execute(
                "INSERT INTO schema_migrations(version) VALUES (?)",
                (version,),
            )
        except Exception:
            conn.rollback()
            raise
        else:
            conn.commit()

class DataAccessTest(unittest.TestCase):
    def setUp(self) -> None:
        self.temp_dir = TemporaryDirectory()
        self.db_path = Path(self.temp_dir.name) / "test.db"

        conn = sqlite3.connect(self.db_path)
        try:
            run_migrations(conn)
            run_migrations(conn)
        finally:
            conn.close()

    def tearDown(self) -> None:
        self.temp_dir.cleanup()

    def test_current_schema_version(self) -> None:
        conn = sqlite3.connect(self.db_path)
        try:
            versions = [
                row[0]
                for row in conn.execute(
                    "SELECT version FROM schema_migrations ORDER BY version"
                ).fetchall()
            ]
        finally:
            conn.close()

        self.assertEqual([1, 2], versions)

    def test_insert_and_read_user(self) -> None:
        conn = sqlite3.connect(self.db_path)
        try:
            with conn:
                conn.execute(
                    "INSERT INTO users(name, email) VALUES (?, ?)",
                    ("alice", "alice@example.com"),
                )
            row = conn.execute(
                "SELECT name, email FROM users WHERE name = ?",
                ("alice",),
            ).fetchone()
        finally:
            conn.close()

        self.assertEqual(("alice", "alice@example.com"), row)

if __name__ == "__main__":
    unittest.main()
预期输出
..
----------------------------------------------------------------------
Ran 2 tests in <TIME>s

OK
<TIME> 会随机器性能变化。第一项测试确认版本表只有 1、2 两条记录,第二项测试确认迁移后的 email 列能被实际的数据访问 SQL 正常写入和读取。
临时文件与内存数据库怎么选
:memory: 很适合单连接、执行速度优先的单元测试,但每次普通的 sqlite3.connect(":memory:") 都会得到独立数据库。如果被测代码内部会自行新建连接,测试准备的表和数据就可能“消失”。临时文件更适合验证真实连接生命周期,也更接近生产中的文件数据库行为。
SQLite 也支持 URI 形式的共享内存数据库,但它要求相关连接使用同一 URI,并且至少保留一个连接存活。除非测试确实需要多连接共享内存,否则临时目录加独立数据库文件通常更简单,也更容易排查失败现场。
上线与验收
迁移上线前应先备份数据库文件,并在副本上从当前生产版本完整升级到目标版本。部署时先执行迁移,再启动依赖新结构的代码;如果多个进程可能同时启动,应保证只有一个迁移执行者,或在更高层提供互斥,避免并发修改模式。
验收不要只看“脚本没有报错”。至少检查版本表已达到目标版本、关键表和列存在,并运行真实的数据访问测试。生产与测试复用同一迁移器,才能让自动化测试覆盖发布时真正会执行的升级路径。