
数据库原理与选型 / 系统课时
连接生命周期与线程边界
连接生命周期与线程边界
SQLite 没有独立数据库服务器,应用进程直接通过连接对象访问数据库文件。工程上的关键不是“连接越少越好”,而是让连接生命周期与执行单元对齐:明确谁创建、谁使用、谁提交事务、谁关闭,并为锁等待设置有限超时。
学习目标
- 选择长连接、按请求连接或按任务短连接的合适边界
- 理解 Python
sqlite3的线程限制以及跨线程共享连接的风险 - 为连接统一配置超时、事务提交和关闭策略
连接应该活多久
连接对象同时承载事务状态、锁等待策略和部分会话级配置。桌面程序或单线程后台任务可以让连接随进程长期存在;Web 请求、线程池任务和并发作业更适合让连接归属于当前请求或工作线程,并在任务结束时关闭。
短连接的优势是边界清楚、异常后容易回收,代价是频繁打开文件会产生少量额外开销。长连接减少重复初始化,但必须防止事务长期不提交、对象被错误跨线程复用,以及程序关闭时遗漏回收。无论哪种模式,都应让事务尽可能短,因为 SQLite 的写入最终仍需要串行获得写锁。
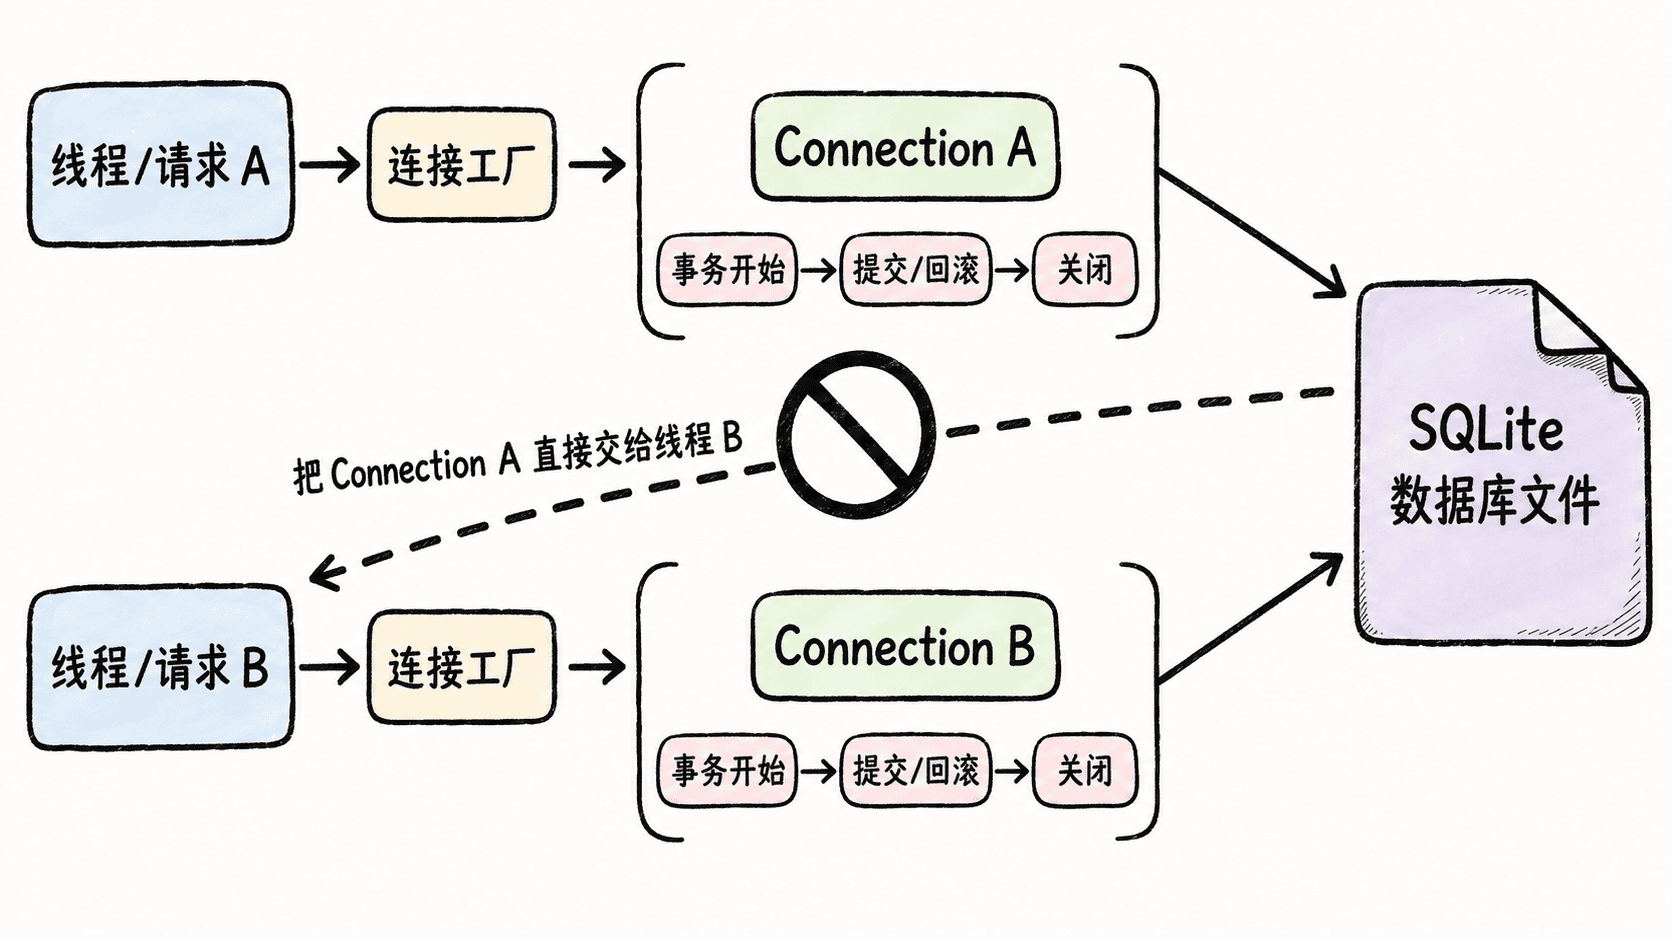
线程边界不是连接池开关
Python sqlite3 默认启用 check_same_thread=True:连接在哪个线程创建,就只能在那个线程使用。把连接直接交给其他线程通常会触发 ProgrammingError。将它改为 False 只是关闭这层检查,并不会自动把一个连接变成适合多线程并发访问的共享资源;如果多个线程会写入,应用仍需自行串行化访问。
因此,常见做法是“每个工作线程拥有自己的连接”,而不是“所有线程共享一个全局连接”。多个连接可以同时读同一个数据库文件,但并发写仍受 SQLite 锁机制约束。线程边界解决的是连接对象归属问题,不是写入吞吐问题。
设置超时并运行示例
下面的完整示例让两个线程各自创建并关闭连接。timeout=5.0 表示遇到数据库锁时最多等待约 5 秒,再由 sqlite3 抛出 OperationalError;它是有限等待,不是成功保证。
from pathlib import Path
import sqlite3
import threading

DB_PATH = Path("thread-boundary.db")

def open_connection() -> sqlite3.Connection:
    # 统一连接策略,避免不同调用点使用不同的锁等待时间。
    conn = sqlite3.connect(DB_PATH, timeout=5.0)
    conn.execute("PRAGMA foreign_keys = ON")
    return conn

def initialize() -> None:
    conn = open_connection()
    try:
        conn.execute("DROP TABLE IF EXISTS visits")
        conn.execute(
            "CREATE TABLE visits (id INTEGER PRIMARY KEY, worker TEXT NOT NULL)"
        )
        conn.commit()
    finally:
        conn.close()

def record_visit(worker: str) -> None:
    # 连接在当前线程内创建、提交并关闭,不跨线程传递。
    conn = open_connection()
    try:
        conn.execute("INSERT INTO visits(worker) VALUES (?)", (worker,))
        conn.commit()
    finally:
        conn.close()

def main() -> None:
    initialize()
    threads = [
        threading.Thread(target=record_visit, args=("api-1",)),
        threading.Thread(target=record_visit, args=("api-2",)),
    ]

    for thread in threads:
        thread.start()
    for thread in threads:
        thread.join()

    conn = open_connection()
    try:
        rows = conn.execute(
            "SELECT worker FROM visits ORDER BY worker"
        ).fetchall()
    finally:
        conn.close()

    print(f"rows={len(rows)}")
    print("workers=" + ",".join(row[0] for row in rows))

if __name__ == "__main__":
    main()
预期输出
rows=2
workers=api-1,api-2
如果并发写竞争持续超过超时时间,实际运行可能看到 database is locked。此时应先缩短事务、避免在事务内做网络调用或长时间计算,再评估是否需要 WAL 模式或更高层的写入队列;单纯把超时无限增大只会延迟失败。
工程取舍
按请求或按任务创建连接,适合边界明确、并发执行单元较多的程序;长期连接适合单线程工具、桌面应用或受控后台进程。无论采用哪种方式,都应把连接创建集中到一个工厂函数中,统一设置 timeout、外键检查等策略,并用 try/finally 或等价机制确保关闭。
判断设计是否健康可以抓住三点:连接不会跨越未定义的线程边界,事务不会无期限占锁,任务结束后连接一定释放。做到这三点后,连接复用才是性能优化问题,而不是正确性问题。