
数据库原理与选型 / 系统课时
标量、列表与关联子查询
标量、列表与关联子查询
子查询的关键不是“查询里再写查询”,而是先判断它返回什么形态:单个值、一组值,还是依赖外层当前行重新计算的结果。本节用员工与部门数据分别演示标量子查询、列表子查询和关联子查询,并说明何时会报错或产生低效执行。
学习目标
- 根据子查询返回的行列数量选择
=、IN等正确写法。 - 读懂关联子查询如何引用外层行,并判断其逻辑含义。
- 识别多行标量结果、
NULL与重复执行带来的边界问题。
先准备一组可验证数据
下面的数据包含两个部门和四名员工,后续三种子查询都基于它运行。
DROP TABLE IF EXISTS employees;
DROP TABLE IF EXISTS departments;

CREATE TABLE departments (
    department_id INTEGER PRIMARY KEY,
    name TEXT NOT NULL
);

CREATE TABLE employees (
    employee_id INTEGER PRIMARY KEY,
    name TEXT NOT NULL,
    department_id INTEGER NOT NULL,
    salary INTEGER NOT NULL
);

INSERT INTO departments VALUES
(1, 'Engineering'),
(2, 'Sales');

INSERT INTO employees VALUES
(1, 'Alice', 1, 12000),
(2, 'Bob', 1, 8000),
(3, 'Carol', 2, 9000),
(4, 'Dave', 2, 7000);
预期结果:创建 2 张表并写入 6 行示例数据,执行过程不返回结果集。
(无输出)标量子查询返回一个值
标量子查询应当提供一个可放进单个表达式位置的值。例如找出工资高于公司平均工资的员工,内层 AVG 无论员工多少都只返回一行一列。
SELECT name, salary
FROM employees
WHERE salary > (
    SELECT AVG(salary)
    FROM employees
)
ORDER BY salary DESC;
预期结果:
name   salary
-----  ------
Alice  12000
Carol  9000
在 SQLite 中,标量子查询即使意外返回多行,也只会取第一行,而不是像部分数据库那样直接报错。因此不能依赖这种行为;需要唯一值时,应通过聚合、唯一约束或明确条件保证结果确实唯一。
列表子查询提供候选集合
当内层结果是一列多行时,常用 IN 判断外层值是否属于这组候选值。下面查询“拥有月薪至少 9000 员工的部门”。
SELECT name
FROM departments
WHERE department_id IN (
    SELECT department_id
    FROM employees
    WHERE salary >= 9000
)
ORDER BY department_id;
预期结果:
name
-----------
Engineering
Sales
IN 关心成员关系,不要求内层值唯一;即使同一个 department_id 出现多次,外层部门也不会因此重复。若改用 NOT IN,需要特别警惕子查询中的 NULL,因为三值逻辑可能让结果与直觉不同;存在可空值时通常优先考虑 NOT EXISTS。
关联子查询依赖外层当前行
关联子查询会引用外层查询的列。下面的内层查询通过 e.department_id 读取“当前员工所在部门”,因此不同员工会得到不同的部门平均工资。
SELECT e.name, e.salary, e.department_id
FROM employees AS e
WHERE e.salary > (
    SELECT AVG(e2.salary)
    FROM employees AS e2
    WHERE e2.department_id = e.department_id
)
ORDER BY e.department_id, e.salary DESC;
预期结果:
name   salary  department_id
-----  ------  -------------
Alice  12000   1
Carol  9000    2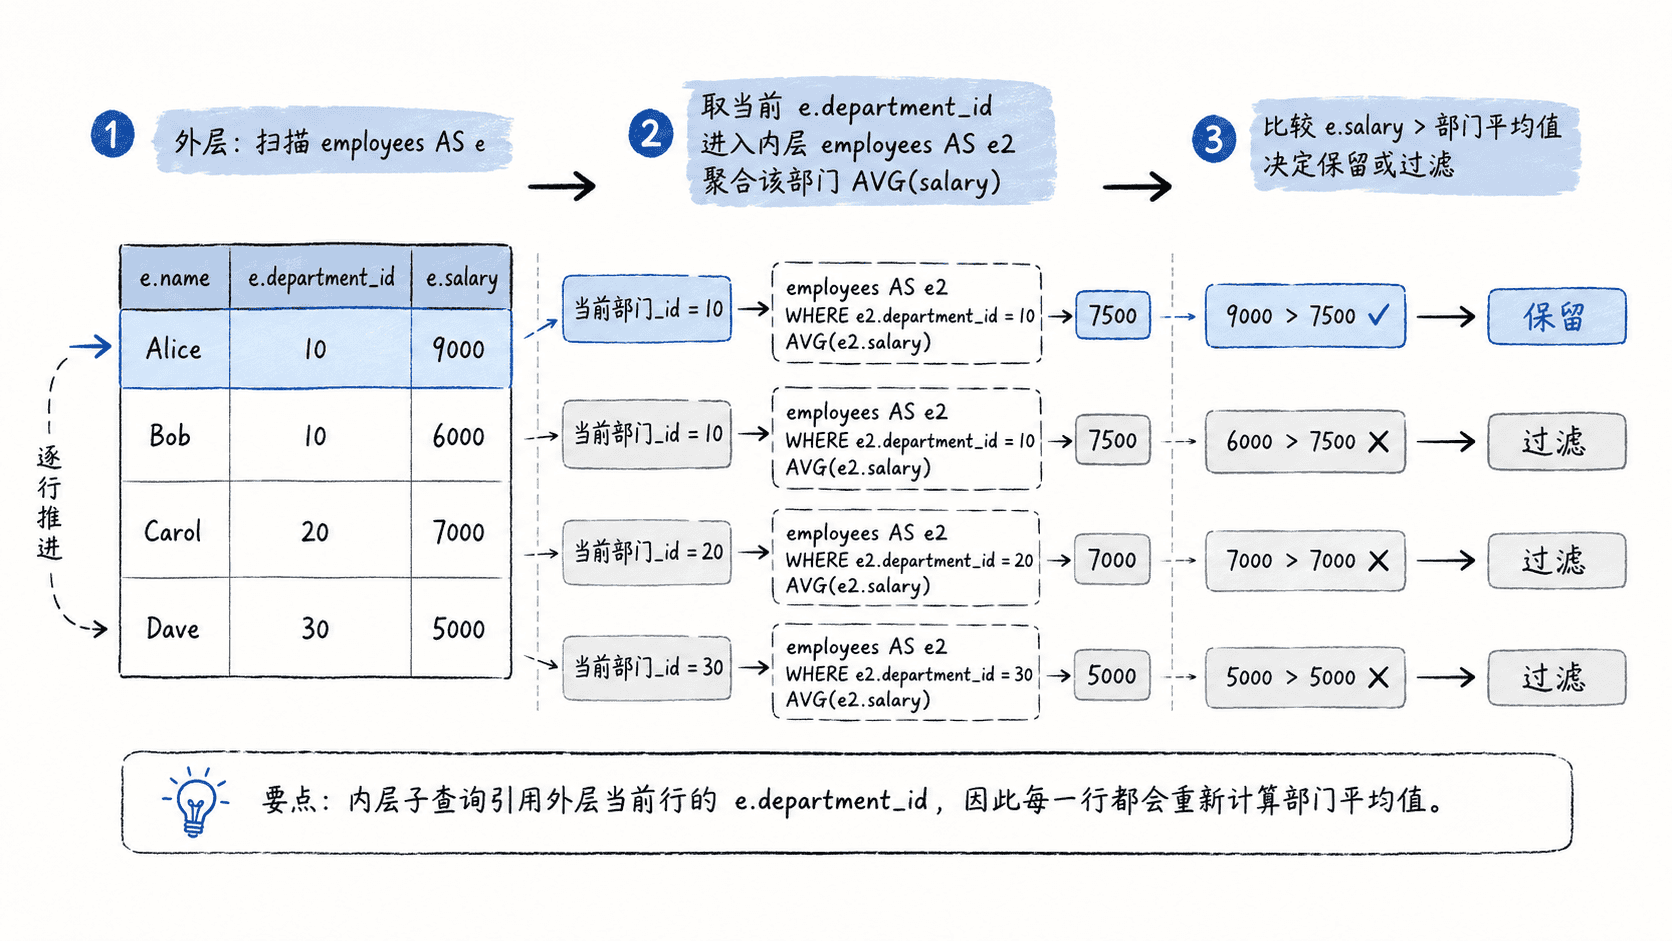
这类写法在逻辑上像“对外层每一行提出一个依赖当前行的问题”。优化器可能改写执行计划,但写查询时仍应按这种相关性理解。数据量较大时,可比较把关联子查询改写为 JOIN 加聚合后的执行计划,并为相关条件列建立合适索引。
选择子查询形态的判断方法
只需要一个聚合值或唯一值时使用标量子查询;需要判断“是否属于一组值”时使用 IN 或 EXISTS;内层条件必须随外层当前行变化时,才需要关联子查询。先确定返回形态,再选择运算符,可以避免“多行结果塞进单值比较”或把本可一次计算的逻辑写成重复相关计算。