
数据库原理与选型 / 系统课时
CTE 与递归查询
CTE 与递归查询
当查询需要先命名中间结果,或沿父子关系一层层展开时,CTE 可以把复杂 SQL 拆成可读步骤。本课先用普通 WITH 组织结果集,再用递归 CTE 查询员工树与整数序列,并说明终止条件和循环风险。
学习目标
- 使用
WITH定义只在当前语句内可见的公共表表达式 - 写出由锚点查询和递归查询组成的
WITH RECURSIVE - 为树形遍历和序列生成设置可靠的终止条件
先把中间结果命名
普通 CTE 的形式是 WITH 名称 AS (查询) 主查询。它可以被后续 SELECT、INSERT、UPDATE 或 DELETE 引用,作用域只覆盖这一条 SQL。可以把它理解为“当前语句里的临时结果集”,但不要依赖它一定被物化;SQLite 查询规划器会决定具体执行方式。
当同一逻辑在主查询里会重复出现,或嵌套子查询已经影响可读性时,CTE 很合适。若只是一次很短的条件过滤,直接写子查询通常更简单。
递归 CTE 如何逐层展开
递归 CTE 仍然是一个命名结果集,只是它会引用自己。结构由两部分组成:锚点查询先产生起始行;递归查询再基于上一轮已经得到的行继续产生下一层。两部分通常用 UNION ALL 连接,直到递归部分不再产生新行。
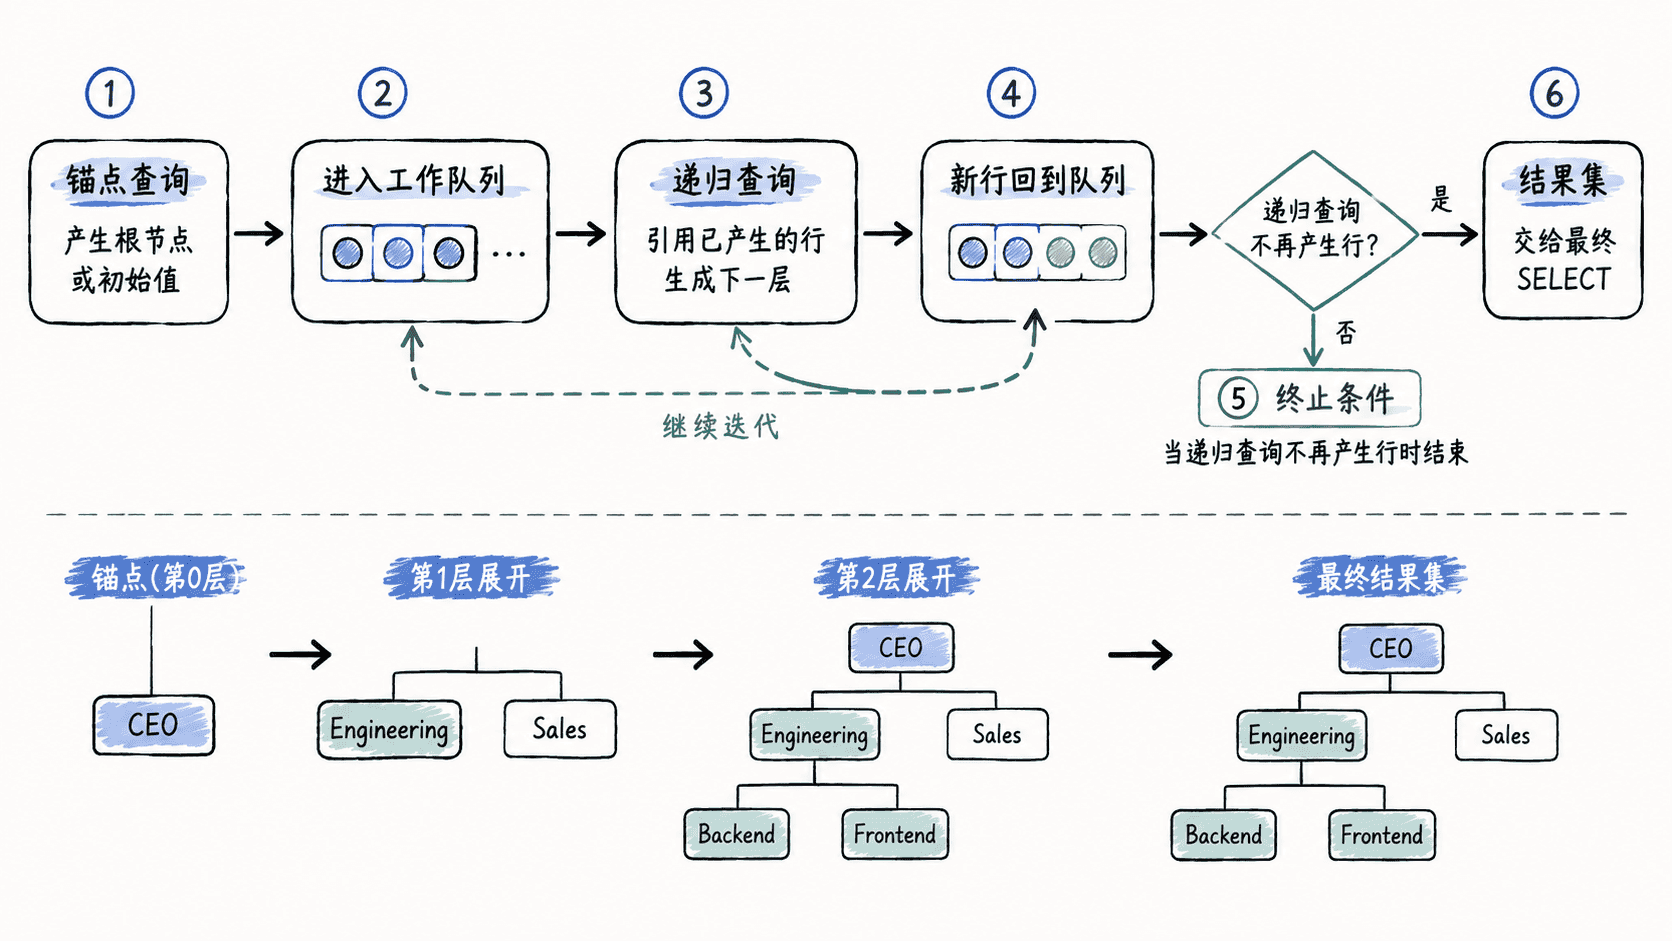
为了明确表示递归查询,通常写成 WITH RECURSIVE,并让 CTE 名称出现在递归成员中。树形查询常用父子键连接;序列查询则让下一行由当前值计算得到。
用员工树和整数序列验证
下面的脚本先建立一棵员工层级树,再分别运行普通 CTE、递归树查询和递归序列查询。可直接在 SQLite 中执行。
DROP TABLE IF EXISTS employees;

CREATE TABLE employees (
  id INTEGER PRIMARY KEY,
  name TEXT NOT NULL,
  manager_id INTEGER REFERENCES employees(id)
);

INSERT INTO employees (id, name, manager_id) VALUES
  (1, 'CEO', NULL),
  (2, 'Engineering', 1),
  (3, 'Sales', 1),
  (4, 'Backend', 2),
  (5, 'Frontend', 2);

WITH reports AS (
  SELECT id, name
  FROM employees
  WHERE manager_id IS NOT NULL
)
SELECT COUNT(*) AS report_count
FROM reports;

WITH RECURSIVE tree(id, name, manager_id, depth, path) AS (
  SELECT id, name, manager_id, 0, name
  FROM employees
  WHERE manager_id IS NULL

  UNION ALL

  SELECT e.id, e.name, e.manager_id, tree.depth + 1,
         tree.path || ' > ' || e.name
  FROM employees AS e
  JOIN tree ON e.manager_id = tree.id
)
SELECT id, name, depth, path
FROM tree
ORDER BY path;

WITH RECURSIVE seq(n) AS (
  VALUES(1)
  UNION ALL
  SELECT n + 1
  FROM seq
  WHERE n < 5
)
SELECT group_concat(n, ',') AS numbers
FROM seq;
预期输出
4
1|CEO|0|CEO
2|Engineering|1|CEO > Engineering
4|Backend|2|CEO > Engineering > Backend
5|Frontend|2|CEO > Engineering > Frontend
3|Sales|1|CEO > Sales
1,2,3,4,5
如果客户端开启了表头或其他显示模式,排版可能不同,但行值应一致。员工树中的 depth 从 0 开始;序列在 n = 5 时停止,因为递归成员的 WHERE n < 5 已经不再生成下一行。
终止条件与重复访问
递归查询最重要的边界不是语法,而是“什么时候停止”。数值序列应有明确上界;树或图数据则要考虑脏数据造成的环。不要假设数据库会替你判断业务上的循环关系,否则错误的父子引用可能让查询不断扩展或产生大量重复行。
对可能存在环的数据,可以在递归结果中维护已访问路径,并在继续连接前排除已经出现过的节点;如果只需要固定数量的结果,也可以在递归 CTE 中使用 LIMIT 作为额外保险。UNION 会去重,但它不是通用的环检测方案,因为只要行里携带的深度、路径等列不同,同一节点仍可能再次出现。
CTE 最适合把“先算什么、再基于它算什么”写清楚;递归 CTE 则把这种依赖扩展到未知层数。写递归查询时,先确认锚点能选中正确起点,再单独验证递归连接条件和停止条件,通常比一次性调试整条 SQL 更稳妥。