
数据库原理与选型 / 系统课时
索引结构与查询加速原理
索引结构与查询加速原理
索引的价值不是“让所有查询都更快”,而是用额外存储和写入维护成本,换取更少的数据页访问。本节从 SQLite 的 B-tree 组织方式出发,再用查询计划验证一次从全表扫描到索引查找的变化。
学习目标
- 理解 SQLite 普通索引如何组织键值与行定位信息
- 使用
EXPLAIN QUERY PLAN判断查询是否利用索引 - 评估索引对读取速度、写入成本和数据库体积的影响
索引到底保存了什么
SQLite 以页为单位组织 B-tree。对普通 rowid 表,表本身按 rowid 组织;二级索引则按“索引列值 + rowid”排序。查询先在索引 B-tree 中定位匹配项,再根据 rowid 回到表中取未包含在索引里的列。
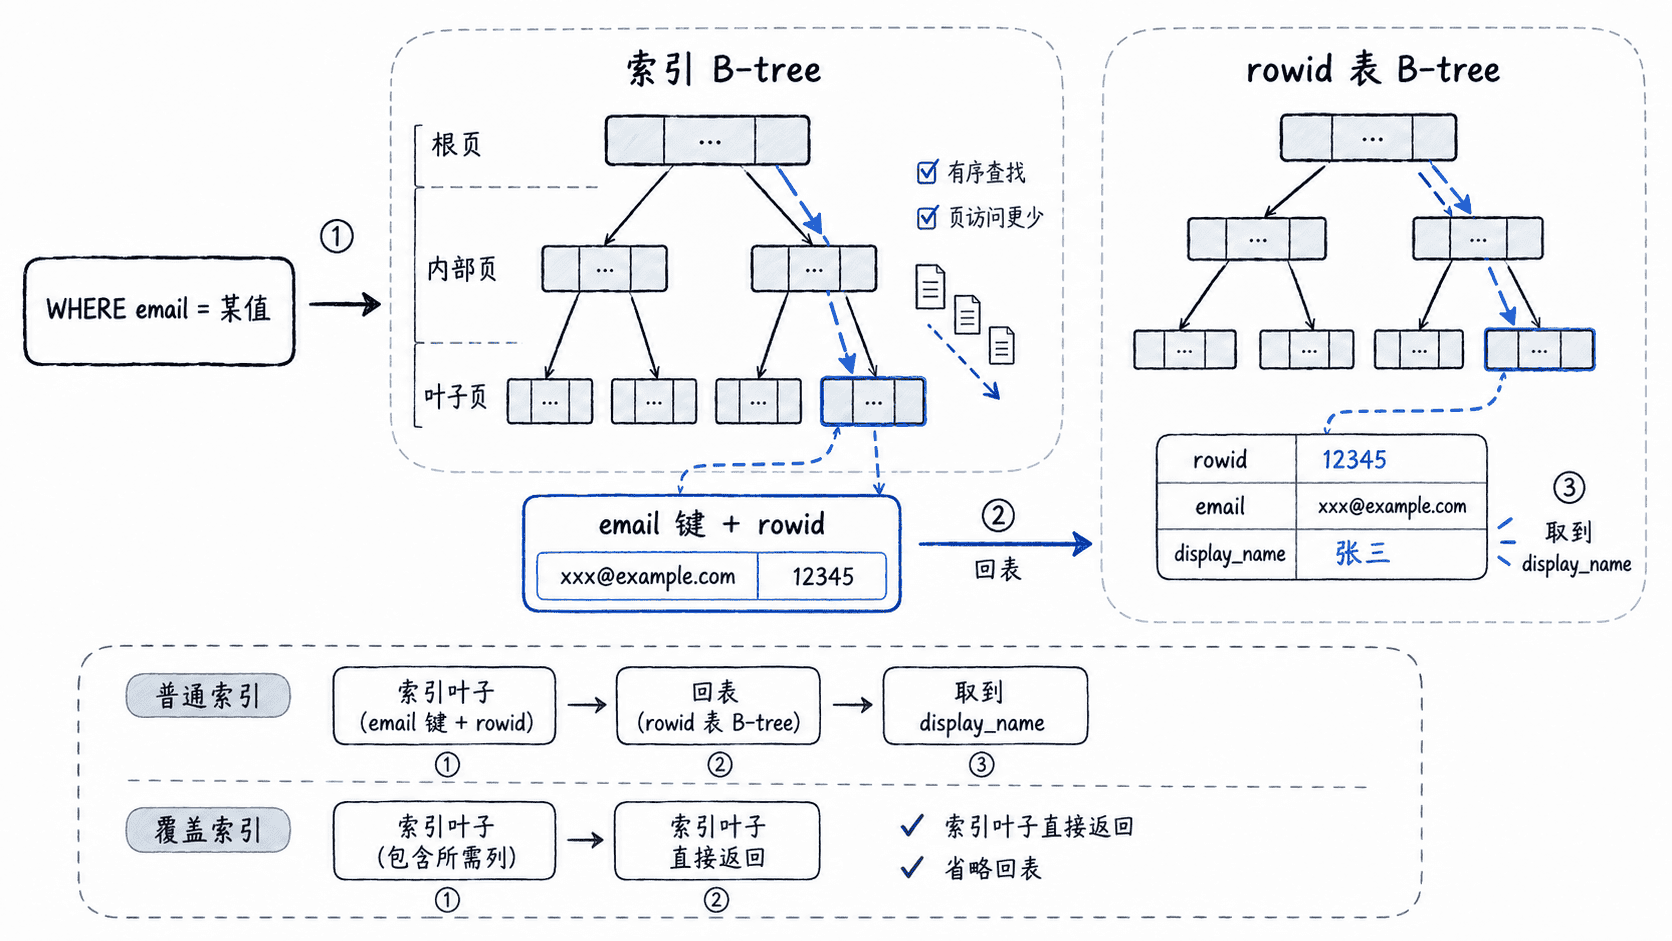
这种有序结构让等值和范围条件不必从第一行检查到最后一行。索引并不复制整张表,而是保存用于排序和定位的字段;如果查询还需要其他列,就会发生“先查索引、再查表”的第二步。若所需列都已经在索引中,SQLite 可能直接使用 covering index 返回结果。
用查询计划观察加速方式
下面先创建 10000 行测试数据并查看无索引计划,再为 email 创建索引后重复同一查询。EXPLAIN QUERY PLAN 不执行查询本身,而是告诉你优化器准备怎样访问数据。
DROP TABLE IF EXISTS users;

CREATE TABLE users (
    id INTEGER PRIMARY KEY,
    email TEXT NOT NULL,
    display_name TEXT NOT NULL
);

WITH RECURSIVE seq(n) AS (
    SELECT 1
    UNION ALL
    SELECT n + 1
    FROM seq
    WHERE n < 10000
)
INSERT INTO users(id, email, display_name)
SELECT
    n,
    printf('user%05d@example.com', n),
    printf('User %05d', n)
FROM seq;

EXPLAIN QUERY PLAN
SELECT id, display_name
FROM users
WHERE email = 'user09000@example.com';

CREATE INDEX idx_users_email ON users(email);

EXPLAIN QUERY PLAN
SELECT id, display_name
FROM users
WHERE email = 'user09000@example.com';

SELECT id, display_name
FROM users
WHERE email = 'user09000@example.com';
预期结果:
<ID>|<ID>|0|SCAN users
<ID>|<ID>|0|SEARCH users USING INDEX idx_users_email (email=?)
9000|User 09000
<ID> 是查询计划节点编号,SQLite 版本不同可能变化。关键不是编号,而是访问方式从 SCAN users 变成 SEARCH users USING INDEX idx_users_email:前者需要检查整表,后者先利用有序索引缩小候选范围。
为什么索引也会拖慢系统
每增加一个索引,SQLite 都要额外保存一棵索引 B-tree。INSERT 必须把新键插入对应索引,DELETE 要移除键,UPDATE 如果修改了索引列,还要同步删除旧键并写入新键;这些操作可能引起更多页面写入和页分裂。
因此索引的代价主要有三类:数据库文件更大、写事务工作更多、维护和分析成本增加。对写多读少的表,盲目给每列建索引可能让整体性能变差;对读多且过滤条件稳定的表,针对高频谓词建立少量索引通常更划算。
哪些查询更可能受益
索引优先服务于经常出现在 WHERE、JOIN、ORDER BY 或某些分组路径中的列,尤其是能显著缩小结果集的条件。联合索引还受列顺序影响,通常应围绕真实查询模式设计,而不是按字段重要性排序。
低选择性的条件不一定值得单独索引。例如一个只有“启用/停用”两种值的列,即使建了索引,查询大量匹配行时优化器仍可能认为扫描整表更便宜。最终判断应以 EXPLAIN QUERY PLAN 和真实数据上的耗时、读页数量为准。
还要区分显式索引与约束产生的自动索引:UNIQUE 以及某些主键约束会让 SQLite 创建内部索引,而 INTEGER PRIMARY KEY 在普通 rowid 表中直接作为 rowid 的别名,通常不需要再为同一列建立重复索引。索引真正有效的前提,是它对应了实际查询路径,而不是仅仅“存在”。