
数据库原理与选型 / 系统课时
SQLite 与 MySQL 等数据库的区别
SQLite 与 MySQL 等数据库的区别
SQLite 与 MySQL、PostgreSQL 都能执行 SQL,但它们首先是两种不同的部署架构:SQLite 把数据库引擎嵌入应用并直接读写文件,而客户端服务器数据库通过网络访问独立服务。这个差异会进一步影响并发、运维、权限与扩展方式。
学习目标
- 区分嵌入式数据库与客户端服务器数据库的访问链路
- 从部署、并发、运维和扩展角度比较两类方案
- 能根据应用边界判断何时优先选择 SQLite
两种架构的根本差异
SQLite 的调用链路通常是“应用 → SQLite 库 → 数据库文件”。SQL 在应用进程内执行,数据库文件由 SQLite 通过操作系统文件接口直接读写。
MySQL、PostgreSQL 等客户端服务器数据库的链路则是“应用 → 网络协议 → 数据库服务器 → 数据文件”。应用只负责发送请求,连接管理、权限校验、查询执行和数据文件访问都由独立服务器进程承担。
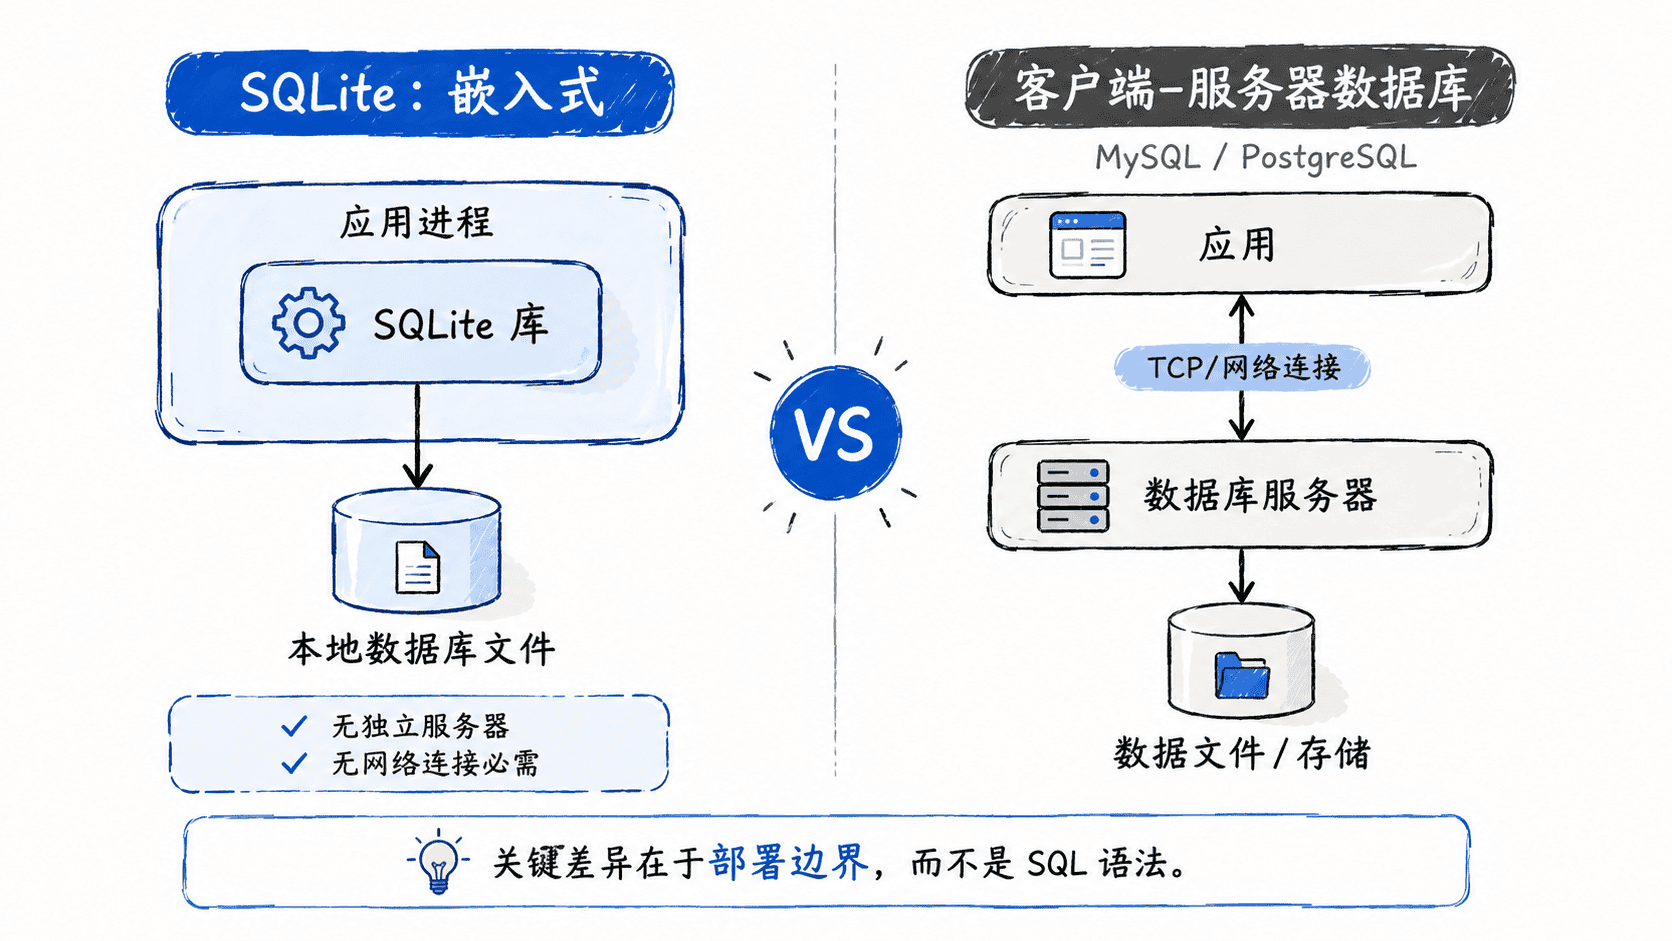
部署、并发、运维和扩展差异
| 维度 | SQLite | MySQL / PostgreSQL 等 |
|---|---|---|
| 部署 | 库随应用使用,打开文件即可工作 | 需要独立数据库服务 |
| 连接 | 通常以本地文件路径为边界 | 通常需要主机、端口、账号和网络 |
| 并发 | 多读友好,写事务需要串行协调 | 更适合大量并发连接与并发写入 |
| 运维 | 备份与迁移相对简单,服务器运维少 | 需要实例、账号、备份、监控与升级管理 |
| 权限 | 主要依赖应用逻辑和文件系统权限 | 通常有服务端用户、角色与授权体系 |
| 扩展 | 适合单机、嵌入式和边缘场景 | 更适合集中服务、高可用与横向扩展方案 |
并发差异尤其容易被误解。SQLite 并不是“只能一个用户使用”,多个连接可以同时读取;真正的约束是写事务需要协调,单个数据库文件的写入吞吐不会像专用服务器数据库那样通过服务端并发架构扩展。
运维差异也来自架构边界。SQLite 没有独立服务进程,因此少了服务发现、端口暴露和服务器账号管理,但数据库文件的备份时机、文件权限、磁盘可靠性仍然需要认真处理。
用 SQLite 观察连接边界
下面的命令创建本地数据库,并通过 PRAGMA database_list 查看当前连接实际打开的文件。整个过程不需要主机名、端口或数据库服务器账号。
rm -f local.db
sqlite3 local.db <<'SQL'
CREATE TABLE item(id INTEGER PRIMARY KEY, name TEXT NOT NULL);
INSERT INTO item(name) VALUES ('local connection');
SELECT id, name FROM item;
PRAGMA database_list;
SQL
预期输出
1|local connection
0|main|<PATH>/local.db
<PATH> 会因当前工作目录而不同。这个结果体现了 SQLite 的连接边界:连接目标就是本地数据库文件;而访问 MySQL 或 PostgreSQL 时,连接目标通常是一个远程或本机数据库服务地址。
如何选择
如果数据库只服务于一个应用实例或一台设备,希望部署简单、离线可用、无需维护独立数据库服务,SQLite 往往是优先选择。桌面程序、移动应用、测试工具和轻量单机服务都符合这一模式。
如果多个应用实例需要通过网络共享同一数据源,系统存在高并发写入、集中权限管理、高可用、复制或扩展要求,则应优先考虑 MySQL、PostgreSQL 等客户端服务器数据库。
两类数据库并不是简单的“低级版”和“高级版”关系。SQLite 把数据库能力收进应用边界,客户端服务器数据库把数据库能力独立成服务;先确定系统边界,再选择数据库,通常比只根据数据量做决定更可靠。