
数据库原理与选型 / 系统课时
FTS5 全文检索基础
FTS5 全文检索基础
当文本列变长、搜索条件从“完全相等”变成“包含多个词并按相关性排序”时,普通 LIKE '%词%' 很快会遇到性能和表达能力瓶颈。本课用 FTS5 建立全文索引,完成 MATCH 查询,并说明分词、排名与原表同步的关键边界。
学习目标
- 创建 FTS5 虚拟表并写入可检索文本。
- 使用
MATCH完成全文查询,理解分词器与相关性排名。 - 区分独立 FTS 表与外部内容表,知道何时需要同步机制。
FTS5 解决的不是普通索引问题
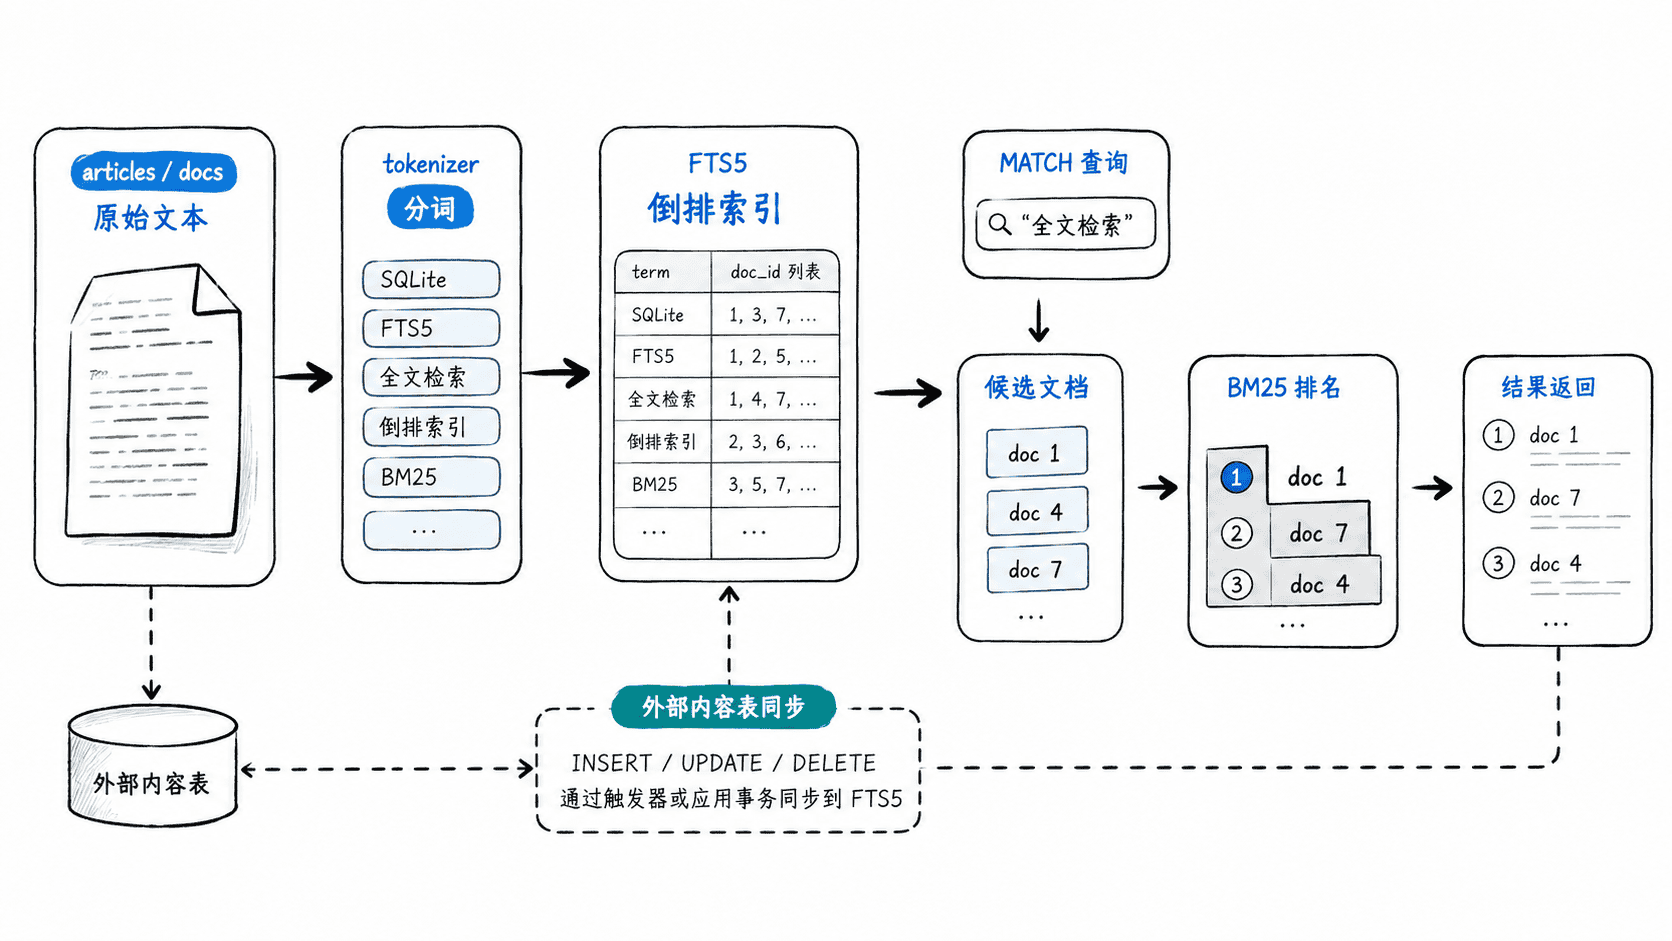
普通 B-tree 索引擅长等值、范围和前缀条件,却不能高效回答“正文中包含哪些词”。FTS5 会把文本交给 tokenizer 切成 token,再建立“词项 → 文档”的倒排索引。查询时先定位词项对应的文档集合,再做布尔组合、短语匹配或排名,而不是逐行扫描整段文本。
创建虚拟表并执行 MATCH
下面的示例直接让 FTS5 保存文本,适合先理解基本行为。tokenize='unicode61' 是常用的 Unicode 分词器;英文单词会按词切分,大小写等细节由 tokenizer 规则处理。
CREATE VIRTUAL TABLE docs_fts USING fts5(
  title,
  body,
  tokenize = 'unicode61'
);

INSERT INTO docs_fts(rowid, title, body) VALUES
  (1, '全文检索', 'sqlite search search search'),
  (2, '普通搜索', 'sqlite search'),
  (3, '索引基础', 'b-tree range query');

SELECT rowid, title
FROM docs_fts
WHERE docs_fts MATCH 'sqlite AND search'
ORDER BY rowid;
预期结果
rowid  title
-----  --------
1      全文检索
2      普通搜索
MATCH 不是字符串包含判断,而是 FTS5 查询语法入口。它可以组合词项、短语、前缀和布尔条件。只有进入 FTS5 索引的列才能参与这种检索;对普通表直接写 MATCH 不会自动获得全文索引能力。
分词与排名决定“搜到什么”和“谁排前面”
tokenizer 决定文本如何切词,因此它会直接影响召回结果。unicode61 对英文和多数以空白或标点分隔的文本很合适,但对中文这类没有天然空格边界的语言,默认切分方式未必符合业务期望。可根据场景评估 trigram 或自定义 tokenizer,但三元组索引通常会增加索引体积。
FTS5 内置 BM25 相关性计算。可以使用隐藏列 rank 或 bm25() 排序;相关性受词频、文档长度等因素影响。只需要结果顺序时,优先写 ORDER BY rank,不要把 BM25 数值当作跨数据集稳定的业务分数。
SELECT rowid, title
FROM docs_fts
WHERE docs_fts MATCH 'search'
ORDER BY rank;
预期结果
rowid  title
-----  --------
1      全文检索
2      普通搜索
在这组固定样例中,第一行对 search 的词频更高,因此排在前面。真实数据的排序还会受文档长度和全库统计量影响,具体分值可能不同。
原表与 FTS 索引必须保持一致
如果业务只维护一个 FTS5 虚拟表,文本和索引由同一对象管理,最简单但会把搜索结构当作主存储。更常见的是保留业务表,再建立 content='articles' 的 external-content FTS5 表。此时 FTS5 引用原表内容,但不会替你自动同步历史和后续变更。
新增 external-content 索引后,应先用 rebuild 建立现有数据的索引;之后对原表的 INSERT、UPDATE、DELETE 需要通过触发器,或在同一应用事务中同步更新 FTS 表。若只建虚拟表却没有同步策略,查询结果会逐渐与原表事实不一致。
FTS5 适合标题、正文、说明等自然语言字段;精确 ID、金额、时间范围仍应交给普通列和 B-tree 索引。实际查询通常是“结构化条件先缩小业务范围,再用 FTS5 处理文本相关性”,而不是用全文索引替代所有索引。