
数据库原理与选型 / 系统课时
窗口函数与排名统计
窗口函数与排名统计
本课解决“既要保留明细行,又要计算组内排名、累计值和分组汇总”的问题。完成后,你可以用窗口函数生成每位员工的部门排名、部门平均工资和累计工资,而不必把明细压缩成一行。
学习目标
- 理解
OVER、PARTITION BY与窗口排序的作用 - 掌握
ROW_NUMBER、RANK和DENSE_RANK的区别 - 使用聚合窗口函数计算组内平均值和累计值
准备示例数据
窗口函数从 SQLite 3.25.0 开始得到支持,请先确认数据库版本符合要求。下面创建员工表并写入可重复执行的测试数据,包含两个部门和研发部两名工资相同的员工,用于观察并列排名。
DROP TABLE IF EXISTS employees;

CREATE TABLE employees (
    id INTEGER PRIMARY KEY,
    name TEXT NOT NULL,
    department TEXT NOT NULL,
    salary INTEGER NOT NULL
);

INSERT INTO employees (id, name, department, salary) VALUES
(1, '张三', '研发部', 12000),
(2, '李四', '研发部', 15000),
(3, '王五', '研发部', 15000),
(4, '赵六', '市场部', 10000),
(5, '钱七', '市场部', 13000);

-- 验证测试数据已完整写入
SELECT COUNT(*) AS row_count FROM employees;
预期输出
5建表和插入语句在 SQLite 命令行中默认不返回结果集,最后的查询应返回 5。后续查询结果以带列名的表格形式展示,不同客户端的列宽可能不同。
使用排名窗口函数
普通 GROUP BY 会将同一组的多行聚合为一行,而窗口函数通过 OVER (...) 指定计算范围,并保留每条明细记录。PARTITION BY department 先按部门分区,窗口内部的 ORDER BY salary DESC 再决定每个分区内的排名顺序。
下面同时计算三种排名。ROW_NUMBER 增加 id 作为同工资员工的排序依据,以保证编号稳定;另外两个函数只按工资排序,让相同工资获得相同名次。
SELECT
    name,
    department,
    salary,
    ROW_NUMBER() OVER (
        PARTITION BY department
        ORDER BY salary DESC, id
    ) AS row_no,
    RANK() OVER (
        PARTITION BY department
        ORDER BY salary DESC
    ) AS rank_no,
    DENSE_RANK() OVER (
        PARTITION BY department
        ORDER BY salary DESC
    ) AS dense_rank_no
FROM employees
ORDER BY department, row_no;
预期输出
name  department  salary  row_no  rank_no  dense_rank_no
----  ----------  ------  ------  -------  -------------
钱七  市场部       13000   1       1        1
赵六  市场部       10000   2       2        2
李四  研发部       15000   1       1        1
王五  研发部       15000   2       1        1
张三  研发部       12000   3       3        2
ROW_NUMBER 始终连续编号;RANK 遇到并列会跳号;DENSE_RANK 遇到并列但不会跳号。研发部的李四和王五工资相同,因此两人的 RANK 都是 1,张三的名次跳到 3;DENSE_RANK 则依次为 1、1、2。
需要唯一序号时选 ROW_NUMBER,需要竞赛名次时通常选后两者。如果给 RANK 的窗口排序也追加唯一的 id,相同工资就不再被视为并列,这是排名查询中常见的错误。
还要区分两个排序位置:OVER 内部的 ORDER BY 决定窗口计算顺序,查询末尾的 ORDER BY 决定最终结果展示顺序。两者可以不同。
使用聚合窗口函数
聚合函数加上 OVER 后,可以在保留明细的同时返回分组统计值。AVG(salary) OVER (PARTITION BY department) 为部门中的每个员工返回相同的平均工资,不需要再通过子查询连接汇总表。
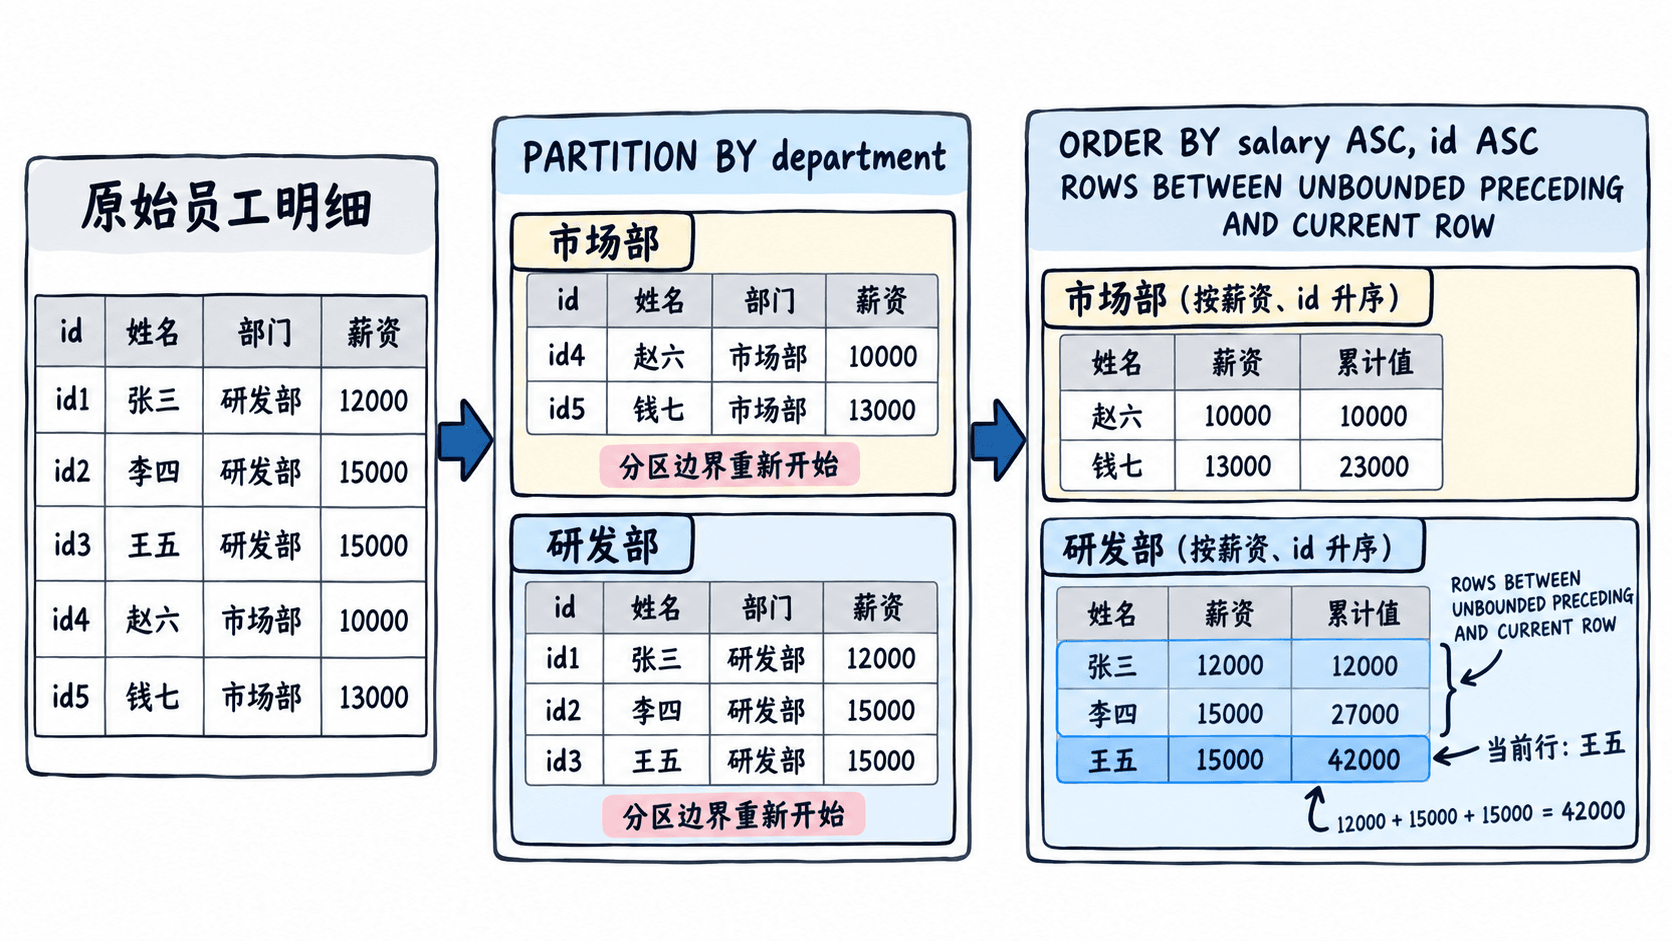
累计工资还需要确定组内顺序和窗口帧。下面按工资升序排列,同工资时按 id 排列,并将当前行及此前所有行的工资相加。
SELECT
    name,
    department,
    salary,
    ROUND(AVG(salary) OVER (
        PARTITION BY department
    ), 2) AS dept_avg,
    SUM(salary) OVER (
        PARTITION BY department
        ORDER BY salary, id
        ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
    ) AS running_total
FROM employees
ORDER BY department, salary, id;
预期输出
name  department  salary  dept_avg  running_total
----  ----------  ------  --------  -------------
赵六  市场部       10000   11500.0   10000
钱七  市场部       13000   11500.0   23000
张三  研发部       12000   14000.0   12000
李四  研发部       15000   14000.0   27000
王五  研发部       15000   14000.0   42000
市场部平均工资为 (10000 + 13000) / 2 = 11500,研发部平均工资为 (12000 + 15000 + 15000) / 3 = 14000。平均值覆盖整个部门分区,因此同部门每一行的 dept_avg 相同。
累计值则随行变化。研发部张三的累计值是 12000,李四是 27000,王五是 42000。进入另一个部门后,累计值重新从该部门第一行开始计算,不会跨部门相加。
显式写出 ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW,可以清楚表达“从分区第一行累计到当前行”,也能避免默认窗口范围带来的理解偏差。这里的 ROWS 按实际行数确定窗口范围,而不是把相同排序值的行自动作为一组。
验证窗口范围与处理并列值
可以用已知结果检查三个关键行为:研发部最高工资的两人并列排名第一;研发部平均工资在三行中都是 14000;研发部最后一行累计工资等于该部门工资总额 42000。如果任一结果不符合预期,优先检查分区字段、排序字段和窗口帧定义。
容易忽略的边界还有以下几项:
- 省略
PARTITION BY:所有员工构成同一个分区,平均值和累计值不再按部门分别计算。 - 并列工资缺少稳定排序:
ROW_NUMBER或逐行累计查询如果只按工资排序,并列行的先后顺序可能变化;需要确定顺序时追加唯一字段。 - 省略累计窗口的
ROWS:SQLite 在窗口含ORDER BY时,默认使用以当前排序值为界的RANGE帧,同一排序值的行可能一起纳入累计范围。默认帧与显式逐行累计并不总是等价。 - 空值参与统计:
AVG和SUM忽略NULL,但ROW_NUMBER仍会给对应记录编号。真实业务需要明确空工资如何处理。
一个直接的验证方法是保持查询其他部分不变,暂时删除累计窗口中的 id 排序字段和显式 ROWS 子句。研发部两个工资为 15000 的员工会因默认 RANGE 帧而同时得到累计值 42000;恢复原写法后,累计值重新变成 27000 和 42000。
实际选择时,唯一行号使用 ROW_NUMBER,保留并列名次使用 RANK 或 DENSE_RANK,分组统计使用聚合函数配合 OVER。需要逐条累计时,明确写出稳定排序和 ROWS 范围,才能让结果符合业务定义。