
数据库原理与选型 / 系统课时
锁状态与 database is locked
锁状态与 database is locked
database is locked 并不表示数据库损坏,而是某个连接在规定等待时间内拿不到所需写锁。本课从回滚日志模式的锁状态出发,复现一次真实冲突,并用 busy_timeout、事务边界和定位顺序把短暂竞争与长期阻塞区分开。
学习目标
- 说清共享锁、保留锁与排他锁在读写事务中的作用
- 复现并解释
database is locked,判断哪个连接正在阻塞写入 - 正确使用
busy_timeout缓冲短暂竞争,并知道何时应缩短事务而不是继续加等待
锁冲突从哪里产生
在传统回滚日志模式中,读事务通常持有 SHARED(共享)锁,多个读者可以同时存在。写事务开始修改前会取得 RESERVED(保留)锁,表示“我准备写”,此时已有读者仍可继续读取,而且新的共享锁通常仍可进入。
真正把修改写回主数据库文件前,写者必须走向 EXCLUSIVE(排他)锁。SQLite 还会短暂经过 PENDING 状态,用来阻止新的共享锁进入,等待现有读者退出。若目标锁在等待窗口内始终不可用,调用方就会收到 SQLITE_BUSY;Python 的 sqlite3 常把它表现为 database is locked。
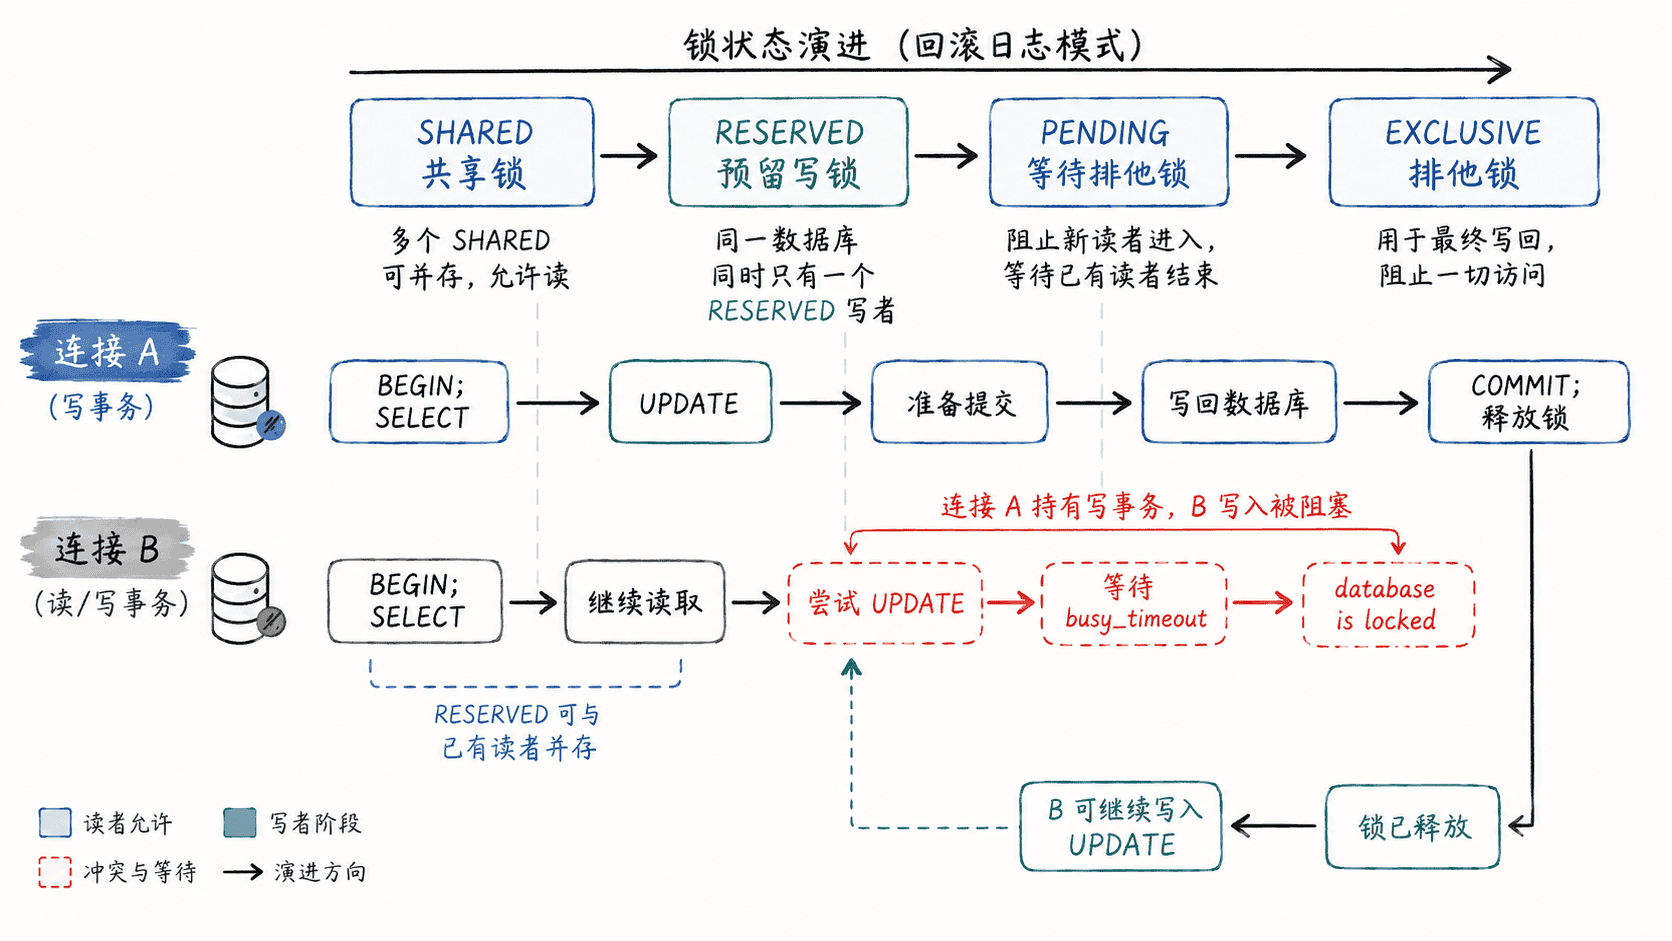
BEGIN IMMEDIATE 很适合演示这个区别:它在事务开始时就申请写事务所需的锁,而不是等到第一次写语句才升级。这样可以更早暴露“另一个写者正在占用数据库”的问题。
复现一次 database is locked
下面的完整 Python 示例创建两个连接。连接 A 开启 BEGIN IMMEDIATE 并更新但不提交;连接 B 此时仍能读取旧值,但第二个写入会在 200 毫秒等待后失败。A 提交后,B 再写即可成功。
import sqlite3
from pathlib import Path

db_path = Path("lock-demo.db")
db_path.unlink(missing_ok=True)

a = sqlite3.connect(db_path, isolation_level=None)
b = sqlite3.connect(db_path, isolation_level=None)

a.execute("PRAGMA journal_mode=DELETE;")
for conn in (a, b):
    # busy_timeout 的单位是毫秒,并且按连接分别设置。
    conn.execute("PRAGMA busy_timeout=200;")

a.executescript(
    """
    CREATE TABLE counter(
        id INTEGER PRIMARY KEY,
        value INTEGER NOT NULL
    );
    INSERT INTO counter(id, value) VALUES(1, 0);
    """
)

a.execute("BEGIN IMMEDIATE;")
a.execute("UPDATE counter SET value = value + 1 WHERE id = 1;")

print(
    "B read while A writes =",
    b.execute("SELECT value FROM counter WHERE id = 1;").fetchone()[0],
)

try:
    b.execute("UPDATE counter SET value = value + 1 WHERE id = 1;")
except sqlite3.OperationalError as exc:
    print("B failed:", exc)

a.commit()

# A 释放写锁后,B 的写入可以正常完成。
b.execute("UPDATE counter SET value = value + 1 WHERE id = 1;")
print(
    "final value =",
    b.execute("SELECT value FROM counter WHERE id = 1;").fetchone()[0],
)

a.close()
b.close()
db_path.unlink(missing_ok=True)
预期输出:
B read while A writes = 0
B failed: database is locked
final value = 2
这里最关键的现象不是“读也失败”,而是 一个写者可以和读者共存一段时间,但第二个写者不能同时进入写事务。busy_timeout 只让 SQLite 在返回 SQLITE_BUSY 前多等一会儿,不会把两个写事务变成真正并行。
按证据定位阻塞来源
遇到锁错误时,先确认它是偶发竞争还是持续占锁。优先检查应用中是否存在“开启事务后做网络请求、用户交互、批量计算,再很晚才提交”的路径;这类逻辑会把数据库锁持有时间拉得远高于 SQL 本身的执行时间。
其次检查所有连接是否都能走到 COMMIT 或 ROLLBACK。异常分支、提前返回和连接池复用都可能让事务比预期活得更久。对于 CLI 或脚本,也要确认不是另一个终端仍停留在未提交事务中。
用最小改动修复并验证
修复顺序通常是:先缩短写事务,把非数据库工作移到事务外;再确保所有成功和失败路径都显式结束事务;最后才设置合理的 busy_timeout 处理瞬时竞争。若业务本身是“读多写少”,还可以评估 WAL 模式来降低读写互相阻塞,但 WAL 仍然只允许一个写者。
验证时不要只看“错误消失”,还要重复制造并发写入,确认等待时间可控、最终数据正确,并观察是否仍有某个请求长期占用写事务。能在短等待后成功,和因为锁被永久占住而沉默等待,是两种完全不同的健康状态。