
PostgreSQL / 系统课时
形成 JSONB 治理方案
形成 JSONB 治理方案
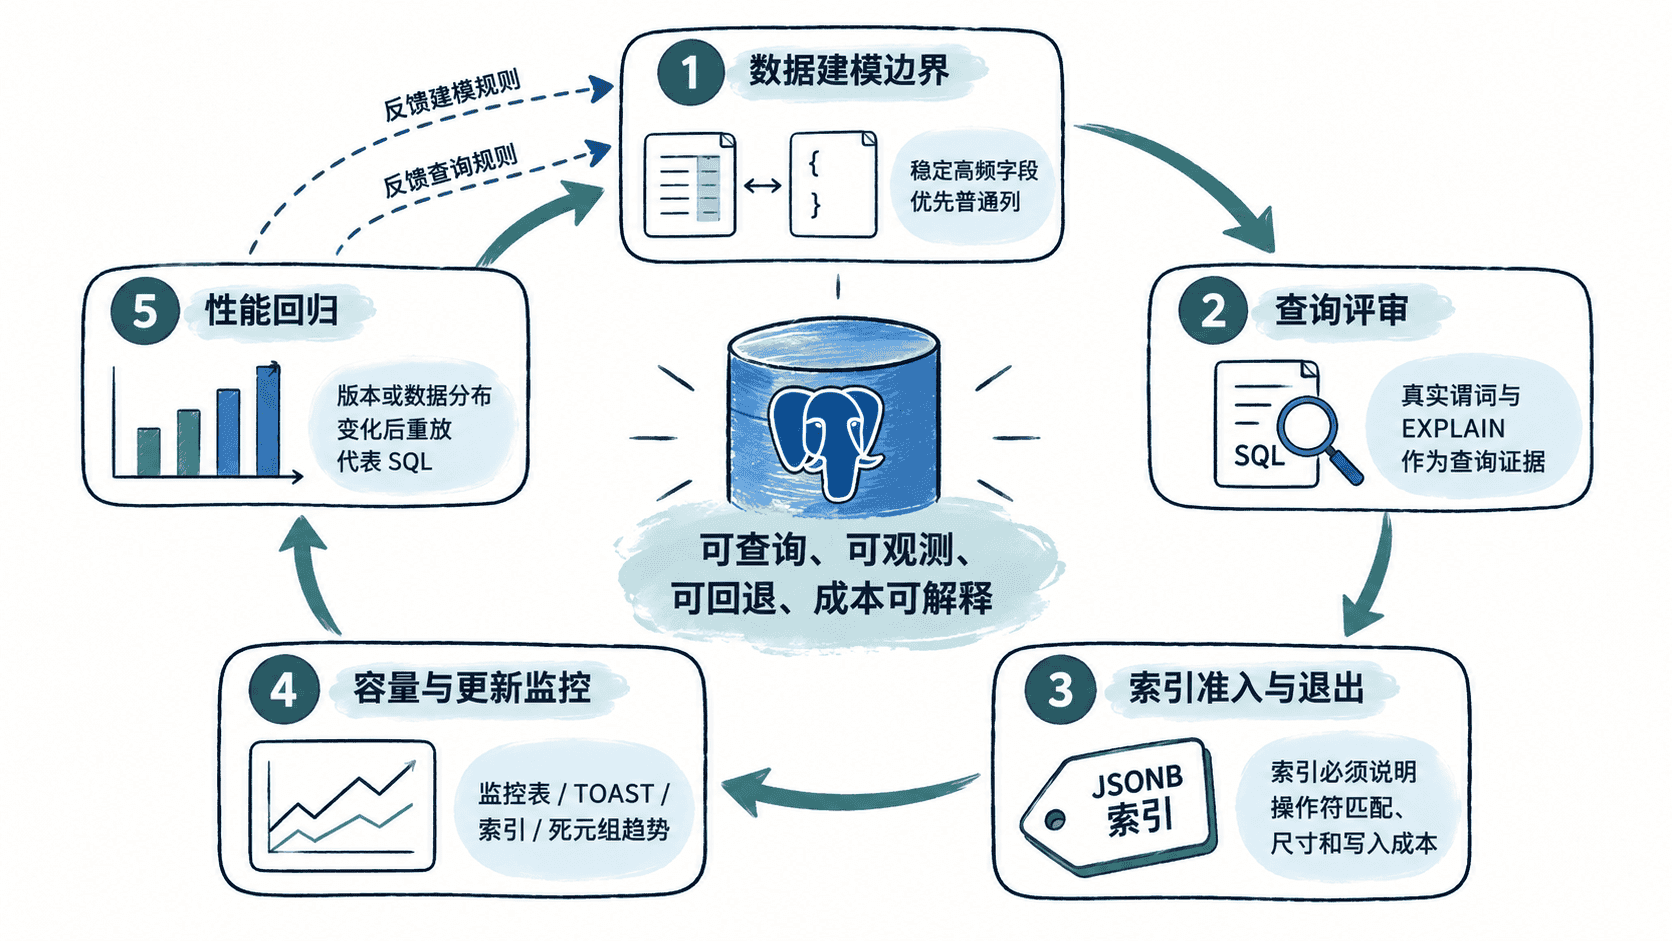
JSONB 治理不能停留在“发现慢 SQL 再加索引”。本课把数据建模、查询评审、索引准入、容量监控和性能回归连成一套可执行门禁,让 JSONB 的灵活性不会演变成长期性能与维护负担。
学习目标
- 为普通列与 JSONB 属性划定可执行的数据建模边界。
- 用真实查询和执行计划建立索引准入、观察与退出规则。
- 把容量趋势和性能回归纳入发布流程,形成持续治理闭环。
先定义数据建模边界
治理的第一道门不是索引,而是决定哪些数据应该进入 JSONB。稳定、经常参与连接、唯一约束、外键、排序或范围过滤的字段,应优先保留为普通列;变化频繁、不同对象拥有不同键集合、主要作为扩展属性整体读写的数据,更适合进入 JSONB。
业务身份、完整性约束和高频访问路径使用关系型列;低频、结构不稳定的扩展属性进入 JSONB。不能因为“以后可能变化”就把整行都塞进 JSONB。 这条规则既保留扩展能力,也让关键约束和访问路径继续得到 PostgreSQL 关系模型的直接支持。
如果某个 JSONB 键逐渐变成高频筛选、排序或范围条件,可以先为固定路径建立精准的表达式索引;当字段语义和访问模式长期稳定后,再评估迁移为普通列。治理应允许这种渐进演进,而不是在“全部 JSONB”和“一次性重构”之间二选一。
把真实查询变成索引准入证据
索引申请必须带着代表业务负载的真实谓词进入评审,而不是只写“给 payload 加 GIN”。假设前文实验表 jsonb_events_lab 已存在,可以先保存代表查询,再用执行计划核对过滤、排序、实际行数与缓冲区访问。
EXPLAIN (ANALYZE, BUFFERS)
SELECT id, occurred_at
FROM jsonb_events_lab
WHERE payload @> '{"status":"failed"}'::jsonb
ORDER BY occurred_at DESC
LIMIT 50;
预期结果
Limit  (... actual time=<TIME> ...)
  ->  Sort  (... actual time=<TIME> ...)
        Sort Key: occurred_at DESC
        ->  <PLAN_NODE>  (... actual time=<TIME> ... rows=<VALUE> ...)
Planning Time: <TIME> ms
Execution Time: <TIME> ms
<PLAN_NODE> 可能是 Seq Scan、Bitmap Heap Scan、Index Scan 等合法扫描节点,实际计划取决于选择性、数据规模、统计信息、已有索引和成本估算。验收目标不是禁止顺序扫描,而是确认当前访问路径能够被数据分布、成本估算和业务性能基线解释。对小表、低选择性谓词或需要读取大量行的查询,Seq Scan 完全可能是成本更低的正确计划。
对于以 @> 为主的包含查询,可以评估 jsonb_path_ops GIN;如果查询还依赖 ?、?| 等操作符,则要核对默认 jsonb_ops 是否更符合操作符集合。固定路径的等值、排序和范围访问通常更适合表达式 B-tree 索引,不能只按“哪个索引更小”决定类型。
维护索引资产台账
治理还需要回答“现在有哪些索引、占多大、是否持续产生查询收益”。下面的查询可以定期导出目标表的索引尺寸和累计扫描次数,为新增、保留或退出决策提供基础数据。
SELECT
    i.schemaname,
    i.relname AS table_name,
    i.indexrelname AS index_name,
    pg_size_pretty(pg_relation_size(i.indexrelid)) AS index_size,
    i.idx_scan
FROM pg_stat_user_indexes AS i
WHERE i.schemaname = 'public'
  AND i.relname = 'jsonb_events_lab'
ORDER BY pg_relation_size(i.indexrelid) DESC;
预期结果
 schemaname |    table_name     |      index_name      | index_size | idx_scan
------------+-------------------+----------------------+------------+---------
 public     | jsonb_events_lab  | <VALUE>              | <VALUE>    | <VALUE>
idx_scan 是统计周期内的累计值,不能看到零就立即删除索引。应结合统计重置时间、完整业务周期、主备角色和查询样本判断;主键、唯一约束等索引即使读取次数很少,也承担数据完整性职责。
索引退出同样需要门禁:先确认没有约束依赖,再覆盖足够长的业务周期观察使用情况,结合 pg_stat_statements 或应用侧查询记录检查潜在依赖,最后在具备回滚方案的变更窗口执行。治理目标不是索引越少越好,而是每个索引都有可说明的收益和维护成本。
监控容量与更新压力
JSONB 较大时,主表堆大小并不能代表全部存储成本,还要同时观察 TOAST、索引和死元组趋势。下面的查询把这些指标放到同一视图中;其中 TOAST 尺寸包含对应 TOAST 关系及其索引。
SELECT
    pg_size_pretty(pg_relation_size(c.oid)) AS heap_size,
    pg_size_pretty(
        CASE
            WHEN c.reltoastrelid = 0 THEN 0
            ELSE pg_total_relation_size(c.reltoastrelid)
        END
    ) AS toast_size,
    pg_size_pretty(pg_indexes_size(c.oid)) AS indexes_size,
    pg_size_pretty(pg_total_relation_size(c.oid)) AS total_size,
    s.n_live_tup,
    s.n_dead_tup,
    s.n_tup_upd
FROM pg_class AS c
JOIN pg_namespace AS n ON n.oid = c.relnamespace
JOIN pg_stat_user_tables AS s ON s.relid = c.oid
WHERE n.nspname = 'public'
  AND c.relname = 'jsonb_events_lab';
预期结果
 heap_size | toast_size | indexes_size | total_size | n_live_tup | n_dead_tup | n_tup_upd
-----------+------------+--------------+------------+------------+------------+----------
 <VALUE>   | <VALUE>    | <VALUE>      | <VALUE>    | <VALUE>    | <VALUE>    | <VALUE>
这些统计值更适合看连续趋势,而不是用一次采样直接判定故障。应重点关注总尺寸增长速率、TOAST 占比变化、死元组长期不回落,以及更新量基本不变时某个 GIN 索引仍异常膨胀等现象,再结合业务发布、批量更新和 autovacuum 状态解释原因。
把性能回归放进发布门禁
JSONB 查询性能会受到数据分布、键基数、文档尺寸、统计信息和 PostgreSQL 版本变化影响,因此“索引建好后永久有效”不是可靠假设。重要模型变更、索引变更、版本升级或大规模数据迁移后,都应在规模接近生产的数据集上重放代表 SQL,并比较同一环境的前后结果。
回归记录至少保留执行时间、返回行数、实际扫描行数、主要访问路径和缓冲区访问。门禁判断的是计划是否可解释且满足业务基线:即使出现 Seq Scan,只要选择性和成本证明它合理,并且延迟、资源消耗没有超出基线,就不应判为失败;反之,即使使用了索引,若随机访问、回表或排序导致整体成本明显恶化,也需要阻止发布。
可执行的验收条件包括:核心查询延迟不超过团队基线允许的回归范围;实际扫描量与返回量的变化能够解释;访问路径变化能由选择性、成本和统计信息说明;新增索引尺寸和写入放大仍在容量预算内;删除索引后没有关键负载退化。具体阈值应来自自身历史数据,而不是照搬固定百分比。
固化治理清单
最终方案应让开发、DBA 和平台团队在同一套规则下工作,而不是依靠个人记忆维护最佳实践。生产门禁可以固定为以下五类检查:
- 建模评审确认业务身份、约束字段和稳定高频访问字段没有无理由藏入 JSONB。
- 查询评审提交代表 SQL、操作符、选择性与
EXPLAIN (ANALYZE, BUFFERS)证据,并解释实际访问路径。 - 索引变更说明索引类型、目标谓词、预计尺寸、写入成本、创建方式与回滚方式。
- 运行监控持续采集总关系尺寸、TOAST、索引、死元组、更新量和关键查询延迟趋势。
- 发布与升级重放代表查询,把计划变化、性能基线和容量影响作为验收记录长期保存。
这套方案的核心不是限制 JSONB,而是给灵活性建立成本边界:重要查询必须可解释,索引必须有收益依据,容量增长必须能追溯来源,每次变更都要用回归数据证明没有把当前便利转化为未来的性能债务。