
PostgreSQL / 系统课时
注入慢查询与膨胀问题
注入慢查询与膨胀问题
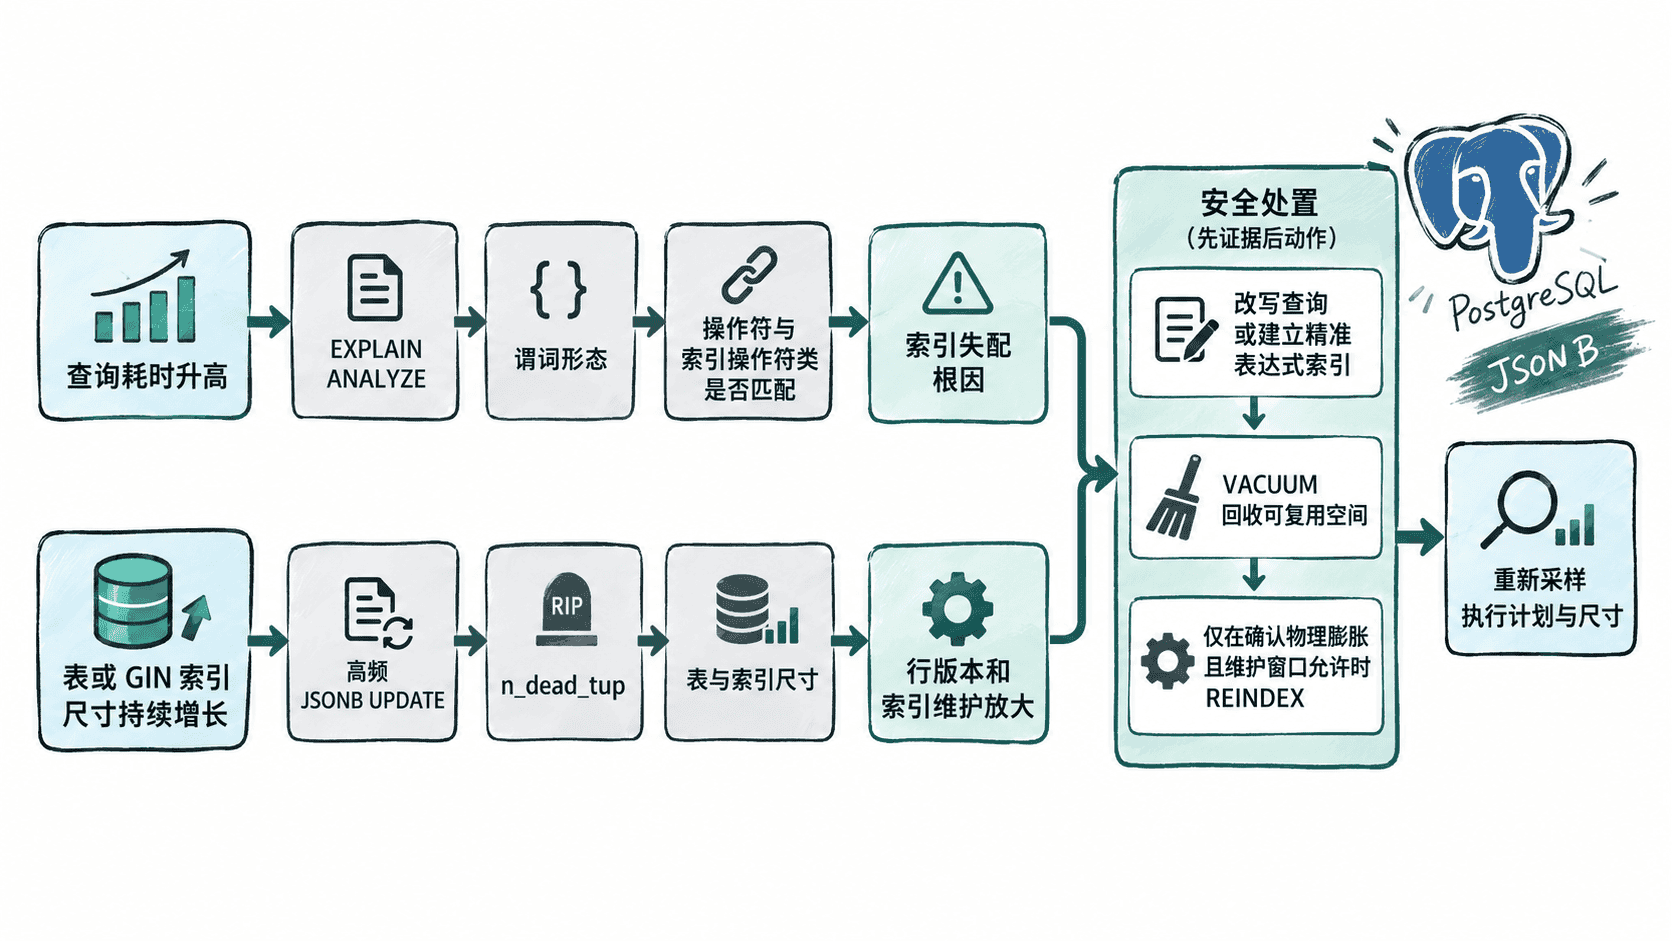
本课把 JSONB 性能问题主动注入到独立实验表中:先制造索引失配,再对固定目标集反复重写 JSONB,并记录表、GIN、TOAST、WAL 与死元组的前后差值,最后用同一组证据完成处置和复验。
学习目标
- 构造 JSONB 查询与现有索引不匹配的慢查询,并用执行计划确认问题。
- 量化高频 JSONB 更新带来的 GIN、TOAST、WAL 与死元组变化。
- 按“注入—取证—处置—复验”的顺序完成安全治理。
建立可重复的故障场景
下面只操作独立实验表。为让死元组更容易积累,暂时关闭该表的 autovacuum;这只适用于隔离实验,后面会恢复默认设置。示例使用 pgcrypto 生成 UUID。
CREATE EXTENSION IF NOT EXISTS pgcrypto;

DROP TABLE IF EXISTS jsonb_events_lab;
CREATE TABLE jsonb_events_lab (
    id uuid PRIMARY KEY DEFAULT gen_random_uuid(),
    occurred_at timestamptz NOT NULL DEFAULT now(),
    payload jsonb NOT NULL
);

INSERT INTO jsonb_events_lab (payload)
SELECT jsonb_build_object(
    'tenant', 'tenant-' || (g % 20),
    'status', CASE WHEN g % 10 = 0 THEN 'failed' ELSE 'ok' END,
    'device', jsonb_build_object(
        'os', CASE WHEN g % 3 = 0 THEN 'ios' ELSE 'android' END
    ),
    'counter', 0
)
FROM generate_series(1, 50000) AS g;

CREATE INDEX idx_jsonb_events_payload_gin
ON jsonb_events_lab USING gin (payload jsonb_path_ops);

ALTER TABLE jsonb_events_lab SET (autovacuum_enabled = false);
ANALYZE jsonb_events_lab;
预期结果
CREATE EXTENSION
DROP TABLE
CREATE TABLE
INSERT 0 50000
CREATE INDEX
ALTER TABLE
ANALYZE
如果扩展已存在,第一条命令可能附带 already exists 提示;不影响实验。
注入索引失配并确认查询形态
jsonb_path_ops 适合支持 @> 包含查询,但不会自动服务于 payload ->> 'tenant' = ... 这样的文本表达式。用同一字段执行两种谓词,可以把“查询形态与索引不匹配”和“索引失效”区分开。
EXPLAIN (ANALYZE, BUFFERS)
SELECT count(*)
FROM jsonb_events_lab
WHERE payload ->> 'tenant' = 'tenant-7';

EXPLAIN (ANALYZE, BUFFERS)
SELECT count(*)
FROM jsonb_events_lab
WHERE payload @> '{"tenant":"tenant-7"}'::jsonb;
预期结果
Aggregate  (... actual time=<TIME> ...)
  ->  Seq Scan on jsonb_events_lab  (... actual time=<TIME> ...)
        Filter: ((payload ->> 'tenant'::text) = 'tenant-7'::text)
...
Aggregate  (... actual time=<TIME> ...)
  ->  Bitmap Heap Scan on jsonb_events_lab  (... actual time=<TIME> ...)
        ->  Bitmap Index Scan on idx_jsonb_events_payload_gin
              Index Cond: (payload @> '{"tenant": "tenant-7"}'::jsonb)
...
Execution Time: <TIME> ms
具体成本、缓冲区和耗时会随环境变化;小数据集或低选择性条件下,第二条查询也可能被优化器判断为顺序扫描。判断重点是谓词是否受当前索引定义支持,以及真实负载下的扫描范围和耗时。
量化 JSONB 重写的前后差值
先把需要更新的行 ID 物化一次,后续循环只按主键集合定位,避免每轮重新对 payload ->> 'tenant' 做全表过滤。然后在更新前后采集主表、GIN、TOAST、死元组估算值和 WAL 位置,直接计算同一轮实验的增量。
CREATE TEMP TABLE jsonb_events_lab_targets AS
SELECT id
FROM jsonb_events_lab
WHERE payload ->> 'tenant' IN ('tenant-1', 'tenant-2', 'tenant-3');

ALTER TABLE jsonb_events_lab_targets ADD PRIMARY KEY (id);

SELECT count(*) AS target_rows
FROM jsonb_events_lab_targets;

CREATE TEMP TABLE jsonb_events_lab_metrics (
    phase text PRIMARY KEY,
    table_bytes bigint NOT NULL,
    gin_bytes bigint NOT NULL,
    toast_bytes bigint NOT NULL,
    dead_tup bigint NOT NULL,
    wal_lsn pg_lsn NOT NULL
);

SELECT pg_stat_clear_snapshot();

INSERT INTO jsonb_events_lab_metrics
SELECT
    'before',
    pg_relation_size('jsonb_events_lab'::regclass),
    pg_relation_size('idx_jsonb_events_payload_gin'::regclass),
    pg_total_relation_size(c.reltoastrelid::regclass),
    COALESCE(s.n_dead_tup, 0),
    pg_current_wal_lsn()
FROM pg_class AS c
LEFT JOIN pg_stat_user_tables AS s ON s.relid = c.oid
WHERE c.oid = 'jsonb_events_lab'::regclass;

DO $$
DECLARE
    i integer;
BEGIN
    FOR i IN 1..8 LOOP
        UPDATE jsonb_events_lab AS e
        SET payload = jsonb_set(
            e.payload,
            '{counter}',
            to_jsonb((e.payload ->> 'counter')::integer + 1)
        )
        FROM jsonb_events_lab_targets AS t
        WHERE e.id = t.id;
    END LOOP;
END
$$;

SELECT pg_stat_clear_snapshot();

INSERT INTO jsonb_events_lab_metrics
SELECT
    'after',
    pg_relation_size('jsonb_events_lab'::regclass),
    pg_relation_size('idx_jsonb_events_payload_gin'::regclass),
    pg_total_relation_size(c.reltoastrelid::regclass),
    COALESCE(s.n_dead_tup, 0),
    pg_current_wal_lsn()
FROM pg_class AS c
LEFT JOIN pg_stat_user_tables AS s ON s.relid = c.oid
WHERE c.oid = 'jsonb_events_lab'::regclass;

SELECT
    pg_size_pretty(a.table_bytes - b.table_bytes) AS table_delta,
    pg_size_pretty(a.gin_bytes - b.gin_bytes) AS gin_delta,
    pg_size_pretty(a.toast_bytes - b.toast_bytes) AS toast_delta,
    a.dead_tup - b.dead_tup AS dead_tup_delta,
    pg_size_pretty(pg_wal_lsn_diff(a.wal_lsn, b.wal_lsn)) AS wal_delta
FROM jsonb_events_lab_metrics AS b
JOIN jsonb_events_lab_metrics AS a ON a.phase = 'after'
WHERE b.phase = 'before';
预期结果
SELECT 7500
ALTER TABLE
 target_rows
-------------
        7500
CREATE TABLE
 pg_stat_clear_snapshot
------------------------

INSERT 0 1
DO
 pg_stat_clear_snapshot
------------------------

INSERT 0 1
 table_delta | gin_delta | toast_delta | dead_tup_delta | wal_delta
-------------+-----------+-------------+----------------+----------
<VALUE> | <VALUE> | <VALUE> | <VALUE> | <VALUE>这组差值构成“注入问题→量化影响”的证据闭环。gin_delta 反映索引维护与页增长,wal_delta 反映采样区间产生的集群级 WAL;其他会话同时写入时也会被计入,因此应在隔离环境中解释。n_dead_tup 是统计估算值而非精确计数,适合观察趋势;如果客户端把整段脚本包在一个显式事务里,应在更新提交后再采集第二组指标。
示例文档较小,toast_delta 很可能为 0 bytes,这表示数据仍主要内联,并不代表采样失败。
按根因安全处置
若业务长期使用 payload ->> 'tenant' = ...,应为这个稳定表达式建立 B-tree 表达式索引,而不是期待整列 GIN 自动覆盖所有访问方式。膨胀治理则先恢复 autovacuum,再用普通 VACUUM 清理死元组并让已有空间可复用。
CREATE INDEX idx_jsonb_events_tenant
ON jsonb_events_lab ((payload ->> 'tenant'));

ANALYZE jsonb_events_lab;

EXPLAIN (ANALYZE, BUFFERS)
SELECT count(*)
FROM jsonb_events_lab
WHERE payload ->> 'tenant' = 'tenant-7';

ALTER TABLE jsonb_events_lab RESET (autovacuum_enabled);
VACUUM (ANALYZE) jsonb_events_lab;
预期结果
CREATE INDEX
ANALYZE
Aggregate  (... actual time=<TIME> ...)
  ->  Bitmap Heap Scan on jsonb_events_lab  (... actual time=<TIME> ...)
        ->  Bitmap Index Scan on idx_jsonb_events_tenant
              Index Cond: ((payload ->> 'tenant'::text) = 'tenant-7'::text)
...
ALTER TABLE
VACUUM
计划也可能选择普通 Index Scan。真正要确认的是目标表达式已经具备可用索引路径,缓冲区访问和耗时得到改善。普通 VACUUM 会把死元组占用的空间变成可复用空间,但不会保证关系文件立即缩小;若证据表明某个索引存在长期物理膨胀,再评估 REINDEX INDEX CONCURRENTLY 的 I/O、CPU 和临时磁盘成本。
用同一组证据完成复验
处置后重新检查目标 SQL 的计划,并再次读取表、索引、TOAST 和死元组。此时不能要求所有物理尺寸都下降,而应确认查询路径已修正、死元组压力被清理或稳定,后续增长速度回到可接受范围。
SELECT
    pg_size_pretty(pg_relation_size('jsonb_events_lab'::regclass)) AS table_size,
    pg_size_pretty(pg_relation_size('idx_jsonb_events_payload_gin'::regclass)) AS gin_size,
    pg_size_pretty(pg_total_relation_size(c.reltoastrelid::regclass)) AS toast_size,
    s.n_live_tup,
    s.n_dead_tup,
    s.last_vacuum,
    s.last_autovacuum
FROM pg_class AS c
JOIN pg_stat_user_tables AS s ON s.relid = c.oid
WHERE c.oid = 'jsonb_events_lab'::regclass;
预期结果
 table_size | gin_size | toast_size | n_live_tup | n_dead_tup | last_vacuum | last_autovacuum
------------+----------+------------+------------+------------+-------------+----------------
 <VALUE>    | <VALUE>  | <VALUE>    | <VALUE>    | <VALUE>    | <TIME>      | <VALUE>
一次完整演练最终应能回答三个问题:慢查询是谓词与索引失配、选择性不足还是成本估算所致;空间和 WAL 增长来自活跃数据、行版本还是索引维护;处置动作是否直接消除了根因,同时没有引入新的锁、I/O 或磁盘风险。