
PostgreSQL / 系统课时
识别表与索引膨胀
识别表与索引膨胀
高频 JSONB 更新会不断产生新的行版本,并可能同时更新 GIN 等索引。空间增长并不等于膨胀,本课通过统计视图、对象大小和 VACUUM 行为区分正常增长、可回收空间与需要重建的异常膨胀。
学习目标
- 根据 MVCC 行版本理解 JSONB 高频更新为何增加空间压力
- 结合死元组、对象大小和 vacuum 状态识别异常增长
- 判断什么时候使用 VACUUM,什么时候才需要 REINDEX 或重写表
先区分增长和膨胀
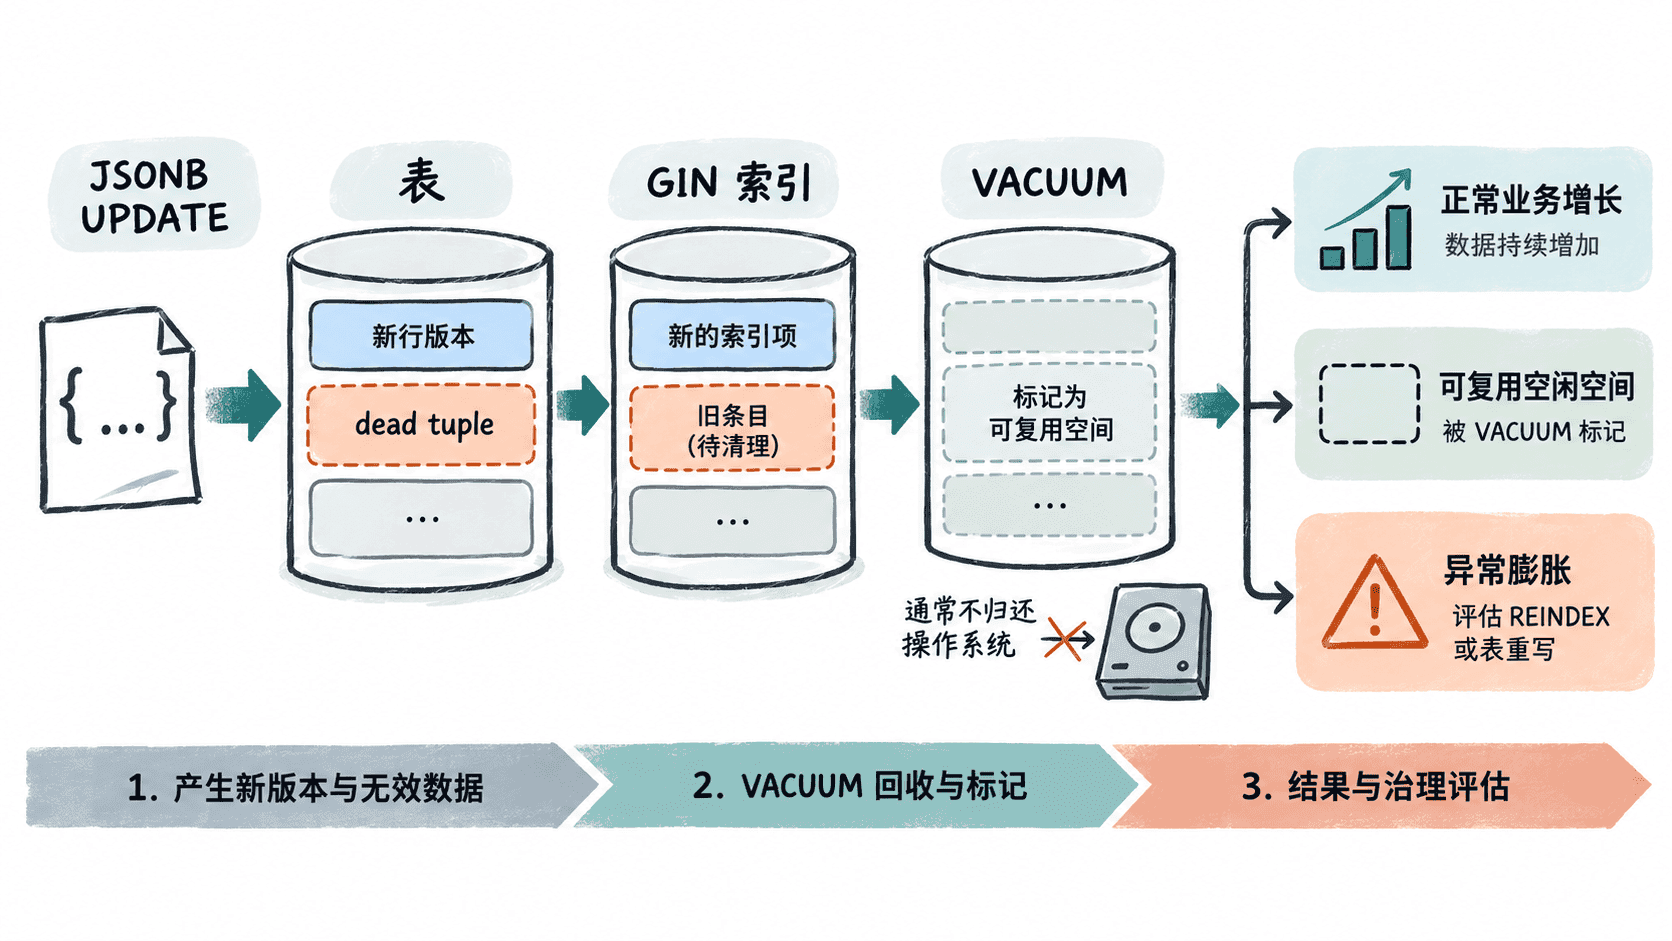
表变大可能只是因为业务数据真的增加,因此不能仅凭 pg_total_relation_size 上升就认定膨胀。真正需要治理的是对象内部存在大量已经无效、但尚未被复用或无法及时清理的空间。
PostgreSQL 的 UPDATE 通常不是在原位置覆盖行,而是产生新的 MVCC 行版本。旧版本在不再被任何事务需要后成为死元组,由 VACUUM 标记为可复用空间。普通 VACUUM 通常不会把关系文件缩回操作系统,而是让 PostgreSQL 后续写入重新利用这些页。
当 JSONB 列本身带有 GIN 索引时,修改该列还意味着索引键发生变化,因此相应更新不能利用 HOT 路径来避免索引维护。高频、大文档更新于是可能同时推动表和索引空间增长。
从表统计开始定位
先查看更新量、死元组估算以及 autovacuum 是否正常工作。统计值是估算和累计计数,适合发现趋势,不适合直接换算成精确膨胀百分比。
SELECT
    relname,
    n_live_tup,
    n_dead_tup,
    n_tup_upd,
    n_tup_hot_upd,
    last_autovacuum,
    autovacuum_count,
    pg_size_pretty(pg_table_size(relid)) AS table_size
FROM pg_stat_user_tables
WHERE relname = 'product_catalog';
预期结果
     relname      | n_live_tup | n_dead_tup | n_tup_upd | n_tup_hot_upd | last_autovacuum | autovacuum_count | table_size
------------------+------------+------------+-----------+---------------+-----------------+------------------+-----------
 product_catalog  | <VALUE>    | <VALUE>    | <VALUE>   | <VALUE>       | <TIME>          | <VALUE>          | <VALUE>
如果 n_dead_tup 长期增长、last_autovacuum 很久没有推进,首先应调查 VACUUM 为什么没有及时完成。若 n_tup_upd 很高而 n_tup_hot_upd 很低,则说明大量更新都需要维护索引;对于被索引的 JSONB 列频繁变化,这种现象并不意外。
对比表与索引空间
下一步把 heap、索引和总对象大小拆开观察,以确定空间主要增长在哪里。
SELECT
    pg_size_pretty(pg_relation_size('product_catalog')) AS heap_size,
    pg_size_pretty(pg_indexes_size('product_catalog')) AS indexes_size,
    pg_size_pretty(pg_total_relation_size('product_catalog')) AS total_size;
预期结果
 heap_size | indexes_size | total_size
-----------+--------------+-----------
 <VALUE>   | <VALUE>      | <VALUE>
如果索引空间远快于 heap 增长,应继续按索引拆分大小和使用次数。这样可以避免把一个异常 GIN 索引的问题误判成整张表的问题。
SELECT
    indexrelname,
    idx_scan,
    pg_size_pretty(pg_relation_size(indexrelid)) AS index_size
FROM pg_stat_user_indexes
WHERE relname = 'product_catalog'
ORDER BY pg_relation_size(indexrelid) DESC;
预期结果
       indexrelname       | idx_scan | index_size
--------------------------+----------+-----------
 idx_product_attrs_gin    | <VALUE>  | <VALUE>
 <OTHER_INDEX_NAME>       | <VALUE>  | <VALUE>
对象大并不自动意味着应该重建。需要把当前体积与历史基线、有效数据量、更新频率和查询价值一起比较。
判断 VACUUM 是否已经足够
普通 VACUUM 的主要职责是清理不可见行版本、更新可见性信息并让空间可以被后续写入复用。如果表仍持续有相近规模的写入,能够内部复用空闲页通常比频繁收缩文件更重要。
可以先手工执行一次带统计输出的 VACUUM,确认是否存在大量可清理死元组以及清理过程是否正常。
VACUUM (VERBOSE, ANALYZE) product_catalog;预期结果
INFO:  vacuuming "<DATABASE>.public.product_catalog"
<ADDITIONAL_VACUUM_OUTPUT>
VACUUM
具体 INFO 行会随 PostgreSQL 版本、对象状态和执行环境变化。执行后应重新观察 n_dead_tup、最后 vacuum 时间以及业务延迟,而不是期待 pg_table_size 一定立即下降。
什么时候才需要重建
如果某个索引在数据量稳定的情况下长期异常增长,并且常规 VACUUM 后依然没有恢复到合理范围,可以评估重建索引。生产环境通常优先考虑支持并发访问的方式,以减少阻塞时间。
REINDEX INDEX CONCURRENTLY idx_product_attrs_gin;预期结果
REINDEXREINDEX INDEX CONCURRENTLY 会产生额外 I/O、CPU 和临时磁盘占用,也需要等待并发事务推进,因此应在执行前确认磁盘余量和业务负载。重建后再比较索引大小与查询性能,才能判断是否确实存在显著可回收空间。
如果主要膨胀发生在表本身,而业务又确实需要把文件空间归还给操作系统,才需要评估 VACUUM FULL、表重写或其他在线重组方案。这类操作比普通 VACUUM 代价高得多,不能作为周期性的常规清理手段。
识别膨胀的可靠路径是先确认死元组和 vacuum 是否正常,再定位空间增长发生在 heap 还是具体索引,最后结合历史基线判断是否值得重建。对于高频 JSONB 更新场景,减少不必要的宽 GIN 索引和降低文档改写频率,往往比反复执行重建更能解决根因。