
PostgreSQL / 系统课时
拆分高频更新字段
拆分高频更新字段
JSONB 适合承载变化快、结构不稳定的属性,但如果某个字段已经稳定下来,又被高频修改和频繁过滤,继续把它留在整块 JSONB 中会放大写入与索引维护成本。本课通过一个商品状态示例,判断哪些字段应该提升为普通列,哪些仍适合保留在 JSONB 中。
学习目标
- 识别适合从 JSONB 中拆出的高频稳定字段
- 使用普通列与 JSONB 混合建模降低更新和查询成本
- 验证拆分后查询路径与更新方式是否符合预期
先识别值得拆分的字段
判断一个 JSONB 键是否应该提升为普通列,不要只看它是否经常出现。更有价值的信号是:字段语义稳定、类型稳定、修改频率高,并且经常出现在过滤、排序、关联或约束条件中。
例如商品记录把 status、stock 和展示属性一起存进 attributes。颜色、材质等属性可能随品类变化,但 status 和 stock 已经是稳定业务字段。每次库存变化都执行整块 JSONB 更新,不仅要产生新的行版本,还可能使包含该 JSONB 的 GIN 索引产生额外维护工作。
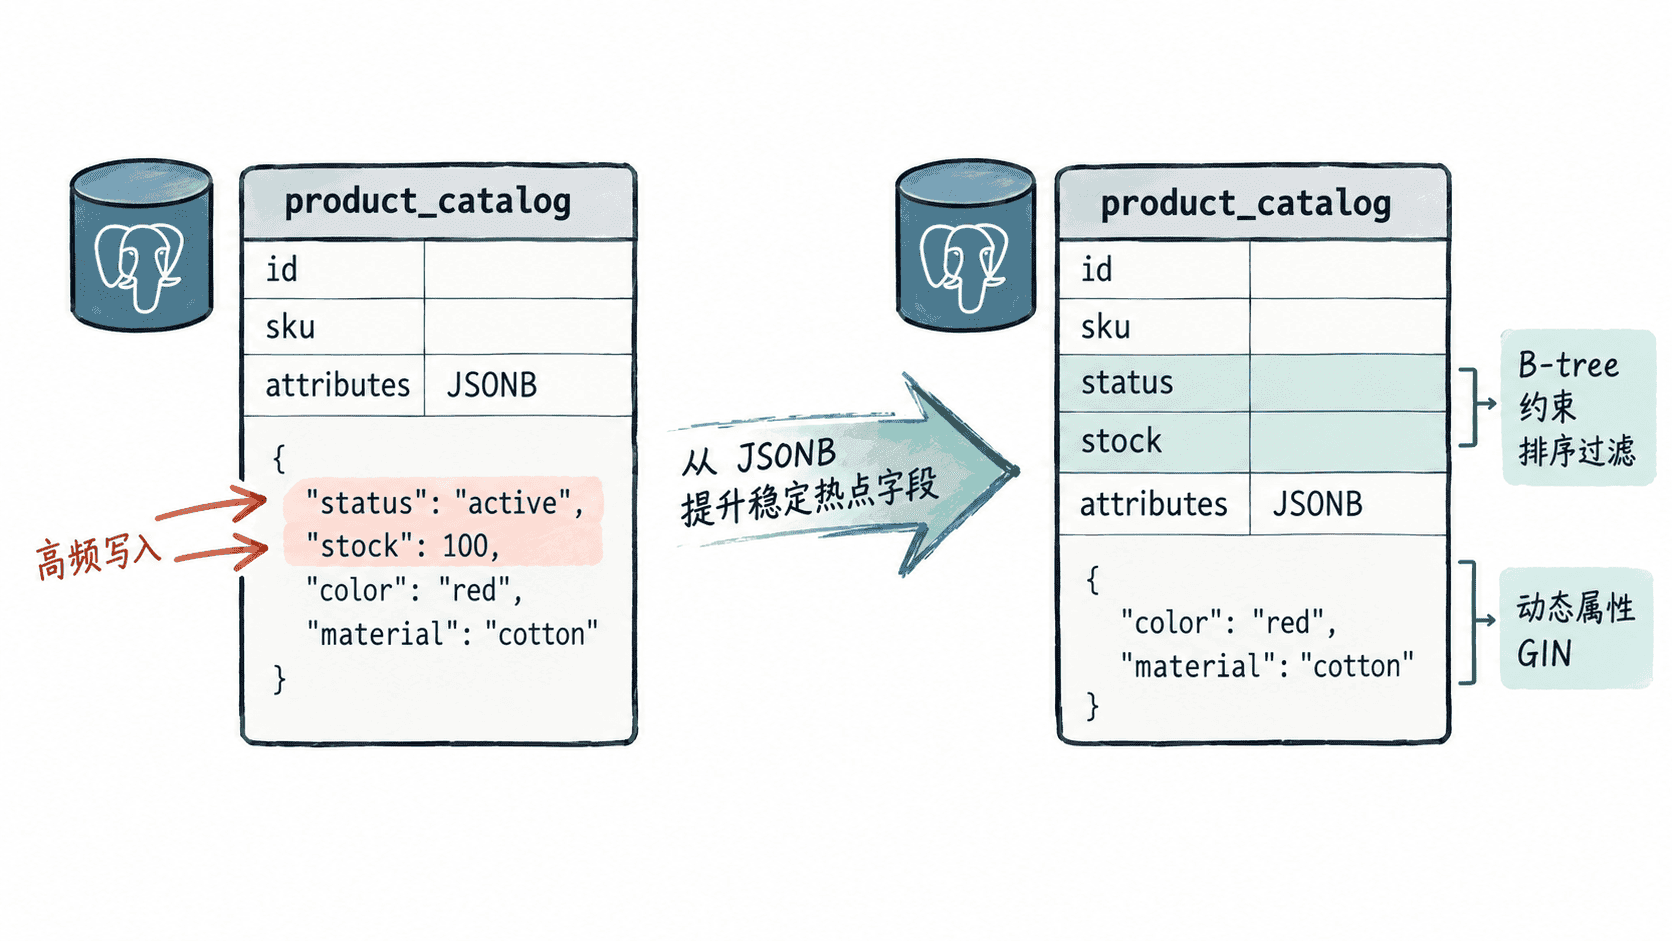
用普通列承接稳定热点字段
下面建立一个最小示例。status 与 stock 使用普通列,仍然变化较大的 color、material 等属性保留在 JSONB 中。普通列可以直接使用数据类型、默认值和检查约束表达业务规则。
DROP TABLE IF EXISTS product_catalog;

CREATE TABLE product_catalog (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    sku text NOT NULL UNIQUE,
    status text NOT NULL CHECK (status IN ('ACTIVE', 'DISABLED')),
    stock integer NOT NULL CHECK (stock >= 0),
    attributes jsonb NOT NULL DEFAULT '{}'::jsonb
);

INSERT INTO product_catalog (sku, status, stock, attributes)
VALUES
    ('SKU-1001', 'ACTIVE', 12, '{"color":"black","material":"steel"}'),
    ('SKU-1002', 'DISABLED', 0, '{"color":"white","material":"plastic"}');

SELECT sku, status, stock, attributes->>'color' AS color
FROM product_catalog
ORDER BY sku;
预期结果
   sku    |  status  | stock | color
----------+----------+-------+-------
 SKU-1001 | ACTIVE   |    12 | black
 SKU-1002 | DISABLED |     0 | white
此时库存变化不再需要调用 jsonb_set 重构属性文档。业务代码可以直接更新 stock,数据库也能通过整数类型和 CHECK 约束阻止负库存。
为更新和过滤选择独立索引
如果业务经常查询可售商品,可以直接为稳定字段建立 B-tree 索引,而不是要求一个宽泛的 JSONB GIN 索引同时承担状态、库存和动态属性过滤。
CREATE INDEX idx_product_catalog_status_stock
ON product_catalog (status, stock);

UPDATE product_catalog
SET stock = stock - 1
WHERE sku = 'SKU-1001'
  AND stock > 0;

SELECT sku, status, stock
FROM product_catalog
WHERE status = 'ACTIVE'
  AND stock > 0;
预期结果
UPDATE 1

   sku    | status | stock
----------+--------+-------
 SKU-1001 | ACTIVE |    11
对于真实大表,是否使用该索引仍由优化器结合数据分布和成本决定;小型演示表因为顺序扫描成本很低,即使索引设计合理,也可能看到 Seq Scan,不能据此断定索引无效。
不要把所有 JSONB 字段都拆出来
拆分的目标不是消灭 JSONB,而是明确边界。像颜色、材质、扩展配置这类不同业务对象可能拥有不同键集合的字段,仍然适合留在 JSONB。只有当字段已经形成稳定业务语义,并持续参与高频写入、过滤、排序、唯一性或外键关系时,普通列的收益才会逐渐超过 JSONB 的灵活性。
如果某组动态数据已经演变成一对多实体,例如一个商品拥有大量可独立增删、独立检索的规格项,那么继续增加普通列也不是终点。这类数据更适合拆成独立关系表,用主外键表达归属,而不是在一个越来越大的 JSONB 文档里维护数组。
迁移已有 JSONB 字段
已有表可以先增加普通列,再从 JSONB 回填,验证后再切换应用写入路径。迁移期间通常暂时保留原 JSONB 键,以避免一次性同时修改数据和应用造成难以回滚的变更。
ALTER TABLE product_catalog
ADD COLUMN IF NOT EXISTS priority integer;

UPDATE product_catalog
SET priority = (attributes->>'priority')::integer
WHERE attributes ? 'priority';

SELECT count(*) AS rows_with_priority
FROM product_catalog
WHERE priority IS NOT NULL;
预期结果
 rows_with_priority
--------------------
                  0
这里示例数据没有 priority,因此结果为 0。实际迁移时应先检查 JSONB 中的值是否都能安全转换为目标类型,再创建约束和索引。确认应用已经改为读写普通列后,才考虑删除 JSONB 中的重复键。
高频更新字段治理的核心不是简单比较“JSONB 与普通列谁更快”,而是让数据结构与字段职责一致:稳定、强约束、经常过滤或频繁修改的业务字段优先使用关系型列;真正动态、稀疏且结构变化明显的属性继续交给 JSONB。