
PostgreSQL / 系统课时
判断索引为何未被使用
判断索引为何未被使用
JSONB 表已经建了索引,执行计划却仍显示 Seq Scan,并不代表索引失效。本课通过一套可重复实验,依次判断索引路径是否成立、表达式是否匹配,以及优化器是否只是因选择性和成本而放弃索引。
学习目标
- 判断 JSONB 条件与索引操作符类是否匹配
- 识别表达式索引与查询表达式不匹配的问题
- 区分“索引不可用”和“索引可用但成本更高”
先判断索引路径是否成立
假设 attributes 上只有默认 GIN 索引。默认 jsonb_ops 能支持 @>、? 等 JSONB 条件,但 attributes ->> 'color' = 'red' 会先把 JSONB 值提取为文本,再做文本等值比较,因此不能直接利用整列 JSONB 的 GIN 索引。
下面用同一份数据连续观察四个状态:只有整列 GIN 时查询稀有值、增加表达式 B-tree 后查询稀有值、查询高命中率值,以及临时压低顺序扫描偏好后验证备选索引路径。
DROP TABLE IF EXISTS product_catalog;

CREATE TABLE product_catalog (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    attributes jsonb NOT NULL
);

INSERT INTO product_catalog (attributes)
SELECT jsonb_build_object(
    'color', CASE WHEN g % 100 = 0 THEN 'red' ELSE 'blue' END,
    'brand', 'brand-' || (g % 100)
)
FROM generate_series(1, 20000) AS g;

CREATE INDEX idx_attributes_gin
ON product_catalog USING gin (attributes);

ANALYZE product_catalog;

EXPLAIN (ANALYZE, BUFFERS)
SELECT id
FROM product_catalog
WHERE attributes ->> 'color' = 'red';

CREATE INDEX idx_attributes_color
ON product_catalog ((attributes ->> 'color'));

ANALYZE product_catalog;

EXPLAIN (ANALYZE, BUFFERS)
SELECT id
FROM product_catalog
WHERE attributes ->> 'color' = 'red';

EXPLAIN (ANALYZE, BUFFERS)
SELECT id
FROM product_catalog
WHERE attributes ->> 'color' = 'blue';

SET enable_seqscan = off;

EXPLAIN (ANALYZE, BUFFERS)
SELECT id
FROM product_catalog
WHERE attributes ->> 'color' = 'blue';

RESET enable_seqscan;
预期结果
DROP TABLE
CREATE TABLE
INSERT 0 20000
CREATE INDEX
ANALYZE
<PLAN_WITH_SEQ_SCAN_FOR_RED>
CREATE INDEX
ANALYZE
<PLAN_WITH_IDX_ATTRIBUTES_COLOR_FOR_RED>
<PLAN_LIKELY_SEQ_SCAN_FOR_BLUE>
SET
<PLAN_USING_IDX_ATTRIBUTES_COLOR_FOR_BLUE>
RESET
这些 <PLAN_...> 占位符代表实际执行计划文本,成本、耗时和具体扫描节点会随 PostgreSQL 版本、缓存状态与机器环境变化。关键现象是:创建表达式索引前,文本等值条件没有匹配路径;创建后,稀有值 red 通常会获得可用索引路径;高命中率的 blue 即使能用索引,也可能继续选择顺序扫描。
对照表达式与扫描节点
表达式索引能否使用,取决于查询条件能否与索引表达式匹配,而不是字段名称看起来是否相近。这里索引真正保存的是 attributes ->> 'color' 的文本结果,因此排查时应直接对照 CREATE INDEX 与 WHERE 中的表达式、类型转换和附加函数。
若优化器采用 idx_attributes_color,计划中会出现该索引名,并在 Index Cond 中看到对应的文本等值条件。根据成本估算,最终节点可能是 Index Scan,也可能是 Bitmap Index Scan 与 Bitmap Heap Scan 的组合。
再判断选择性与成本
索引在语义上可用,不代表优化器一定会选择它。示例中 red 约占 1%,而 blue 约占 99%。查询 blue 时,索引需要读取大量索引项并访问大量 heap 页面,总代价可能高于顺序读取整张表,因此出现 Seq Scan 并不异常。
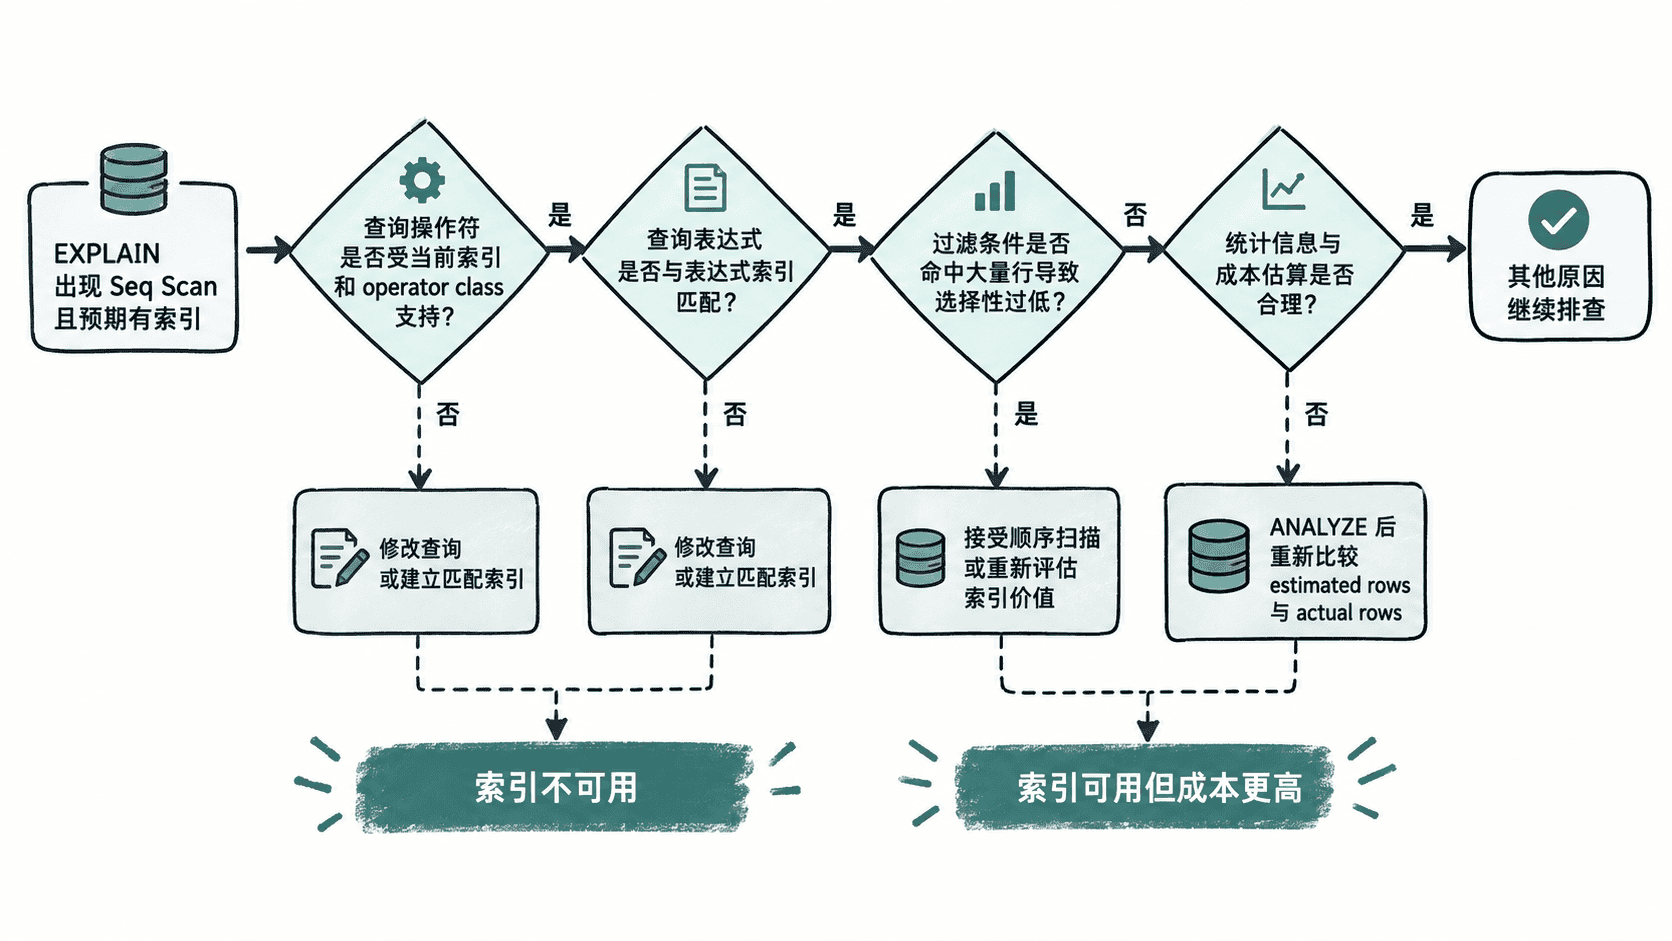
排查时按图中的顺序判断:先问“现有索引是否支持这个条件”,再问“表达式是否匹配”,最后才讨论选择性、统计信息和成本。这样可以避免把所有 Seq Scan 都误判成索引故障。
检查估算误差与备选路径
如果操作符和表达式都正确、条件选择性也不低,却仍得到异常计划,就比较 EXPLAIN ANALYZE 中的估算 rows 与 actual rows。两者相差一个或多个数量级时,应优先检查统计信息是否过期;更新统计信息后重新执行同一查询,观察估算是否更接近实际值。ANALYZE 不是强制改变计划的开关,统计信息本来就新鲜时,计划完全不变也正常。
主示例最后把 enable_seqscan 临时设为 off,用于验证是否存在合法的表达式索引路径。这个设置并不能保证彻底消除顺序扫描,只是显著降低规划器选择它的意愿;如果此时 blue 查询能形成 idx_attributes_color 的索引条件,说明原来的 Seq Scan 更可能是成本选择结果。
排查 JSONB 索引未使用时,顺序应保持稳定:先判断能不能用,再判断值不值得用。操作符不受支持或表达式不匹配属于索引路径不可用;选择性过低、统计估算和成本判断则属于索引可用但优化器认为其他路径更便宜。