
PostgreSQL / 系统课时
优化数组成员检索
优化数组成员检索
JSONB 数组适合保存少量、随文档整体读写的动态成员;当业务频繁按成员值反查记录时,优化应分成两层:先判断成员是否仍适合留在 JSONB,再在这一模型内选择查询表达和索引。本课用标签检索把这两层判断串起来。
学习目标
- 使用
@>与 JSONPath@?查询数组成员,并理解它们与 GIN 的关系。 - 区分查询表达机制与数据建模方案,避免把 JSONPath 与关系化表放在同一决策层级。
- 根据反查频率、组合条件和约束需求,在 JSONB 与关系化成员表之间做选择。
建立数组成员反查场景
假设商品把标签保存在 attributes.tags 数组中,业务经常查询包含 featured 的商品。在空测试库中建立最小数据,并为整个 attributes 创建默认 jsonb_ops GIN 索引。
CREATE TABLE product_catalog (
    id bigserial PRIMARY KEY,
    sku text NOT NULL UNIQUE,
    attributes jsonb NOT NULL
);

CREATE INDEX idx_product_attributes_gin
    ON product_catalog USING gin (attributes);

INSERT INTO product_catalog (sku, attributes) VALUES
('SKU-001', '{"tags":["featured","sale"],"color":"black"}'),
('SKU-002', '{"tags":["new"],"color":"white"}'),
('SKU-003', '{"tags":["featured"],"color":"blue"}');
预期结果
CREATE TABLE
CREATE INDEX
INSERT 0 3
在 JSONB 内选择查询表达
如果条件只是“固定路径的数组包含某成员”,@> 最直接,右侧 JSON 保留与文档一致的结构即可。JSONPath 的 @? 更适合路径更深、需要过滤表达式或组合数组谓词的场景。两者都属于 JSONB 内的查询表达方式,不是不同的数据模型。
下面用同一组数据验证两种写法的语义一致性。
SELECT 'containment' AS method, sku
FROM product_catalog
WHERE attributes @> '{"tags":["featured"]}'::jsonb

UNION ALL

SELECT 'jsonpath' AS method, sku
FROM product_catalog
WHERE attributes @? '$.tags[*] ? (@ == "featured")'
ORDER BY method, sku;
预期结果
   method    |   sku
-------------+---------
 containment | SKU-001
 containment | SKU-003
 jsonpath    | SKU-001
 jsonpath    | SKU-003
默认 GIN jsonb_ops 支持 @>,也能为可从 JSONPath 中提取索引条件的 @?、@@ 查询提供索引访问。若工作负载主要是包含查询和可索引的 JSONPath 条件,可评估 jsonb_path_ops;它通常更紧凑,但不支持 ?、?|、?& 这类键存在操作符,因此不能无条件替换默认操作符类。最终是否使用索引,应以真实数据上的 EXPLAIN 或 EXPLAIN ANALYZE 为准,小数据表出现顺序扫描并不代表索引无效。
先做建模判断,再谈查询语法
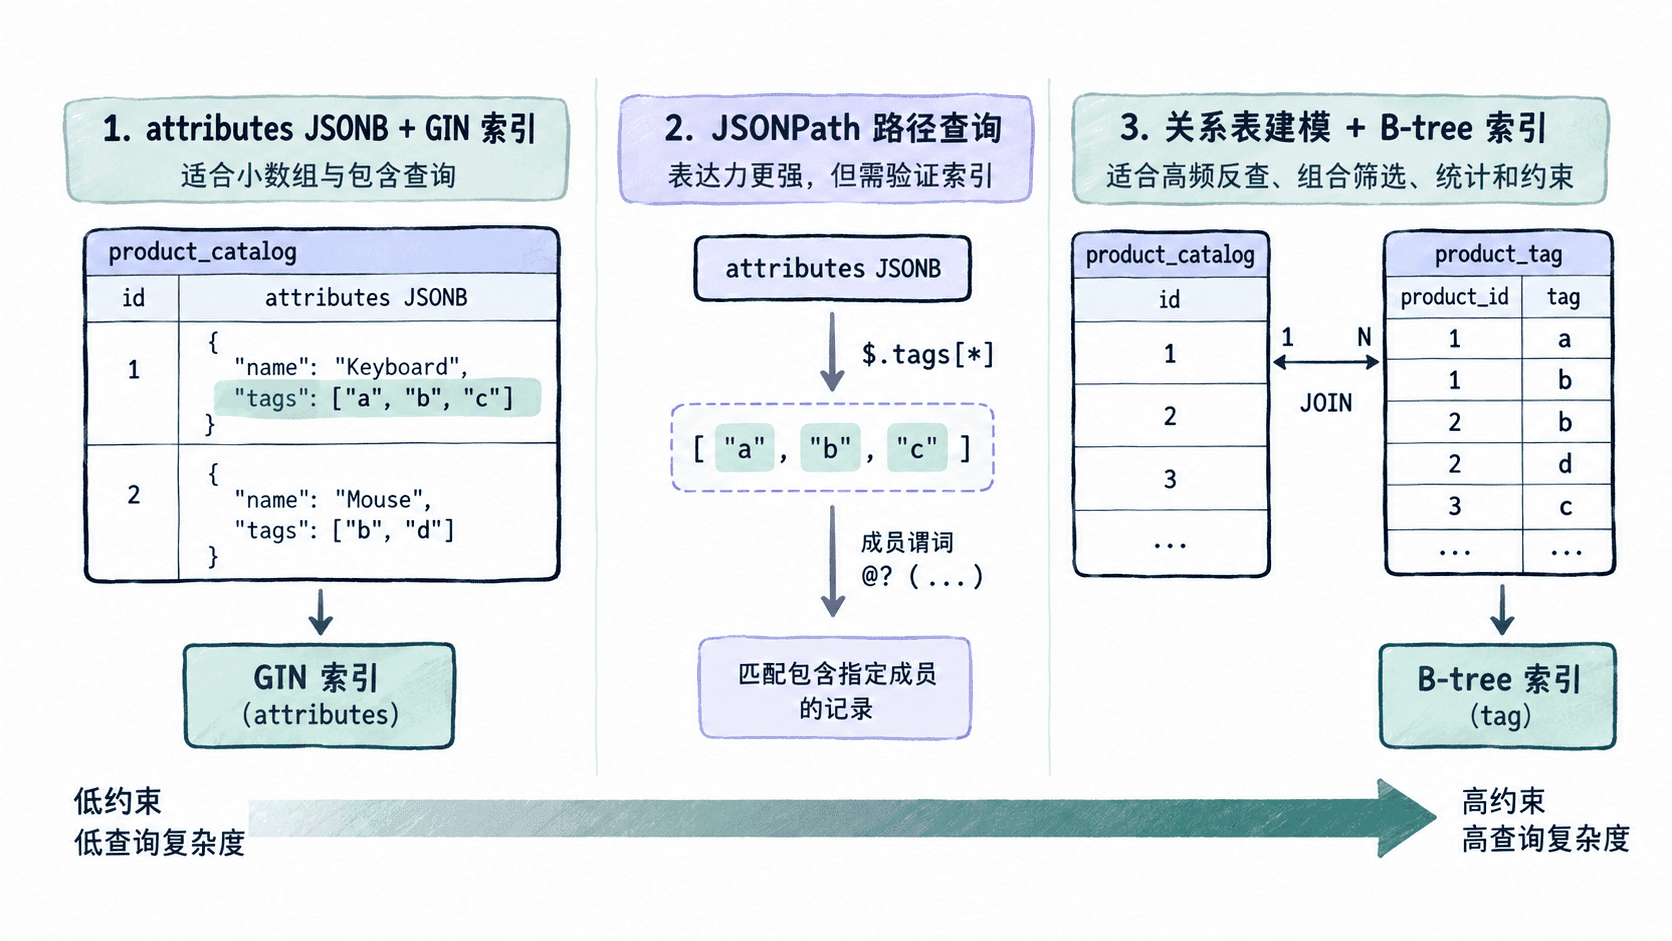
真正同层级的建模选择只有两类:继续把成员保留在 JSONB,或者拆成关系化成员表。JSONPath 只存在于“继续使用 JSONB”这一分支中,不能与关系表并列成第三种数据模型。
| 决策层次 | 选项 | 适合场景 | 主要代价 |
|---|---|---|---|
| 数据模型 | JSONB + GIN | 数组较小、成员是附加属性、整体读写多 | 成员级外键、唯一约束、统计与关联较弱 |
| JSONB 内查询表达 | @> / JSONPath |
简单包含用 @>;复杂路径谓词用 JSONPath |
JSONPath 的索引可用性需按具体表达式验证 |
| 数据模型 | 关系化成员表 | 高频成员反查、组合过滤、统计、关联和约束多 | 写入需要维护额外表与关联关系 |
当查询逐渐变成“标签 + 状态 + 时间范围”,或者需要统计每个标签的使用次数、给标签加外键、单独删除成员时,问题已经不只是更换 JSONB 查询语法,而是数据模型开始不匹配访问模式。
高频成员反查改为关系化
当成员已经承担独立查询、关联、统计或约束职责,可以把每个标签拆成一行。主键 (product_id, tag) 保证同一商品不重复挂载同一标签,再增加 (tag, product_id) 索引支持从标签反查商品。
CREATE TABLE product_tag (
    product_id bigint NOT NULL REFERENCES product_catalog(id) ON DELETE CASCADE,
    tag text NOT NULL,
    PRIMARY KEY (product_id, tag)
);

CREATE INDEX idx_product_tag_tag_product
    ON product_tag (tag, product_id);

INSERT INTO product_tag (product_id, tag)
SELECT p.id, t.tag
FROM product_catalog AS p
CROSS JOIN LATERAL jsonb_array_elements_text(p.attributes->'tags') AS t(tag);

SELECT p.sku
FROM product_tag AS pt
JOIN product_catalog AS p ON p.id = pt.product_id
WHERE pt.tag = 'featured'
ORDER BY p.sku;
预期结果
CREATE TABLE
CREATE INDEX
INSERT 0 4
   sku
---------
 SKU-001
 SKU-003
选择标准可以归结为两层:先判断数组成员是否仍只是文档内部的附加属性;若是,再在 @>、JSONPath 与合适的 GIN 操作符类之间优化查询。只有当成员已经承担独立查询、关联、统计或约束职责时,才把它提升为关系化数据模型。