
PostgreSQL / 系统课时
改造查询与索引方案
改造查询与索引方案
本课从已有基线出发,为同一张混合字段表选择查询表达式、GIN、表达式索引与部分索引,并用优化前后的执行计划验证收益。目标不是“索引越多越好”,而是让每一种索引只服务明确且高频的查询模式。
学习目标
- 根据 JSONB 运算符和过滤条件选择合适的索引类型
- 把高频标量路径改写成可命中表达式索引的查询
- 用执行计划、缓冲区访问与索引空间判断优化是否值得保留
先按查询模式决定索引
不同 JSONB 查询需要不同索引结构。metadata @> ... 这类包含查询适合 GIN;固定路径上的标量等值查询适合表达式 B-tree;只服务特定事件类型的查询,可以再用部分索引缩小维护范围。先按查询形态选结构,再用执行计划确认优化器是否真的受益。
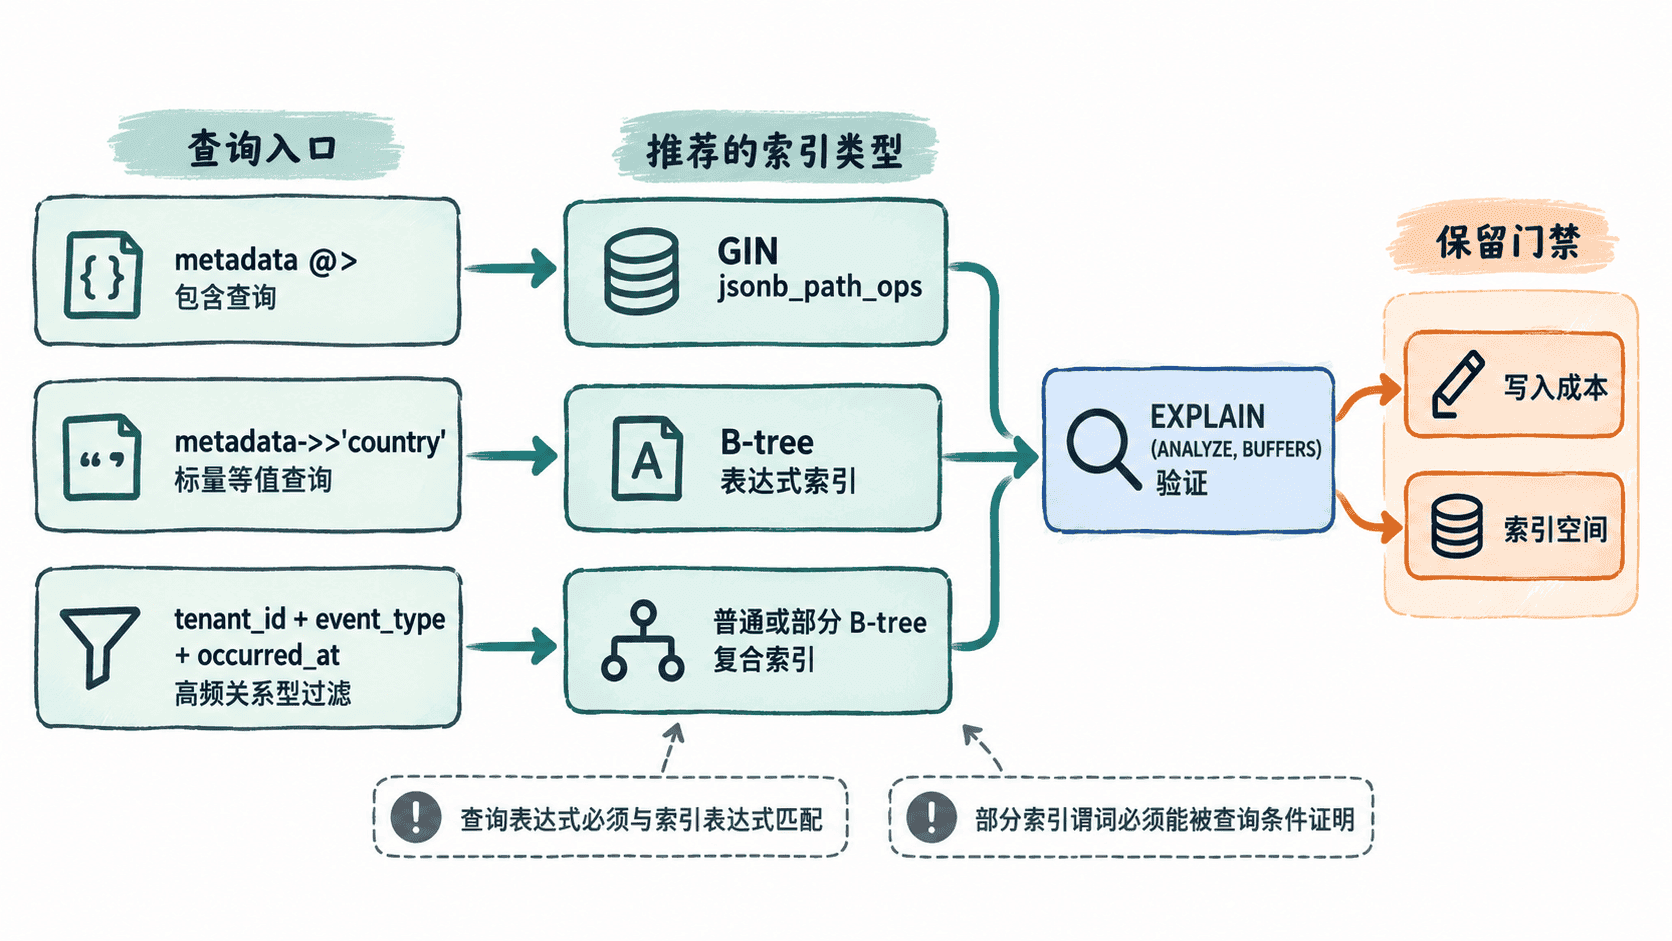
下面使用一个 200000 行的实验表作为贯穿本课的主示例。基线查询同时包含租户、事件类型、JSONB 包含条件和时间倒序,在没有辅助索引时通常需要扫描大量数据后再排序。
DROP TABLE IF EXISTS event_store_opt;

CREATE TABLE event_store_opt (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    tenant_id bigint NOT NULL,
    event_type text NOT NULL,
    occurred_at timestamptz NOT NULL,
    metadata jsonb NOT NULL
);

INSERT INTO event_store_opt (tenant_id, event_type, occurred_at, metadata)
SELECT
    (g % 200) + 1,
    CASE WHEN g % 5 = 0 THEN 'purchase' ELSE 'view' END,
    timestamptz '2026-01-01 00:00:00+00' + g * interval '1 minute',
    jsonb_build_object(
        'source', CASE WHEN g % 3 = 0 THEN 'mobile' ELSE 'web' END,
        'country', CASE WHEN g % 4 = 0 THEN 'US' ELSE 'CA' END,
        'tags', jsonb_build_array('campaign-' || (g % 30))
    )
FROM generate_series(1, 200000) AS g;

ANALYZE event_store_opt;

EXPLAIN (ANALYZE, BUFFERS, FORMAT TEXT)
SELECT id, occurred_at
FROM event_store_opt
WHERE tenant_id = 1
  AND event_type = 'purchase'
  AND metadata @> '{"source":"mobile"}'
ORDER BY occurred_at DESC
LIMIT 50;
预期结果
DROP TABLE
CREATE TABLE
INSERT 0 200000
ANALYZE
Limit  (actual time=<TIME>..<TIME> rows=<VALUE> loops=1)
  ->  Sort  (actual time=<TIME>..<TIME> rows=<VALUE> loops=1)
        Sort Key: occurred_at DESC
        ->  Seq Scan on event_store_opt  (actual time=<TIME>..<TIME> rows=<VALUE> loops=1)
              Filter: ((tenant_id = 1) AND (event_type = 'purchase'::text) AND (metadata @> '{"source": "mobile"}'::jsonb))
Planning Time: <TIME> ms
Execution Time: <TIME> ms
具体代价、时间和行数会随机器、数据页缓存状态与 PostgreSQL 版本变化。这里真正要记录的是扫描方式、实际处理行数、Buffers 中的块访问,以及是否额外发生排序;这些指标才是后续对比的基线。
建立互补索引
GIN 负责 @> 包含条件,复合 B-tree 负责租户、事件类型和时间顺序。这里选择 jsonb_path_ops,因为工作负载主要使用 @>;它通常比默认 jsonb_ops 更紧凑,但支持的操作符更少,不能视为通用替代。
CREATE INDEX event_store_opt_metadata_gin
ON event_store_opt
USING gin (metadata jsonb_path_ops);

CREATE INDEX event_store_opt_tenant_type_time_idx
ON event_store_opt (tenant_id, event_type, occurred_at DESC);

ANALYZE event_store_opt;

EXPLAIN (ANALYZE, BUFFERS, FORMAT TEXT)
SELECT id, occurred_at
FROM event_store_opt
WHERE tenant_id = 1
  AND event_type = 'purchase'
  AND metadata @> '{"source":"mobile"}'
ORDER BY occurred_at DESC
LIMIT 50;
预期结果
CREATE INDEX
CREATE INDEX
ANALYZE
Limit  (actual time=<TIME>..<TIME> rows=<VALUE> loops=1)
  ->  Index Scan using event_store_opt_tenant_type_time_idx on event_store_opt
        Index Cond: ((tenant_id = 1) AND (event_type = 'purchase'::text))
        Filter: (metadata @> '{"source": "mobile"}'::jsonb)
Planning Time: <TIME> ms
Execution Time: <TIME> ms
这是代表性计划,不要求节点名称逐字一致。根据统计信息和选择性,优化器也可能选择 GIN 的 Bitmap Index Scan,或采用其他可用路径。验收时应比较实际扫描行数、缓冲区访问和执行时间是否下降,而不是为了“命中某个索引”强行改写 SQL。
用表达式索引覆盖高频标量路径
如果业务经常按 metadata->>'country' 做等值过滤,直接再给整列增加一个 GIN 往往不够聚焦。对固定 JSON 路径建立 B-tree 表达式索引,可以直接服务标量比较;如果该查询只针对 purchase,再加部分索引谓词还能避免维护无关的 view 行。
CREATE INDEX event_store_opt_purchase_country_idx
ON event_store_opt ((metadata->>'country'))
WHERE event_type = 'purchase';

ANALYZE event_store_opt;

EXPLAIN (ANALYZE, BUFFERS, FORMAT TEXT)
SELECT count(*)
FROM event_store_opt
WHERE event_type = 'purchase'
  AND metadata->>'country' = 'US';
预期结果
CREATE INDEX
ANALYZE
Aggregate  (actual time=<TIME>..<TIME> rows=1 loops=1)
  ->  Bitmap Heap Scan on event_store_opt
        Recheck Cond: ((metadata ->> 'country'::text) = 'US'::text)
        ->  Bitmap Index Scan on event_store_opt_purchase_country_idx
              Index Cond: ((metadata ->> 'country'::text) = 'US'::text)
Planning Time: <TIME> ms
Execution Time: <TIME> ms
这里有两个关键边界。查询表达式需要能与索引表达式匹配;额外的类型转换或函数包装可能让优化器无法使用该索引。部分索引也只有在优化器能够证明查询条件蕴含索引谓词时才可用,因此本例必须保留 event_type = 'purchase'。
比较收益与写入代价
查询变快并不代表方案就该保留。索引会占用磁盘和缓存,并增加 INSERT、UPDATE、VACUUM 的维护成本。可以先查看索引空间,再结合真实工作负载中的调用频率和执行计划决定是否删除低价值索引。
SELECT
    indexrelname,
    idx_scan,
    pg_size_pretty(pg_relation_size(indexrelid)) AS index_size
FROM pg_stat_user_indexes
WHERE relname = 'event_store_opt'
ORDER BY pg_relation_size(indexrelid) DESC;
预期结果
               indexrelname                | idx_scan | index_size
-------------------------------------------+----------+-----------
 event_store_opt_metadata_gin              | <VALUE>  | <VALUE>
 event_store_opt_tenant_type_time_idx      | <VALUE>  | <VALUE>
 event_store_opt_pkey                      | <VALUE>  | <VALUE>
event_store_opt_purchase_country_idx | <VALUE> | <VALUE>最终验收应回到同一组基线 SQL:确认慢查询的实际扫描量与缓冲区访问下降,常用路径能利用合适索引,同时索引空间和写入代价仍在可接受范围内。这样得到的不是“某条 SQL 被调快”,而是一组与业务访问模式匹配、可以持续治理的查询与索引方案。