
PostgreSQL / 系统课时
安全调整生产索引
安全调整生产索引
生产环境调整 JSONB 索引不能只看“能否创建成功”,还要控制锁、I/O、CPU、磁盘空间以及失败后的残留对象。本课用一个候选 GIN 索引贯穿创建、失败恢复、收益验证和旧索引下线,形成可回退的完整变更闭环。
学习目标
- 使用并发方式创建和删除索引,降低在线读写被阻塞的风险
- 明确识别
indisvalid = false的失败索引,并完成清理、重建和复检 - 在替换旧索引前验证新索引状态、查询收益与资源代价
把索引变更拆成可回退阶段
生产索引调整不应是一条孤立的 CREATE INDEX。更安全的顺序是:确认目标查询与资源余量,创建候选索引,检查目录状态,验证执行计划和性能,再观察一段时间后决定是否删除旧索引。新索引未通过验证前,旧索引继续提供回退能力。
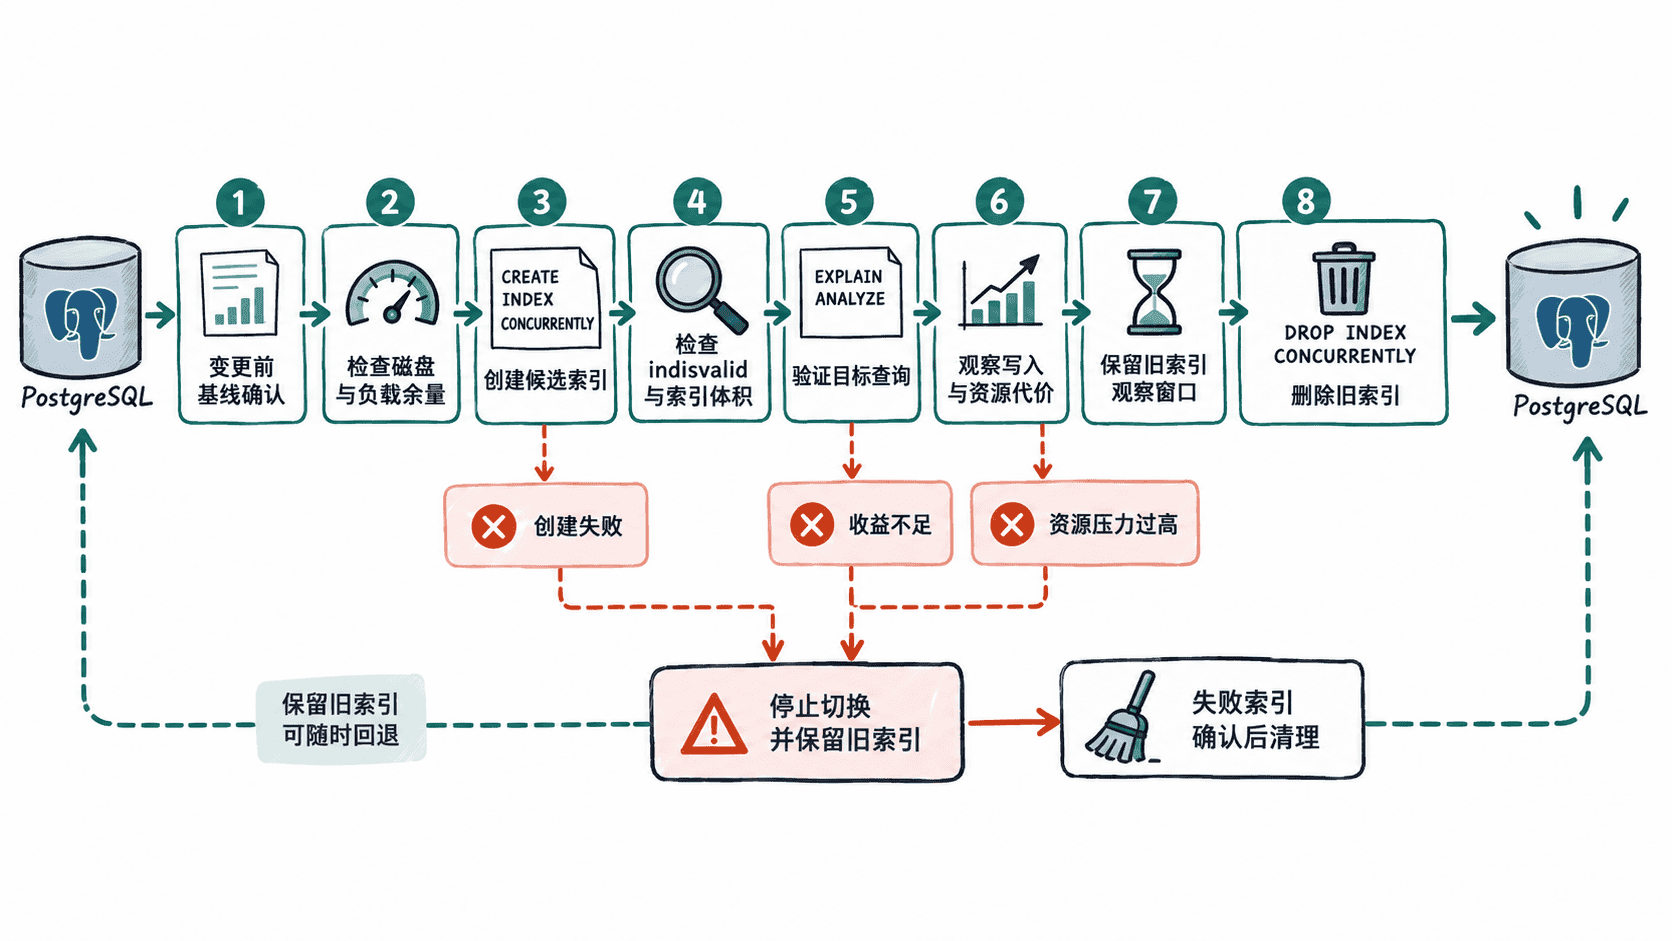
普通 CREATE INDEX 在构建期间会阻止目标表上的写入,因此在线大表通常优先评估 CREATE INDEX CONCURRENTLY。并发创建不会长时间锁死正常读写,但需要更多扫描和等待,整体耗时通常更长,也不能放在显式事务块中执行。
并发创建候选 JSONB 索引
假设目标查询主要使用 attributes @> ... 做包含判断,并评估后选择 jsonb_path_ops。使用新名称创建候选索引,不覆盖旧索引名称,便于并行验证和随时回退。
CREATE INDEX CONCURRENTLY idx_product_attributes_path_candidate
ON product_catalog
USING gin (attributes jsonb_path_ops);
预期结果
CREATE INDEX构建耗时取决于表规模、并发写入和存储性能。客户端长时间没有返回时,不要直接重复执行同名命令;应先确认服务器端构建是否仍在进行,以及候选索引是否已经存在。
识别失败索引并完成清理重试
创建报错、会话被取消或连接中断后,先查询 pg_index,不要凭客户端结果判断构建是否成功。indisvalid = false 是明确的无效标志;indisready 可辅助判断失败发生阶段,但不应代替 indisvalid 做可用性判断。
SELECT
    c.relname AS index_name,
    i.indisvalid,
    i.indisready,
    pg_size_pretty(pg_relation_size(c.oid)) AS index_size
FROM pg_index AS i
JOIN pg_class AS c ON c.oid = i.indexrelid
WHERE c.relname = 'idx_product_attributes_path_candidate';
若失败后留下无效索引,预期结果类似:
                 index_name                  | indisvalid | indisready | index_size
---------------------------------------------+------------+------------+-----------
 idx_product_attributes_path_candidate       | f          | <VALUE>    | <VALUE>
<VALUE> 会随失败阶段和数据量变化。处理时按查询结果分支:没有记录说明候选索引不存在,可在定位失败原因后重新创建;若 indisvalid = false,先删除残留索引,再重新执行并发创建;若 indisvalid = true 且 indisready = true,不要盲目重建,直接进入收益验证。
下面给出无效索引的清理与重建闭环。两条语句都必须在显式事务块之外执行。
DROP INDEX CONCURRENTLY idx_product_attributes_path_candidate;

CREATE INDEX CONCURRENTLY idx_product_attributes_path_candidate
ON product_catalog
USING gin (attributes jsonb_path_ops);
预期结果
DROP INDEX
CREATE INDEX
重建完成后再次执行前面的状态查询,确认 indisvalid = true 且 indisready = true 再进入下一阶段。若再次失败,应先定位死锁、表达式计算错误、资源压力、会话取消等原因,然后重新走“检查状态 → 清理无效索引 → 重建 → 复检”,不要连续盲目重试。
验证索引状态和实际收益
目录状态正常只说明索引已经完成构建,还不能证明它值得保留。应使用真实查询谓词验证执行计划,并与变更前基线比较。下面仍使用同一个 @> 查询作为主示例。
EXPLAIN (ANALYZE, BUFFERS)
SELECT id, sku
FROM product_catalog
WHERE attributes @> '{"color":"black"}'::jsonb;
预期结果类似:
Bitmap Heap Scan on product_catalog  (actual time=<TIME>..<TIME> rows=<VALUE> loops=1)
  Recheck Cond: (attributes @> '{"color": "black"}'::jsonb)
  ->  Bitmap Index Scan on idx_product_attributes_path_candidate
        Index Cond: (attributes @> '{"color": "black"}'::jsonb)
Planning Time: <TIME> ms
Execution Time: <TIME> ms实际节点、时间和行数会随数据分布与缓存状态变化。重点不是强求出现某个固定节点,而是确认候选索引进入合理访问路径,并结合执行时间、缓冲区访问量和线上慢查询分布判断收益。EXPLAIN ANALYZE 会真正执行查询,生产环境应控制采样频率和查询成本。
观察通过后再删除旧索引
只有候选索引已经有效、目标查询确有收益,并完成必要观察窗口后,才考虑移除被替代的旧索引。生产环境通常使用 DROP INDEX CONCURRENTLY,降低普通删除索引时强锁对在线访问的影响。
DROP INDEX CONCURRENTLY idx_product_attributes_old;预期结果
DROP INDEX并发删除同样不能放在显式事务块中。删除前还要确认旧索引没有被其他查询模式依赖;一个索引对当前重点 SQL 没有价值,不代表它对整个业务都没有价值。
GIN 索引构建会额外消耗 CPU、I/O 和磁盘空间,同时在线写入仍在继续。执行前应确认磁盘同时容纳新旧索引和构建临时开销,观察复制延迟与存储延迟,并预先定义 CPU、I/O、延迟和剩余空间的停止阈值。若构建因资源压力被取消,必须重新检查候选索引是否处于 indisvalid = false,清理后才能安全重试。安全调整的关键就是让“创建、失败恢复、验证、切换、删除”每一步都可检查、可停止、可回退。