
PostgreSQL / 系统课时
控制 GIN 写入放大
控制 GIN 写入放大
JSONB 上的 GIN 索引能显著加速包含、键存在等查询,但一次文档更新可能对应大量索引维护。本课从写入链路、pending list 与索引范围入手,建立查询收益和写入成本之间可验证的治理方法。
学习目标
- 解释 JSONB 更新为什么会放大 GIN 索引维护成本
- 正确观察并解读 GIN pending list、索引体积和自动维护节奏
- 通过减少索引范围和谨慎调整
fastupdate控制写入成本
写入成本从哪里产生
GIN 是倒排索引。对 JSONB 建立 GIN 后,操作符类会从一行文档中提取多个可检索键;文档越复杂,一次插入或更新可能需要维护的索引内容就越多。
PostgreSQL 更新会生成新的行版本。当更新改变了 GIN 索引所依赖的 JSONB 值时,新行版本需要写入新的 GIN 索引项,旧行版本相关内容则由后续 VACUUM 等维护过程处理。因此不能把“只改 JSON 中一个字段”理解成只维护一个索引键。
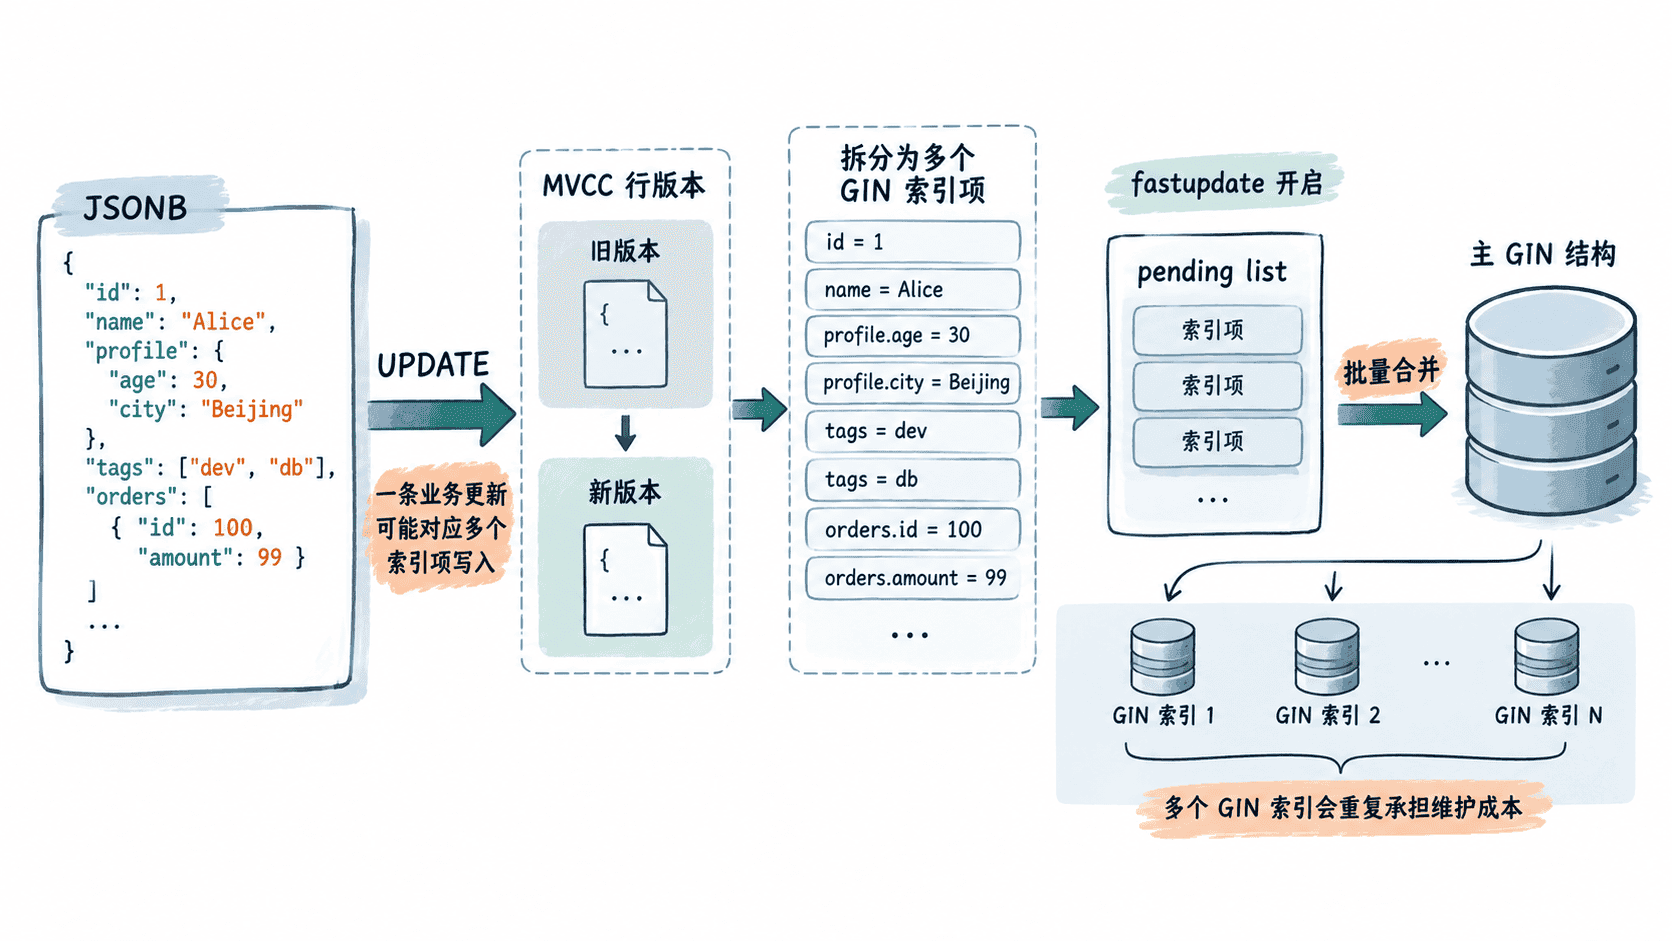
fastupdate 默认开启。新增索引内容会先进入未排序的 pending list,之后再批量合并到主 GIN 结构,通常能降低普通前台写入的单次成本,但不会消除总维护量。pending list 较大时,查询还要额外扫描它;如果某次写入触发前台 cleanup,也可能出现明显的延迟和 I/O 峰值。
观察索引和 pending list
先看目标表上的 GIN 索引数量、体积和使用次数,再把 pending list 与自动维护节奏放在同一次诊断中观察。pgstatginindex 来自 pgstattuple 扩展;下面示例假设扩展已经由有权限的角色安装。
SELECT
    s.indexrelname,
    s.idx_scan,
    pg_size_pretty(pg_relation_size(s.indexrelid)) AS index_size,
    ic.reloptions
FROM pg_stat_user_indexes AS s
JOIN pg_class AS ic ON ic.oid = s.indexrelid
JOIN pg_am AS am ON am.oid = ic.relam
WHERE s.relname = 'product_catalog'
  AND am.amname = 'gin'
ORDER BY pg_relation_size(s.indexrelid) DESC;

SELECT *
FROM pgstatginindex('idx_product_attrs_gin'::regclass);

SELECT
    last_autovacuum,
    last_autoanalyze,
    autovacuum_count,
    autoanalyze_count
FROM pg_stat_user_tables
WHERE relname = 'product_catalog';
预期结果
      indexrelname       | idx_scan | index_size | reloptions
-------------------------+----------+------------+------------
 idx_product_attrs_gin   | <VALUE>  | <VALUE>    | <VALUE>

 version | pending_pages | pending_tuples
---------+---------------+----------------
 <VALUE> | <VALUE>       | <VALUE>

 last_autovacuum | last_autoanalyze | autovacuum_count | autoanalyze_count
-----------------+------------------+------------------+-------------------
<TIME> | <TIME> | <VALUE> | <VALUE>实际数值会随数据量、统计重置和维护历史变化。pending_pages 表示 pending list 占用的页数,pending_tuples 表示其中的元组数量,并不等于 JSONB 被拆出的 GIN key 数量。
不要把一次或几次“pending list 变大”直接判成清理速度不足。pending entries 会在表执行 VACUUM、发生 autoanalyze、显式调用 gin_clean_pending_list,或列表超过 gin_pending_list_limit 时被合并到主 GIN 结构;超过阈值的 cleanup 还可能由前台写入触发。因此 pending list 在阈值以内先增长、随后回落,本身可以是正常周期。
排障时应连续采样,并同时看写入吞吐、写延迟、last_autovacuum、last_autoanalyze 和索引级 reloptions。如果 pending list 长时间只增不降,再结合写入突增、自动维护是否及时、阈值是否匹配以及是否需要手工维护判断根因,不能由单个瞬时指标直接下结论。
优先减少不必要的维护范围
控制写入放大的首选手段通常不是关闭 GIN 的优化机制,而是减少必须维护的索引内容。每增加一个覆盖同一 JSONB 文档的 GIN 索引,同一次相关更新都可能增加一份索引维护工作。
如果业务只查询少数稳定路径,可以把这些路径提取成更窄的表达式索引。例如查询条件长期固定为颜色等值匹配时,可建立 B-tree 表达式索引。
CREATE INDEX idx_product_color
ON product_catalog ((attributes ->> 'color'));
预期结果
CREATE INDEX这种索引只服务对应表达式,不支持整份 JSONB 的任意包含查询,但索引项规模通常比宽泛 GIN 更可控。是否替换现有 GIN,应依据真实谓词、执行计划和读写负载决定,而不是只看索引大小。
谨慎调整 fastupdate
可以针对单个 GIN 索引关闭 fastupdate,让后续写入不再先进入 pending list,而是直接维护主 GIN 结构。
ALTER INDEX idx_product_attrs_gin
SET (fastupdate = off);
预期结果
ALTER INDEX这不是通用的“写入优化开关”。关闭 fastupdate 往往把更多索引维护工作直接放进前台写事务,可能减少 pending list 波动,却提高单次写入延迟。并且 ALTER INDEX ... SET (fastupdate = off) 不会自动清空此前已经存在的 pending list;如确需清理,应结合维护窗口评估 VACUUM 或 gin_clean_pending_list,不能把参数切换当成清理动作。
如果问题只是某段时间 pending list 较大,应先判断它是否处于正常的“积累—批量合并”周期,再评估 autovacuum/autoanalyze、写入峰值以及全局或索引级 gin_pending_list_limit。调大阈值可能降低前台 cleanup 的触发频率,但一旦仍由前台触发,单次 cleanup 可能更重,因此需要在真实负载下验证。
GIN 治理应同时看读与写。保留一个索引至少要证明它解决了高价值查询,并且索引增长、写入延迟和 cleanup 波动都可接受。对高频变更的 JSONB 文档,优先减少重复 GIN、缩小索引范围,并把稳定的高频过滤属性提取为窄索引,通常比单纯调整 fastupdate 更能持续降低写入放大。