
容器与云原生 / 系统课时
建立入口可观测性
建立入口可观测性
入口可观测性要把“流量、延迟、错误、后端健康”落成可查询的证据。本课沿请求链路组织指标,以遗留 ingress-nginx 的 metrics endpoint 与 PromQL 建立路由级观测,再用 Service、EndpointSlice 和 Pod 状态验证后端是否真正可服务。
学习目标
- 建立请求量、延迟、错误率和后端健康四类核心入口信号
- 用 ingress-nginx metrics endpoint 与 PromQL 定位到 Namespace 和 Ingress
- 使用 Service、EndpointSlice 与 Pod 状态验证后端可服务性
从请求链路设计指标
入口请求通常经过客户端、入口代理、路由规则、Service 和后端 Pod。只观察控制器进程是否存活,无法判断真实请求是否成功,因此指标应沿请求链路组织,并能从用户现象逐层收窄到具体路由和后端。
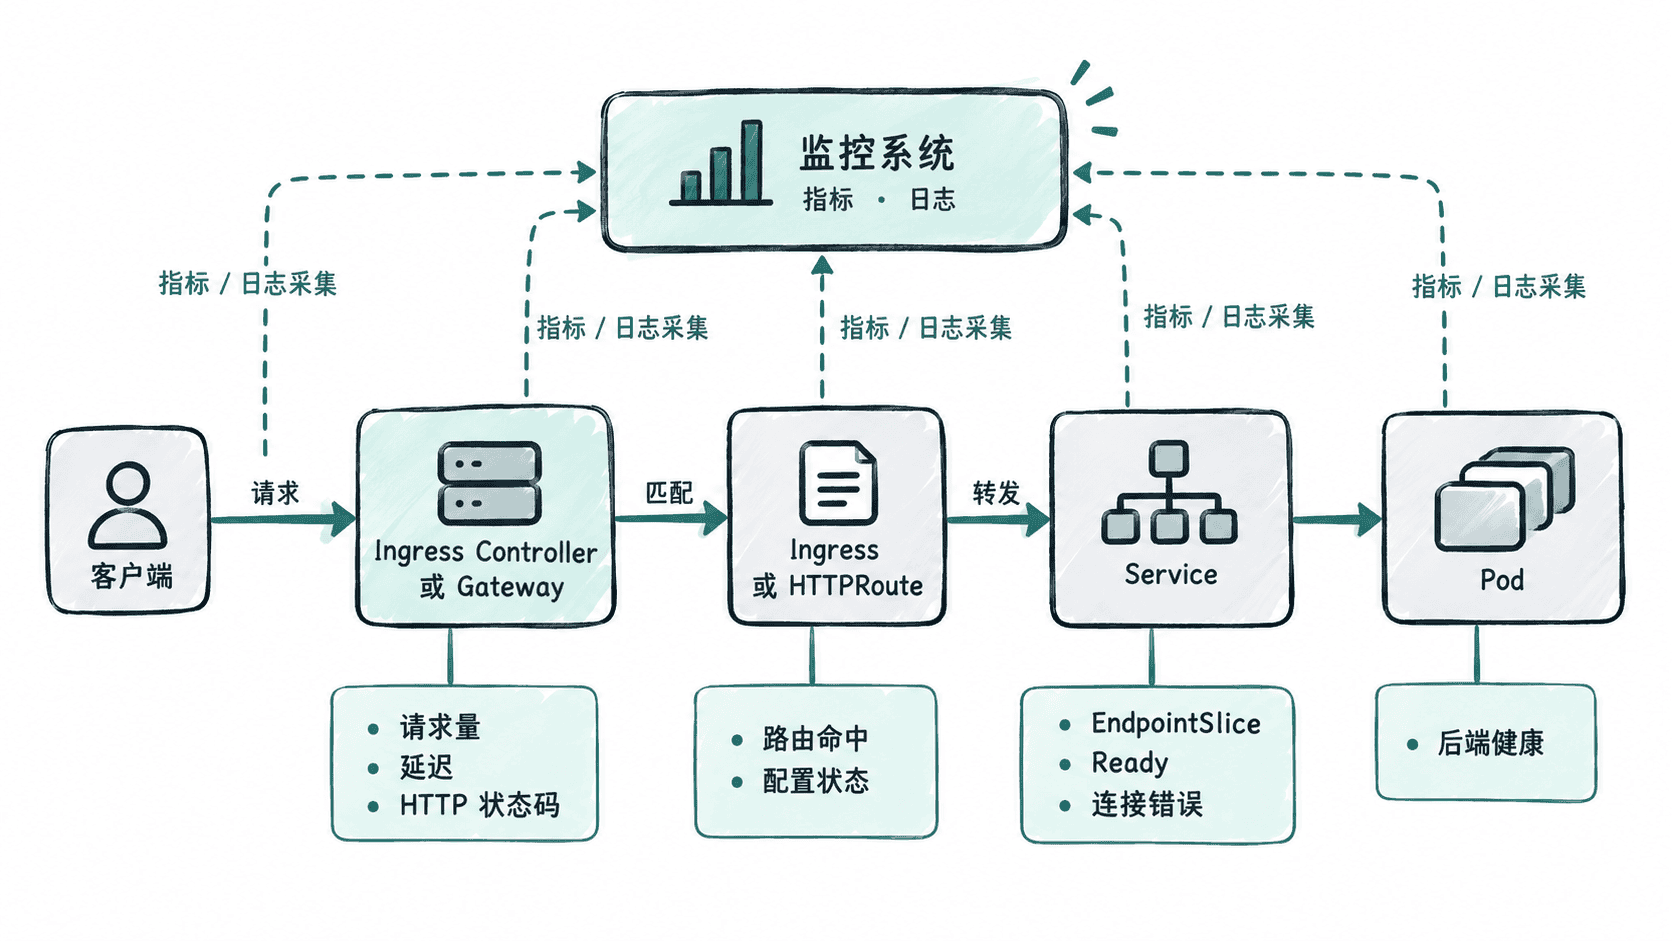
| 观测面 | 核心问题 | 典型信号 |
|---|---|---|
| 请求量 | 流量有没有到、集中在哪里 | 请求速率、按 host/route 分布 |
| 延迟 | 用户请求慢不慢 | P50/P95/P99、请求总耗时 |
| 错误率 | 哪一层正在失败 | 4xx、5xx、连接错误、超时 |
| 后端健康 | 路由后面是否有可服务实例 | EndpointSlice、Pod Ready、健康检查结果 |
指标标签优先使用稳定维度,如 Namespace、Ingress、Gateway、HTTPRoute 或 Service。完整 URL、请求 ID、用户 ID 等高基数字段更适合进入日志或 Trace,不应直接作为时序指标标签。
在遗留 ingress-nginx 中验证 metrics endpoint
下面仅把 ingress-nginx 作为仍在运行的遗留环境示例。先把控制器的 10254 端口转发到本机;这个命令会持续占用当前终端,后续检查请在另一个终端执行。
kubectl -n ingress-nginx port-forward deployment/ingress-nginx-controller 10254:10254预期输出
Forwarding from 127.0.0.1:10254 -> 10254另开终端确认 metrics endpoint 已经暴露请求计数器和请求耗时直方图。
curl -s http://127.0.0.1:10254/metrics \
  | grep -E '^# TYPE nginx_ingress_controller_(requests|request_duration_seconds) '
预期输出
# TYPE nginx_ingress_controller_request_duration_seconds histogram
# TYPE nginx_ingress_controller_requests counter
如果没有目标指标,应先检查控制器是否启用了 metrics 以及部署参数、Helm values 或端口访问是否正确,再检查 Prometheus 抓取配置。不要在指标源为空时继续调看板或告警规则。
用 PromQL 建立路由级查询
Prometheus 抓取成功后,先按 namespace 与 ingress 聚合请求速率。这样看板和告警可以直接指向具体入口对象,而不是只显示控制器 Pod。
sum by (namespace, ingress) (
  rate(nginx_ingress_controller_requests[5m])
)
预期结果
{namespace="app", ingress="<ID>"} <VALUE>5xx 比例用于观察服务器端失败。下面结果单位为百分比;低流量路由需要同时结合请求量判断,避免单个失败请求造成比例突增。
100 *
sum by (namespace, ingress) (
  rate(nginx_ingress_controller_requests{status=~"5.."}[5m])
)
/
sum by (namespace, ingress) (
  rate(nginx_ingress_controller_requests[5m])
)
预期结果
{namespace="app", ingress="<ID>"} <VALUE>P95 延迟从请求耗时直方图计算,结果单位为秒。它比平均值更容易暴露少量慢请求,但只有在样本量足够时才有稳定意义。
histogram_quantile(
  0.95,
  sum by (le, namespace, ingress) (
    rate(nginx_ingress_controller_request_duration_seconds_bucket[5m])
  )
)
预期结果
{namespace="app", ingress="<ID>"} <VALUE>三个 <VALUE> 分别表示请求速率、5xx 百分比和 P95 秒数,实际对象名与数值会随流量变化。其他入口控制器不必复用这些指标名,但应保留“请求量、错误率、延迟”三个观测目的,并映射到实现自身提供的指标。
用 Kubernetes 状态验证后端健康
Prometheus 显示 5xx 上升时,不要直接把它等同于“入口代理故障”。先确认路由指向的 Service,再检查该 Service 是否存在 EndpointSlice,并核对后端 Pod 是否 Ready。下面以命名空间 app、Service api 为例。
kubectl -n app get service api
kubectl -n app get endpointslice -l kubernetes.io/service-name=api
kubectl -n app get pods -o wide
预期输出
NAME   TYPE        CLUSTER-IP   EXTERNAL-IP   PORT(S)   AGE
api    ClusterIP   <IP>         <none>        80/TCP    <TIME>

NAME       ADDRESSTYPE   PORTS   ENDPOINTS   AGE
api-<ID>   IPv4          8080    <IP>        <TIME>

NAME       READY   STATUS    RESTARTS   AGE      IP     NODE
api-<ID>   1/1     Running   0          <TIME>   <IP>   <ID>
实际名称、IP、节点和时间会不同。关键证据是 Service 存在、EndpointSlice 中有后端地址,并且对应 Pod 处于 Ready;如果 endpoint 为空,应优先检查 Service selector、Pod 标签和 Readiness,而不是继续修改入口路由。
让告警能够指向行动
线上排查可以固定为“用户现象 → Prometheus 路由指标 → Ingress 或 Gateway 路由对象 → Service/EndpointSlice → Pod”。请求速率先确认影响范围,5xx 与 P95 判断错误和延迟是否异常,Kubernetes 对象状态再区分路由层与后端层问题。这样入口可观测性才不是一组孤立图表,而是一条能够从告警走到修复动作的证据链。