
容器与云原生 / 系统课时
治理重试与超时边界
治理重试与超时边界
入口超时决定一次请求最多等待多久,重试决定失败后还能追加多少次后端尝试。两者必须放进同一个请求预算,并受幂等性和 Controller 能力约束。本课用一条只读 HTTPRoute 串起能力确认、实际配置和验证边界。
学习目标
- 区分
request、backendRequest与retry.attempts的作用范围。 - 判断哪些请求适合自动重试,并理解写请求必须先具备幂等保障。
- 确认 CRD 与 Gateway Controller 支持后,配置并验证超时和重试策略。
理解重试的放大风险
如果入口允许每个失败请求额外重试 2 次,一次客户端请求最多可能形成 1 次初始尝试和 2 次重试。1000 个同时失败的请求,理论上可能接近 3000 次后端访问;当后端已因 CPU、线程池或连接池饱和而变慢时,重试会进一步放大排队与超时。
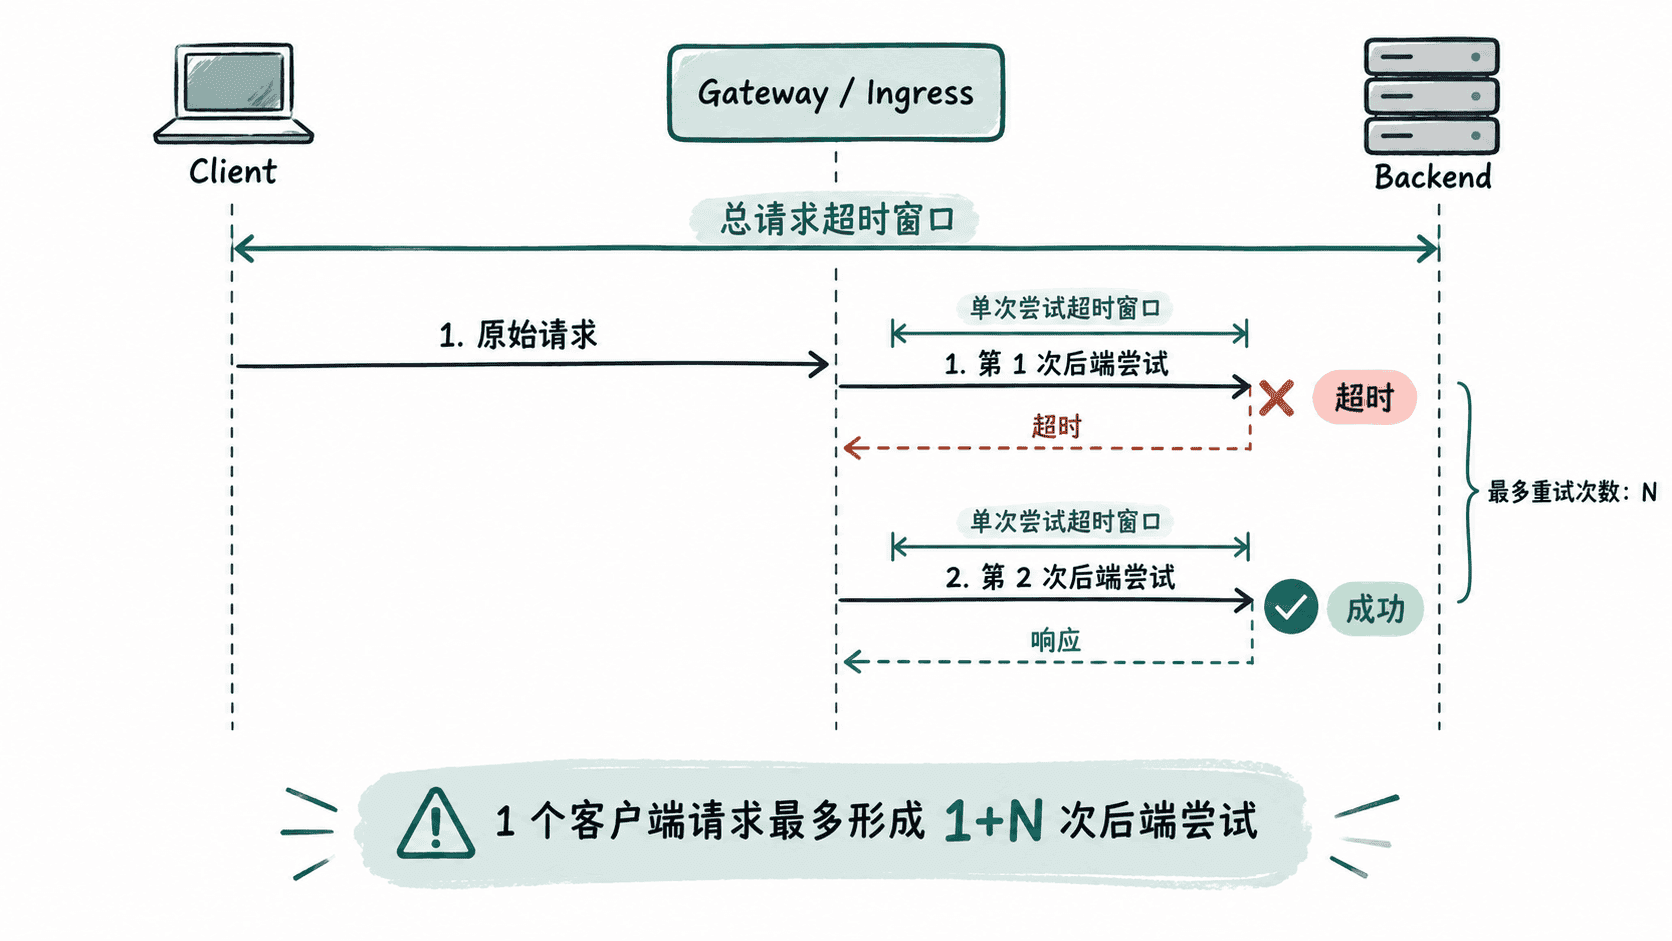
timeouts.request 是整个客户端请求的外层时限,timeouts.backendRequest 约束每一次 Gateway 到后端的请求,retry.attempts 表示最多追加的重试次数。GET、HEAD 通常更容易安全重试;POST、PATCH 等写请求只有在请求 ID、唯一约束或幂等记录能防止重复提交时,才应考虑自动重试。
确认版本与 Controller 支持
HTTPRouteRule.retry 从 Gateway API v1.2 起进入 Experimental Channel,支持级别为 Extended;它不是所有实现都必须支持的 Core 能力。timeouts 已进入 Standard Channel,但同样属于 Extended 支持。配置前先检查集群实际安装的 bundle、channel 和 CRD schema:
kubectl get crd httproutes.gateway.networking.k8s.io -o jsonpath='{.metadata.annotations.gateway\.networking\.k8s\.io/bundle-version}{" "}{.metadata.annotations.gateway\.networking\.k8s\.io/channel}{"\n"}{.spec.versions[?(@.name=="v1")].schema.openAPIV3Schema.properties.spec.properties.rules.items.properties.retry.type}{"\n"}'预期结果如下,版本号会随集群实际安装版本变化:
<VALUE> experimental
object
如果 channel 是 standard,或第二行为空,当前 CRD 不能接收该实验字段。字段存在也不等于数据面已实现它,还要确认当前 Gateway 使用哪个 Controller:
GATEWAY_CLASS=$(kubectl get gateway api-gateway -o jsonpath='{.spec.gatewayClassName}')
kubectl get gatewayclass "$GATEWAY_CLASS" -o jsonpath='{.spec.controllerName}{"\n"}'
预期结果:
<VALUE>随后必须按这个 controllerName 对应的产品与版本查阅官方支持表或 Gateway API conformance 报告。没有明确声明支持 HTTPRoute retry、状态码重试和 backoff 时,不应把“CRD 接受字段”当成“策略已经生效”。
配置超时与实际 retry
下面的主示例使用专用只读域名 read-api.example.com。一次客户端请求最多持续 3 秒,每次后端请求最多等待 700 毫秒;遇到 500、502、503、504 时最多额外重试 2 次,每次重试前至少等待 100 毫秒。
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: api-read
spec:
  parentRefs:
    - name: api-gateway
  hostnames:
    - read-api.example.com
  rules:
    - matches:
        - path:
            type: PathPrefix
            value: /read
      timeouts:
        request: 3s
        backendRequest: 700ms
      retry:
        codes:
          - 500
          - 502
          - 503
          - 504
        attempts: 2
        backoff: 100ms
      backendRefs:
        - name: api
          port: 8080
attempts: 2 表示最多重试两次,因此单个原始请求最多形成三次后端尝试。backoff: 100ms 是最小等待时间,Controller 可以采用更长退避或抖动;request: 3s 则是整个请求的外层上限。
保存为 httproute.yaml 后应用,并检查 Route 是否被父 Gateway 接受、后端引用是否解析成功:
kubectl apply -f httproute.yaml >/dev/null
kubectl get httproute api-read -o jsonpath='{range .status.parents[*].conditions[?(@.type=="Accepted")]}Accepted={.status}{"\n"}{end}{range .status.parents[*].conditions[?(@.type=="ResolvedRefs")]}ResolvedRefs={.status}{"\n"}{end}'
预期结果:
Accepted=True
ResolvedRefs=True
这里的合法 Condition 类型是 Accepted,不是 Accerue。若 API Server 直接报告 retry 为未知字段,说明 CRD schema 不包含该实验字段;若 Accepted=False,应继续读取该 Condition 的 reason、message 并核对 Controller 支持范围。
用总预算约束重试
规划时应把后端尝试、退避和代理开销放进同一个预算:
示例中三次后端尝试最多占 2.1 秒,两次按最小退避计算至少占 0.2 秒,因此在 3 秒总预算内还剩约 0.7 秒给额外退避、连接建立、排队和代理处理。由于 backoff 只规定最小值,Controller 等待更久时,后续重试可能会被总请求超时截断。
控制面显示 Accepted=True 只能证明 Route 被接受,不能单独证明数据面严格执行了重试。受控验证时应让只读后端稳定返回可重试状态码,同时对比客户端请求数、后端访问日志、Gateway 重试指标和总耗时。本例中单个客户端请求最多对应三次后端尝试,总耗时不得突破 3 秒;若后端已持续过载,应减少重试、缩短单次超时或配合限流与降级,而不是继续增加 attempts。