
CI/CD / 系统课时
识别 Jenkinsfile 中的重复逻辑
识别 Jenkinsfile 中的重复逻辑
共享库的价值不是让 Jenkinsfile 越短越好,而是把多个项目反复实现、需要统一维护的流水线能力集中起来。本节从一段典型 Jenkinsfile 出发,判断哪些逻辑应该保留在业务仓库,哪些已经具备抽取到共享库的条件。
学习目标
- 区分业务编排与可复用的流水线能力
- 根据重复程度、变化原因和维护边界判断是否应该抽取
- 识别不适合过早放入共享库的项目特有逻辑
先找重复而不是先建共享库
假设多个 Java 服务都包含“构建镜像、登录镜像仓库、推送镜像”的逻辑,只是镜像名称不同。某个项目的 Jenkinsfile 可能出现下面的阶段。
pipeline {
    agent any

    environment {
        IMAGE = 'registry.example.com/order-service'
    }

    stages {
        stage('Build Image') {
            steps {
                sh "docker build -t ${IMAGE}:${BUILD_NUMBER} ."
            }
        }

        stage('Push Image') {
            steps {
                withCredentials([usernamePassword(
                    credentialsId: 'registry-credentials',
                    usernameVariable: 'REGISTRY_USER',
                    passwordVariable: 'REGISTRY_PASSWORD'
                )]) {
                    sh '''
                        echo "$REGISTRY_PASSWORD" | docker login registry.example.com -u "$REGISTRY_USER" --password-stdin
                        docker push "$IMAGE:$BUILD_NUMBER"
                    '''
                }
            }
        }
    }
}
该示例要求 Jenkins Agent 已安装 Docker,并存在 ID 为 registry-credentials 的用户名密码凭据。镜像仓库还必须允许当前 Agent 访问。
预期结果
成功构建 registry.example.com/order-service:<BUILD_NUMBER>
使用 Jenkins 凭据登录镜像仓库
成功推送 registry.example.com/order-service:<BUILD_NUMBER>
<BUILD_NUMBER> 表示实际运行时的 Jenkins 构建编号。凭据内容不会因为 withCredentials 而成为应该写入 Jenkinsfile 的普通配置,仍应由 Jenkins 凭据系统管理。
判断重复逻辑是否值得抽取
看到两段相似代码并不意味着必须立刻抽取。更可靠的判断方法是同时检查三个问题:这段逻辑是否出现在多个仓库中,它们是否因为相同原因而修改,以及团队是否希望统一其行为。
例如镜像推送通常适合共享,因为凭据处理、仓库地址规则和失败策略往往由平台团队统一维护。相反,某个服务独有的集成测试命令即使写了十几行,也可能应该留在业务 Jenkinsfile,因为它只随该服务的代码和测试策略变化。
可以把候选逻辑分成两类:流水线能力回答“组织规定怎样安全地完成这件事”,例如制品上传、镜像发布、通知和部署封装;业务编排回答“这个项目今天需要依次做什么”,例如先生成订单协议,再运行该项目特有测试,最后决定是否发布。
保留 Jenkinsfile 的可读性
抽取后,Jenkinsfile 应继续表达发布过程,而不是退化成一串无法理解的共享函数。阅读业务仓库的人最好仍能从 stage 看出构建、测试和部署顺序,而具体实现细节由共享库负责。
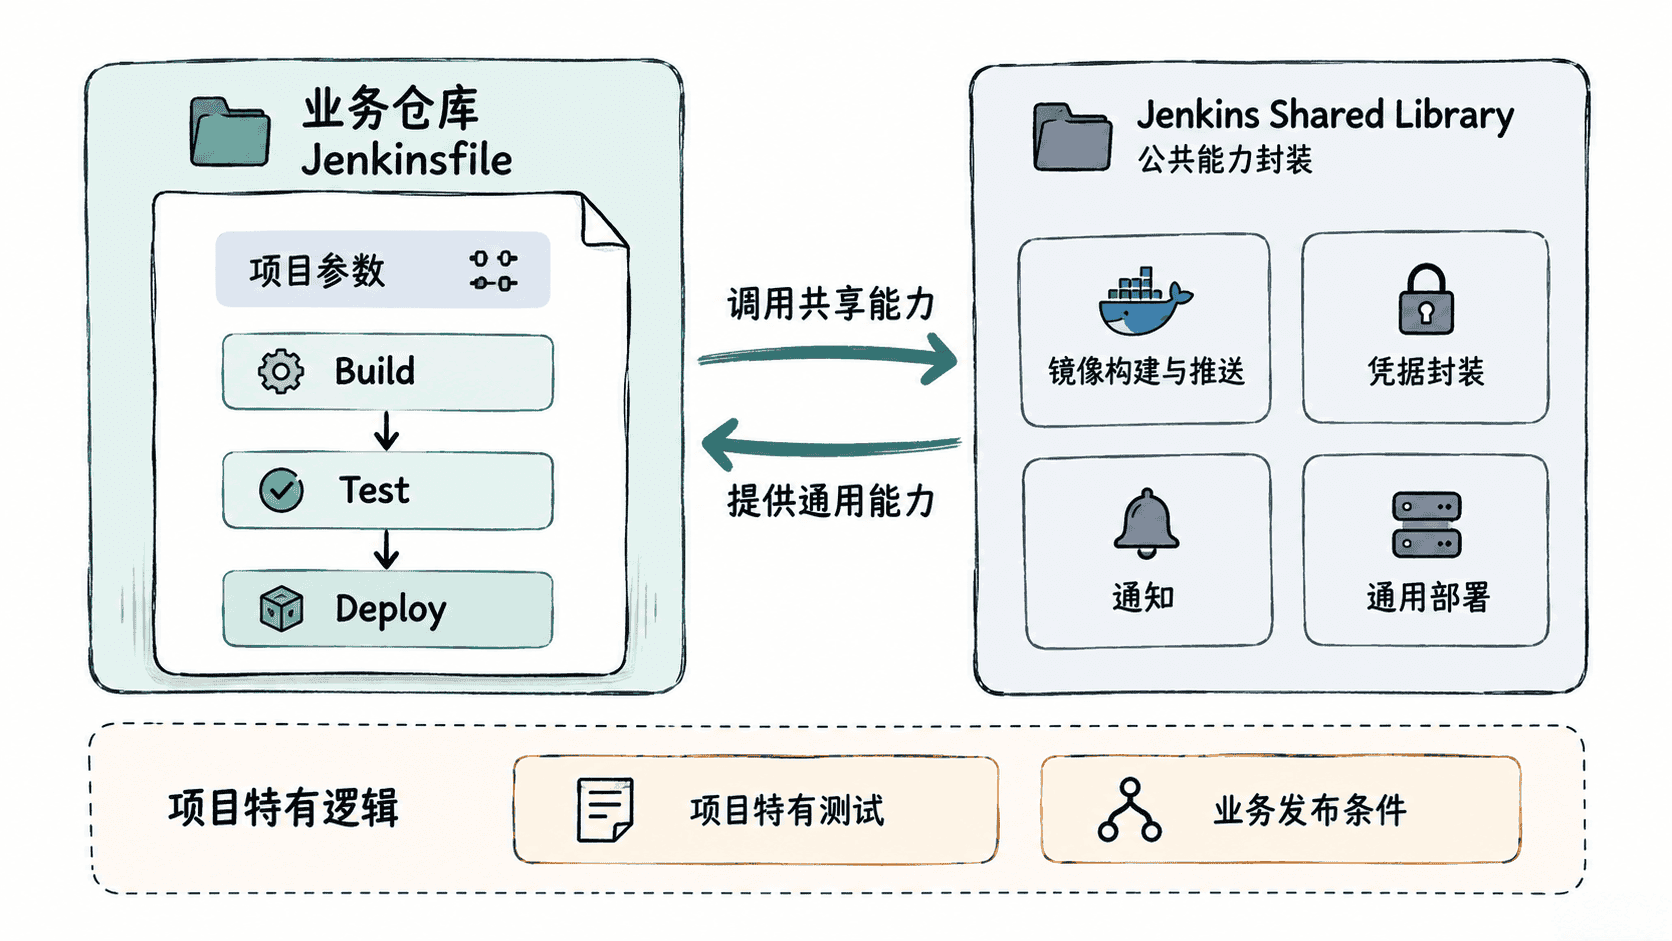
如果抽取后业务开发者必须打开共享库源码才能知道流水线会部署到哪里、是否执行测试或何时发布,那么抽象层次通常过高。共享库应该隐藏稳定的技术细节,而不是隐藏关键发布决策。
用变化原因做最后筛选
准备抽取前,可以查看几个项目过去的修改记录。如果一项改动经常需要在多个 Jenkinsfile 中同步修改,例如镜像仓库迁移、通知格式调整或统一的制品上传策略,它就是很强的共享库候选。
反过来,如果看似相同的代码在各项目中不断出现不同参数、不同分支和特殊条件,强行合并往往会产生大量开关。此时保留少量重复代码可能比维护一个复杂的“万能步骤”更清晰。
完成识别后,再进入共享库实现会更自然:业务 Jenkinsfile 保留可读的阶段和项目决策,共享库承载跨项目一致、可独立维护的技术能力。