
CI/CD / 系统课时
只对临时故障执行自动重试
只对临时故障执行自动重试
流水线偶尔会因网络抖动、远程服务短暂不可用而失败。合理的重试可以自行吸收这类瞬时故障,但如果把编译错误、测试失败也反复执行,只会延迟真正的失败。本课用 Jenkins Pipeline 的 retry 建立有边界的恢复策略。
学习目标
- 使用
retry为可能出现临时故障的操作设置有限次数重试 - 区分适合重试的瞬时故障与不应重试的确定性失败
- 通过拆分阶段避免一次临时故障导致整段流水线重复执行
retry 的执行边界
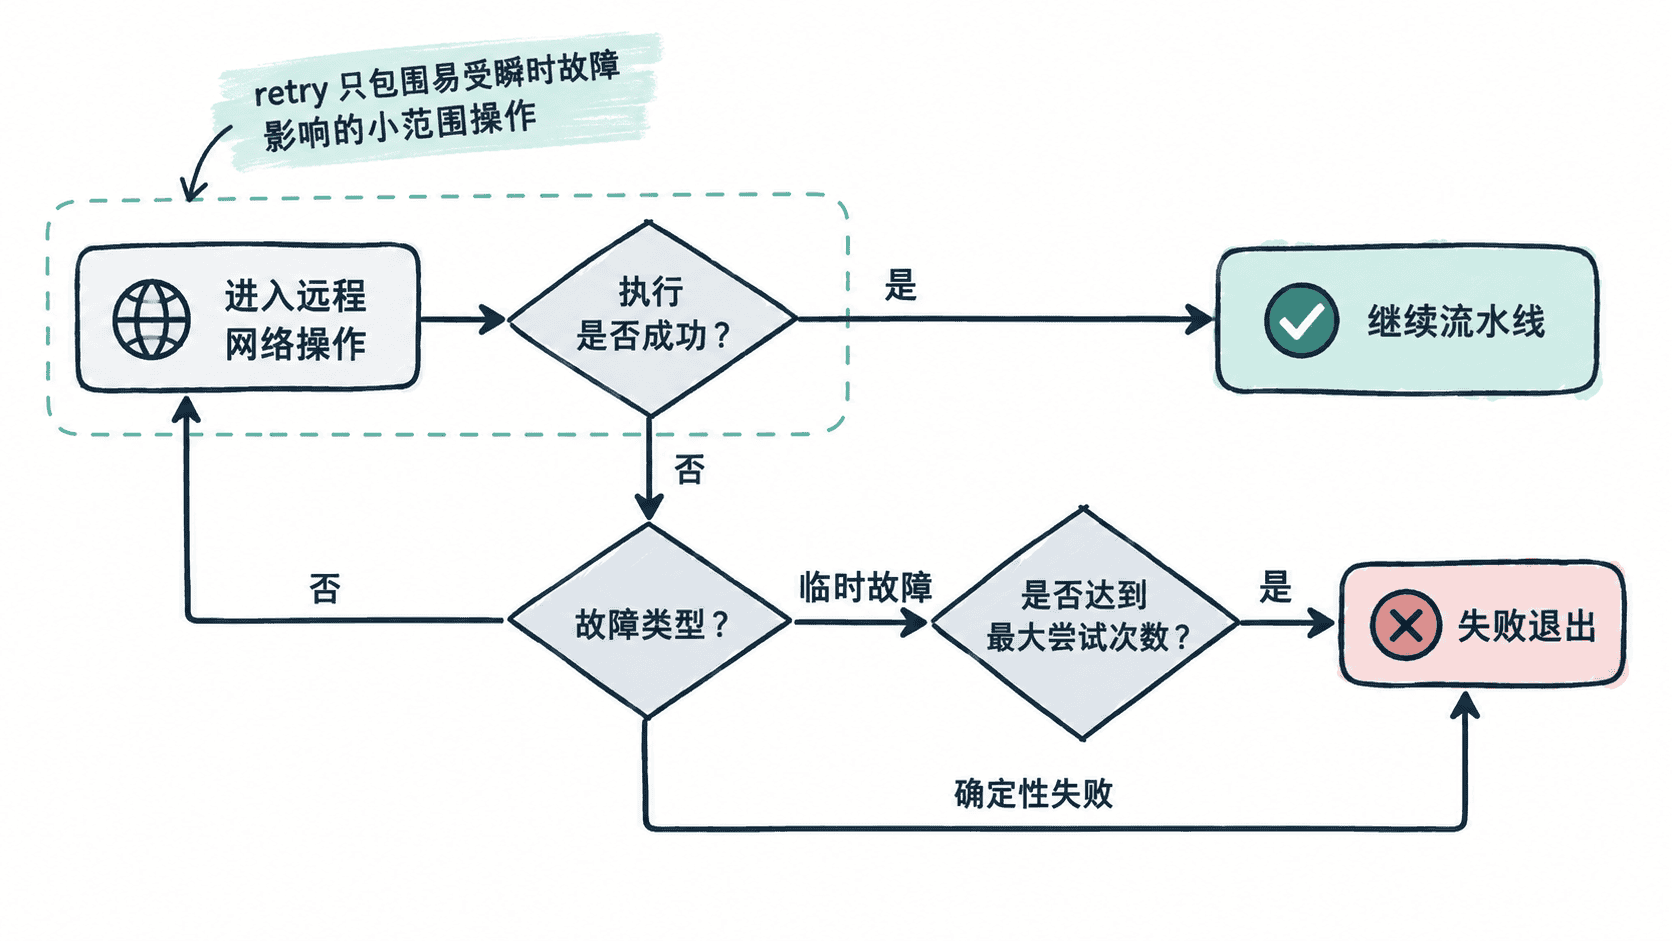
Jenkins Pipeline 的 retry(count) 会执行闭包中的步骤;只要其中抛出错误,Jenkins 就重新执行整个闭包,直到某次成功或达到指定次数。count 表示总尝试次数,而不是首次失败后额外重试的次数。
因此,重试块应该尽可能小,只包围具有瞬时失败特征的操作。例如从远程制品服务下载文件、访问偶尔超时的内部服务,可以有限重试;编译失败、单元测试断言失败、配置语法错误通常具有确定性,再执行相同输入不会改变结果。
把重试限制在临时故障操作
下面的 Declarative Pipeline 使用 retry(3) 包围一次 HTTP 健康检查。curl --fail 在 HTTP 4xx、5xx 或连接失败时返回非零退出码,sh 因而使当前尝试失败并触发下一次尝试。
pipeline {
    agent any

    stages {
        stage('Check service') {
            steps {
                retry(3) {
                    // 仅重试可能受网络或远程服务状态影响的操作
                    sh 'curl --fail --silent --show-error --max-time 10 https://example.com/'
                }
            }
        }
    }
}
预期结果:如果请求第一次就成功,该步骤只执行一次并继续流水线;如果前面的尝试返回非零退出码而后续尝试成功,则阶段最终成功;连续 3 次均失败时,retry 结束并让阶段失败。具体 Jenkins 日志文本和请求耗时可能因版本、执行器及网络环境不同而变化。
成功场景:Check service -> SUCCESS
连续 3 次请求失败:Check service -> FAILURE
这里没有把整个构建阶段放入 retry。否则远程请求失败一次,就可能重新执行编译、测试等已经完成且成本更高的工作。
不要重试确定性失败
是否重试的关键不是“这一步重要不重要”,而是在输入和环境没有变化时,再执行一次是否有合理机会成功。网络连接被短暂重置、服务瞬间过载等故障可能满足这个条件;源代码无法编译、测试断言不成立通常不满足。
例如下面的写法虽然语法成立,但策略通常不合理:
retry(3) {
    sh './gradlew test'
}
预期结果:如果同一版本代码存在稳定复现的测试失败,Jenkins 会重复运行相同测试,最终仍然失败,同时增加反馈时间。
Attempt 1: test failed
Attempt 2: test failed
Attempt 3: test failed
Pipeline: FAILURE
只有测试本身确实依赖不稳定的外部资源,并且团队已经确认失败属于瞬时故障时,才应考虑针对那个不稳定边界治理,而不是默认重试整个测试集。
给重试设置明确上限
自动恢复必须有退出条件。次数过多会把真正的服务故障拖成长时间等待,还可能持续向已经过载的依赖发送请求。实践中应根据操作成本、故障持续时间和流水线时限选择较小的尝试次数,并结合 timeout 控制总等待时间。
重试的价值在于吸收短暂且再次执行可能恢复的故障,而不是让所有红灯多跑几遍。将 retry 紧贴不稳定的外部边界、限制尝试次数,并让确定性错误立即暴露,才能同时获得恢复能力和清晰的失败信号。