
FPGA 与数字 IC 设计 / 系统课时
组合 NAND 门构造基本运算
组合 NAND 门构造基本运算
只使用一种与非门(NAND),就能搭建非门、与门和或门,并进一步实现任意组合逻辑。本篇从二输入 NAND 的真值表出发,逐个推导门级连接方式,计算所需门数,最后用完整的 Verilog 仿真核对各电路与原始布尔表达式是否等价。
学习目标
- 掌握 NAND 的真值表及其实现 NOT、AND、OR 的连接方法。
- 能够根据布尔表达式绘制 NAND 门级结构,并计算基本门数。
- 使用 Verilog 仿真遍历输入组合,验证 NAND 实现的逻辑等价性。
从 NAND 真值表理解基本能力
二输入 NAND 的输出是两个输入先进行 AND,再取反:
只有 A、B 同时为 1 时,输出才为 0。其余输入组合均输出 1。
| A | B | A AND B | A NAND B |
|---|---|---|---|
| 0 | 0 | 0 | 1 |
| 0 | 1 | 0 | 1 |
| 1 | 0 | 0 | 1 |
| 1 | 1 | 1 | 0 |
NAND 被称为通用门,是因为仅使用 NAND,就能构造 NOT、AND、OR,而这三种运算足以表达任意组合布尔函数。这里的通用性指逻辑功能完整,并不代表所有 NAND 实现的晶体管数量、延迟或功耗都最优。
推导电路时,可把每个 NAND 视为一个具有两个输入端、一个输出端的独立逻辑门。允许一个信号同时连接到同一个 NAND 的两个输入端,这正是构造 NOT 的关键。
用 NAND 实现 NOT 和 AND
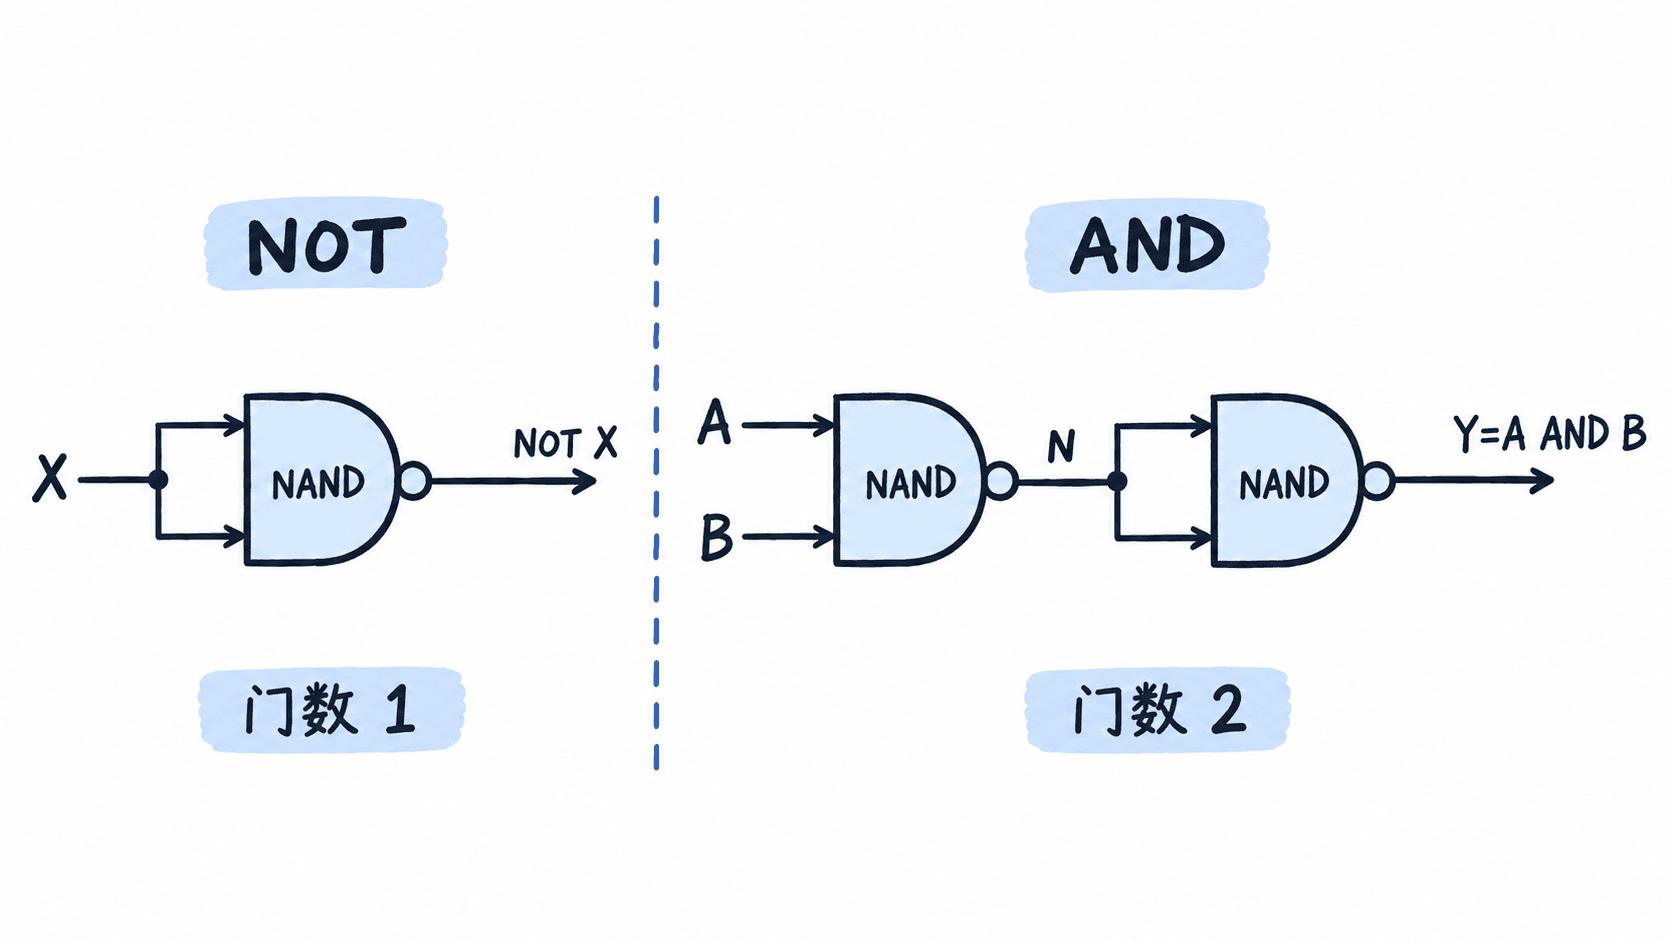
一个 NAND 实现 NOT
将 NAND 的 A、B 输入端短接到同一个信号 X:
因为 ,所以一个二输入 NAND 就能成为反相器。X 为 0 时输出 1,X 为 1 时输出 0。这个实现需要 1 个 NAND,逻辑深度为 1 级。
两个 NAND 实现 AND
首先使用 NAND 得到 AND 的反相信号,再使用一个输入短接的 NAND 恢复极性:
因此,AND 需要 2 个二输入 NAND,最长逻辑路径经过 2 级。不能直接把第一个 NAND 的输出当作 AND,因为 A=B=1 时,NAND 输出为 0,而 AND 应输出 1。
用德摩根定律实现 OR
OR 不能简单地把 NAND 的输出直接当成结果。例如 A=0、B=0 时,OR 应为 0,但 NAND 输出为 1。
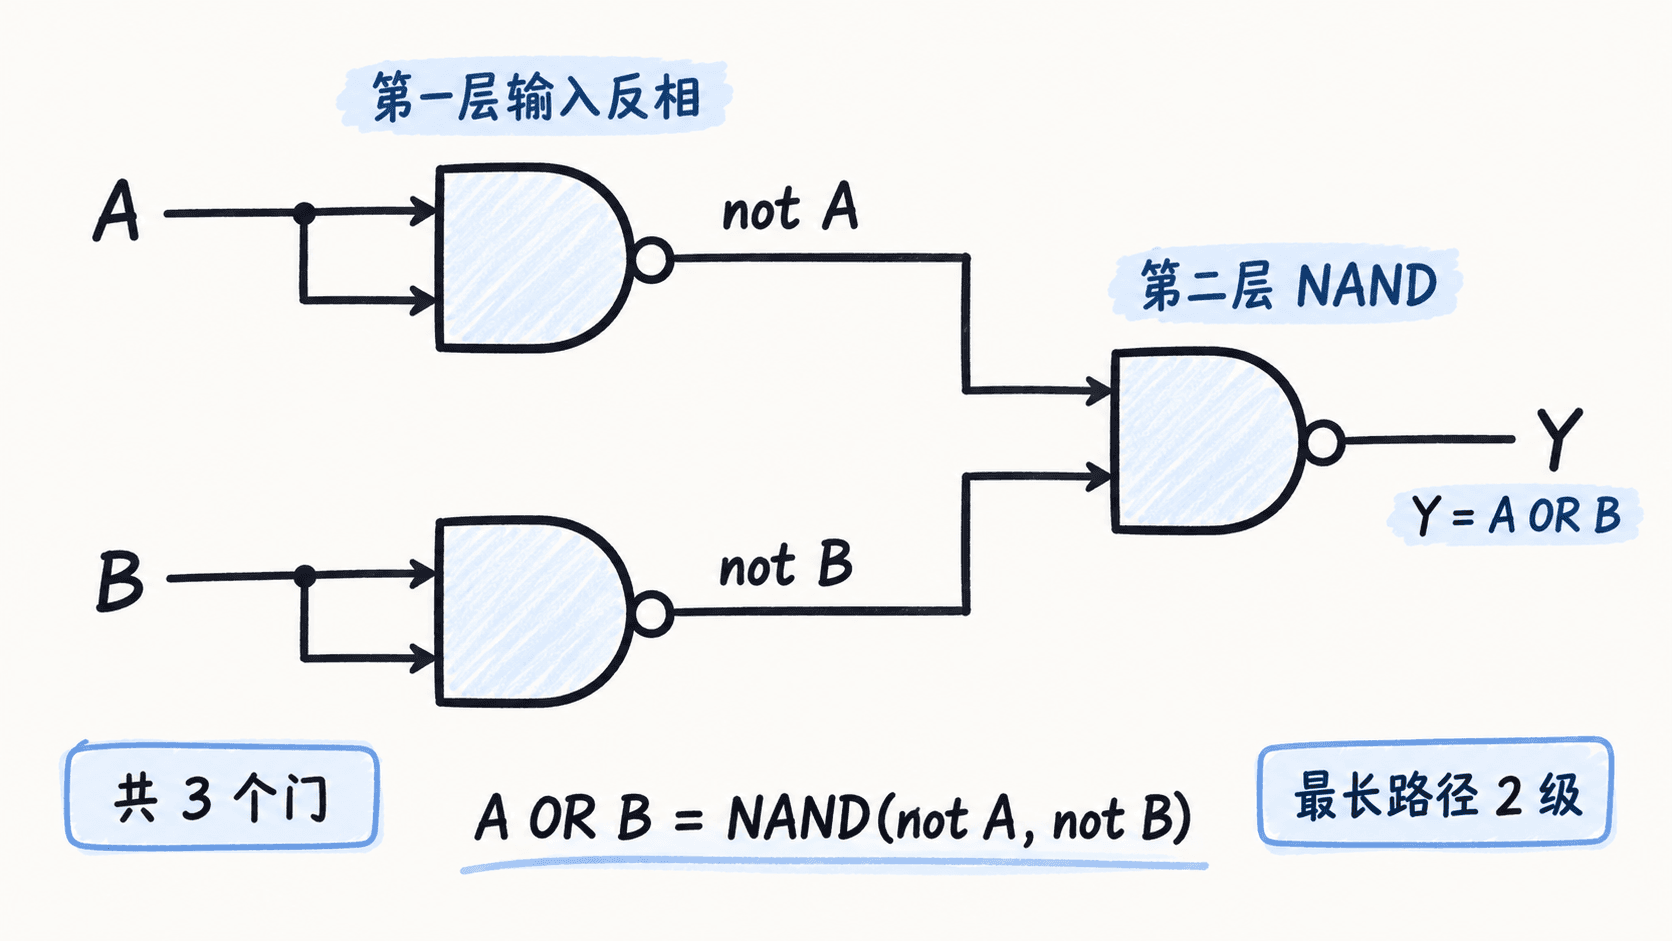
利用德摩根定律,可以把 OR 改写成只包含 NAND 的形式:
按这个等式连接 3 个 NAND:
- 第一个 NAND 将 A 同时接入两个输入端,生成 。
- 第二个 NAND 将 B 同时接入两个输入端,生成 。
- 第三个 NAND 接收两个反相信号,输出 。
总门数为 3,输入到输出最长经过 2 级。这里的 表示逻辑 OR,不是二进制加法器中的整数加法。
三种基本运算的资源对比如下,均假设仅有二输入 NAND 可用且不复用其他电路的中间信号。
| 目标运算 | NAND 数量 | 最长逻辑级数 |
|---|---|---|
| NOT | 1 | 1 |
| AND | 2 | 2 |
| OR | 3 | 2 |
实际优化组合逻辑时,应先化简整个函数,再映射到 NAND 网络。逐个替换原来的 AND、OR、NOT 虽然正确,却可能产生可以合并的重复反相级。
将复合表达式映射为 NAND 网络
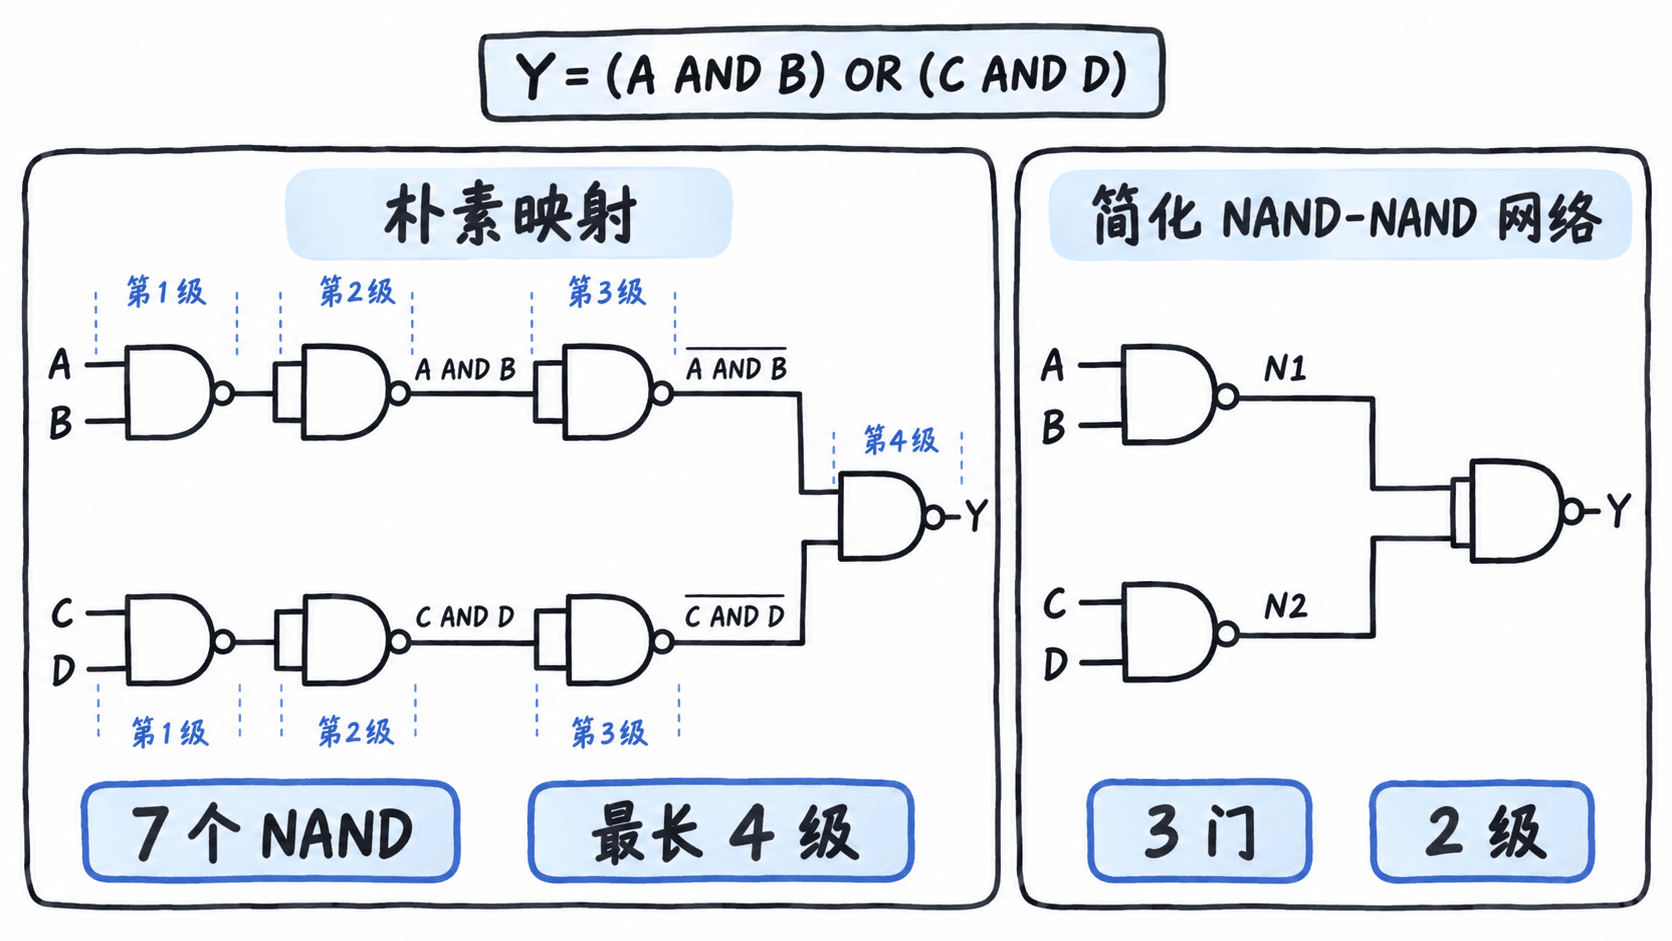
考虑二输入乘积项的或运算:
直接构造两个 AND 再构造一个 OR,需要 2+2+3=7 个 NAND。但是根据德摩根定律,可以减少到 3 个 NAND:
两个第一层 NAND 分别产生乘积项的反相结果,第二层 NAND 直接完成合并。该结构仅需要 3 个 NAND,最长经过 2 级,比机械替换节省 4 个门。
使用 Verilog 验证门级等价性
下面的示例使用 Verilog-2001,适用于 Icarus Verilog。所有目标函数仅通过 nand 门原语实现;测试平台遍历 A、B、C、D 的 16 种二进制输入组合,并与 Verilog 逻辑表达式进行比较。
将以下代码保存为 nand_demo.v:
module nand_demo;
    reg a, b, c, d;
    wire y_not, y_and, y_or, y_sop;
    wire n_and, na, nb, n1, n2;
    integer i;
    integer errors;

    // 输入短接构造反相器;双 NAND 构造 AND。
    nand g0(y_not, a, a);
    nand g1(n_and, a, b);
    nand g2(y_and, n_and, n_and);

    // 对输入分别取反,再使用 NAND 构造 OR。
    nand g3(na, a, a);
    nand g4(nb, b, b);
    nand g5(y_or, na, nb);

    // 两层 NAND 直接实现积之和。
    nand g6(n1, a, b);
    nand g7(n2, c, d);
    nand g8(y_sop, n1, n2);

    initial begin
        errors = 0;
        for (i = 0; i < 16; i = i + 1) begin
            {a, b, c, d} = i;
            #1; // 等待组合门传播结果稳定。
            if (y_not !== ~a ||
                y_and !== (a & b) ||
                y_or !== (a | b) ||
                y_sop !== ((a & b) | (c & d)))
                errors = errors + 1;
        end
        if (errors == 0)
            $display("PASS: 16 vectors, 0 mismatches");
        else
            $display("FAIL: %0d mismatches", errors);
        $finish;
    end
endmodule
在安装了 iverilog 与 vvp 的终端中执行:
iverilog -g2001 -s nand_demo -o nand_demo.vvp nand_demo.v
vvp nand_demo.vvp
预期输出:
PASS: 16 vectors, 0 mismatches{a, b, c, d} = i 把 0~15 依次分配给四个输入。每次修改输入后等待 1 个仿真时间单位,再使用 !== 进行四态比较;一旦结果出现 X、Z 或与预期不符,就会计为不匹配。
通过测试表示该电路在全部 16 种二值输入组合下与参考表达式一致,但并不意味着已经验证实际芯片的传播延迟、建立保持时间或功耗。后续进行综合时,还要核对标准单元映射和时序报告。
门数、延迟与实际映射的边界
门数能够快速衡量逻辑结构,却不能直接等同于真实芯片面积。不同标准单元库中的 NAND2、INV、AND2 和 OR2,面积、输入电容、输出驱动能力与传播延迟可能不同。
假设所有 NAND 的传播延迟都简化为 40 ps,且忽略连线和负载影响,则刚才的 NAND 实现可以估算为:
| 电路 | 最长级数 | 理想化延迟 |
|---|---|---|
| NOT | 1 | 40 ps |
| AND | 2 | 80 ps |
| OR | 2 | 80 ps |
| 优化后的积之和 | 2 | 80 ps |
40 ps 只是教学假设,不是某个工艺库的保证值。真实延迟还与具体输入引脚、输入转换时间、输出负载和布线寄生参数相关;多级电路也不能简单地把固定延迟无限相加。
另外,NAND 构造的 NOT 是功能等价,而非物理上一定优于专用 INV 单元。综合工具通常会依据技术库和时序约束选择具体实现,甚至重新组织逻辑网络,因此 RTL 中实例化的门结构不一定逐个原样保留到最终网表。
实际设计时,可先使用 NAND 真值表确认功能,再用德摩根定律消除不必要的反相级,最后通过穷举仿真或形式等价检查验证逻辑。对于本例,3 个 NAND 构成的两级网络已经比逐门替换的 7 门结构更简洁。