
FPGA 与数字 IC 设计 / 系统课时
用参考模型比对架构寄存器状态
用参考模型比对架构寄存器状态
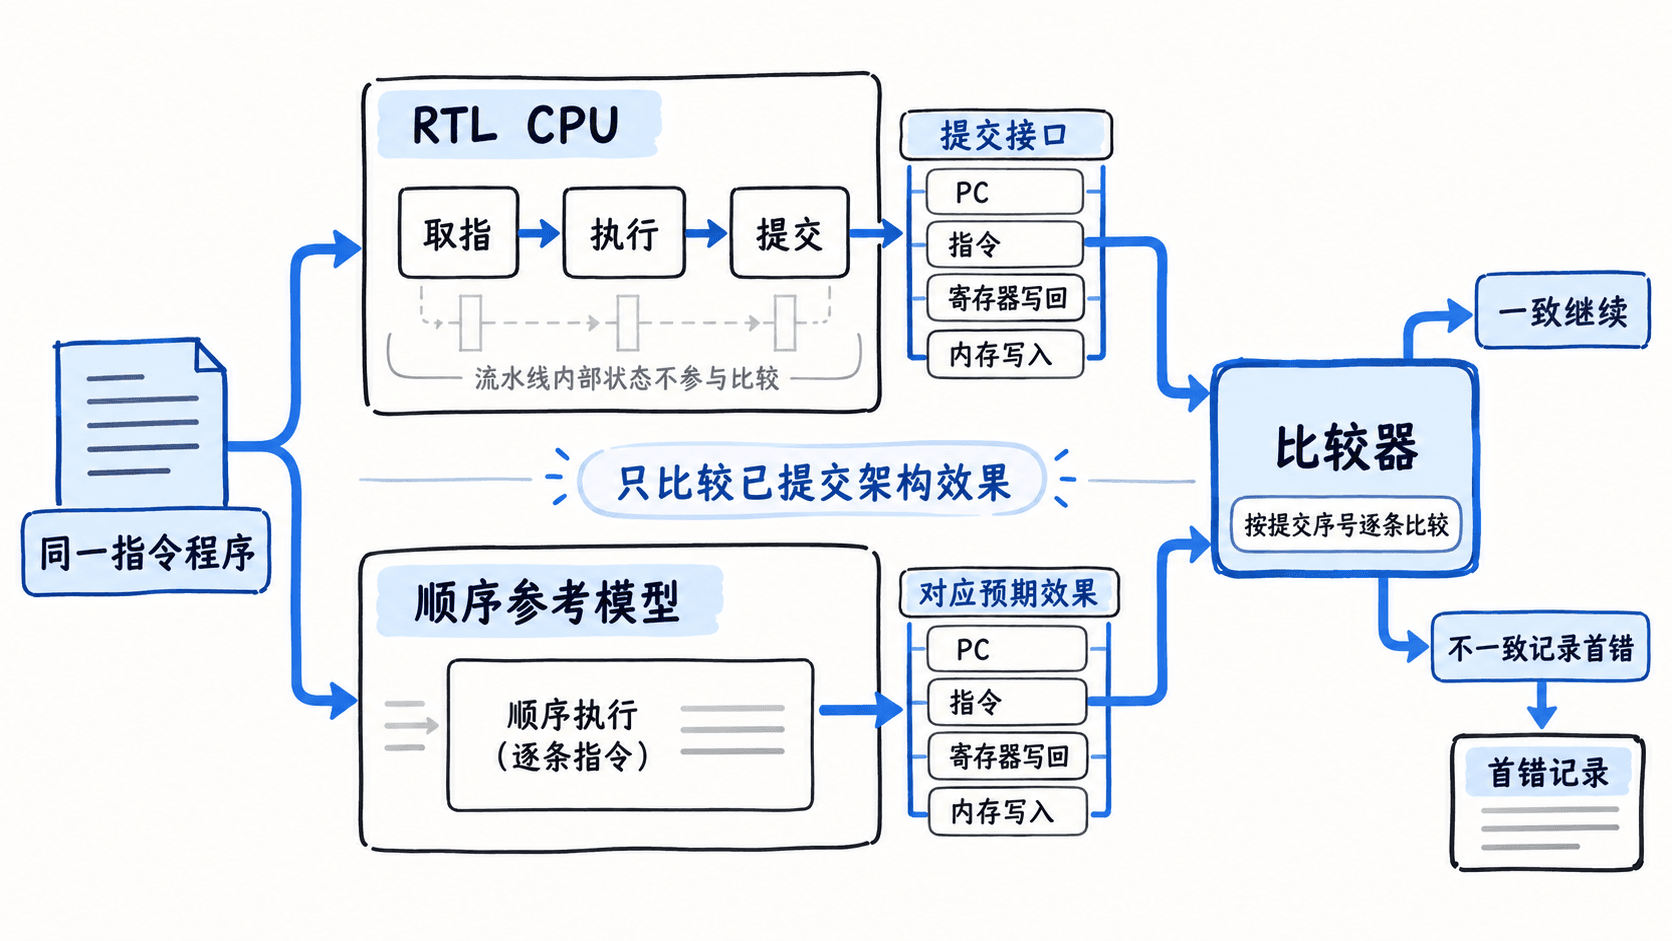
CPU 仿真波形看起来正常,并不代表指令执行结果正确。本课搭建一个最小参考模型,在每条指令提交时比较 PC、通用寄存器和内存写入效果,识别算术错误、写回错误、跳转错误和重复提交,并建立能够定位第一条错误指令的检查方法。
学习目标
- 区分架构状态与流水线内部状态,确定指令提交时需要比较的字段。
- 使用 Python 参考模型逐条执行指令,并与 RTL 提交记录进行比对。
- 根据首个不一致字段定位故障,并处理复位、存储器副作用和提交顺序等边界。
确定比较时刻与架构状态
架构状态是软件能够观察到的 CPU 状态,通常包括程序计数器、通用寄存器以及可见内存。流水线级间寄存器、旁路选择信号和暂停计数属于微架构状态,不要求与参考模型相同。
对于顺序提交的简单 CPU,推荐在指令真正退休或提交时进行比较,而不是在取指或执行阶段比较。因为流水线可能发生停顿、冲刷或重执行,取到的指令并不一定最终生效。
每条提交记录至少包含以下信息:
| 字段 | 含义 | 检查方式 |
|---|---|---|
pc |
本条提交指令的地址 | 与参考模型当前 PC 比较 |
instr |
提交的指令编码 | 与参考模型预期指令比较 |
rd |
目的寄存器编号 | 与预期写回目标比较 |
rd_value |
写回数据 | 在寄存器写使能时比较 |
mem_addr |
存储写地址 | 存储指令提交时比较 |
mem_data |
存储写入数据 | 存储指令提交时比较 |
还需要分别提供 rd_we 和 mem_we,避免把未写回时残留的总线值误判成架构效果。比较器应维护独立的参考寄存器和参考内存,而不是读取 DUT 当前状态作为预期值。
搭建可运行的最小差分测试
下面使用教学用指令集演示检查器,而不是声称它覆盖完整 RISC-V。定义三条指令:LI rd, imm 将立即数写入寄存器,ADD rd, rs1, rs2 进行 32 位加法,STORE rs, addr 将寄存器数据写入内存。所有指令长度固定为 4 字节,初始 PC 为 0,寄存器 r0 恒为 0。
为使示例独立运行,指令编码使用字符串元组代替真实机器码,提交记录也使用 Python 字典模拟 RTL 导出的事件。真实工程可以把事件来源替换为仿真器导出的 JSON Lines 或 DPI-C 接口。
from dataclasses import dataclass, field

MASK = 0xFFFFFFFF

@dataclass
class ReferenceCPU:
    pc: int = 0
    regs: list = field(default_factory=lambda: [0] * 8)
    memory: dict = field(default_factory=dict)

    def step(self, instruction):
        op, *args = instruction
        event = {"pc": self.pc, "instr": instruction,
                 "rd_we": False, "rd": 0, "rd_value": 0,
                 "mem_we": False, "mem_addr": 0, "mem_data": 0}

        if op == "LI":
            rd, imm = args
            value = imm & MASK
        elif op == "ADD":
            rd, rs1, rs2 = args
            value = (self.regs[rs1] + self.regs[rs2]) & MASK
        elif op == "STORE":
            rs, addr = args
            if addr % 4 != 0:
                raise ValueError("unaligned store")
            event.update(mem_we=True, mem_addr=addr,
                         mem_data=self.regs[rs])
        else:
            raise ValueError(f"unsupported instruction: {op}")

        if op in ("LI", "ADD") and rd != 0:
            self.regs[rd] = value
            event.update(rd_we=True, rd=rd, rd_value=value)

        # 参考模型仅在一条指令完成后推进架构 PC。
        self.pc = (self.pc + 4) & MASK
        return event


def compare(expected, actual, index):
    fields = ["pc", "instr", "rd_we", "mem_we"]
    if expected["rd_we"]:
        fields += ["rd", "rd_value"]
    if expected["mem_we"]:
        fields += ["mem_addr", "mem_data"]
    for key in fields:
        if expected[key] != actual[key]:
            raise AssertionError(
                f"commit {index}: {key}: "
                f"expected={expected[key]!r}, actual={actual[key]!r}"
            )


program = [("LI", 1, 7), ("LI", 2, 5),
           ("ADD", 3, 1, 2), ("STORE", 3, 0x100)]

# 模拟来自 DUT 的四条提交记录;真实工程应接入 RTL 提交事件。
dut = [
    {"pc": 0, "instr": program[0], "rd_we": True, "rd": 1,
     "rd_value": 7, "mem_we": False},
    {"pc": 4, "instr": program[1], "rd_we": True, "rd": 2,
     "rd_value": 5, "mem_we": False},
    {"pc": 8, "instr": program[2], "rd_we": True, "rd": 3,
     "rd_value": 12, "mem_we": False},
    {"pc": 12, "instr": program[3], "rd_we": False,
     "mem_we": True, "mem_addr": 0x100, "mem_data": 12},
]

reference = ReferenceCPU()
for index, (instruction, actual) in enumerate(zip(program, dut)):
    expected = reference.step(instruction)
    compare(expected, actual, index)
    if expected["mem_we"]:
        reference.memory[expected["mem_addr"]] = expected["mem_data"]
    print(f"commit {index}: PASS")

assert reference.regs[3] == 12
assert reference.memory[0x100] == 12
print("ALL PASS: 4 commits")
预期输出:
commit 0: PASS
commit 1: PASS
commit 2: PASS
commit 3: PASS
ALL PASS: 4 commits
将第三条 DUT 记录中的 rd_value 从 12 改为 13 后重新运行,预期在提交序号 2 报错,而不会继续检查第四条指令:
AssertionError: commit 2: rd_value: expected=12, actual=13此时应优先检查 ADD 的运算结果、操作数旁路和写回通路,而不是直接根据最终内存值倒推故障。示例中 reference.memory 记录的是参考模型期望的写入结果;真实工程还必须独立检查 DUT 的存储提交事件或最终内存镜像。
将参考模型接入 RTL 提交接口
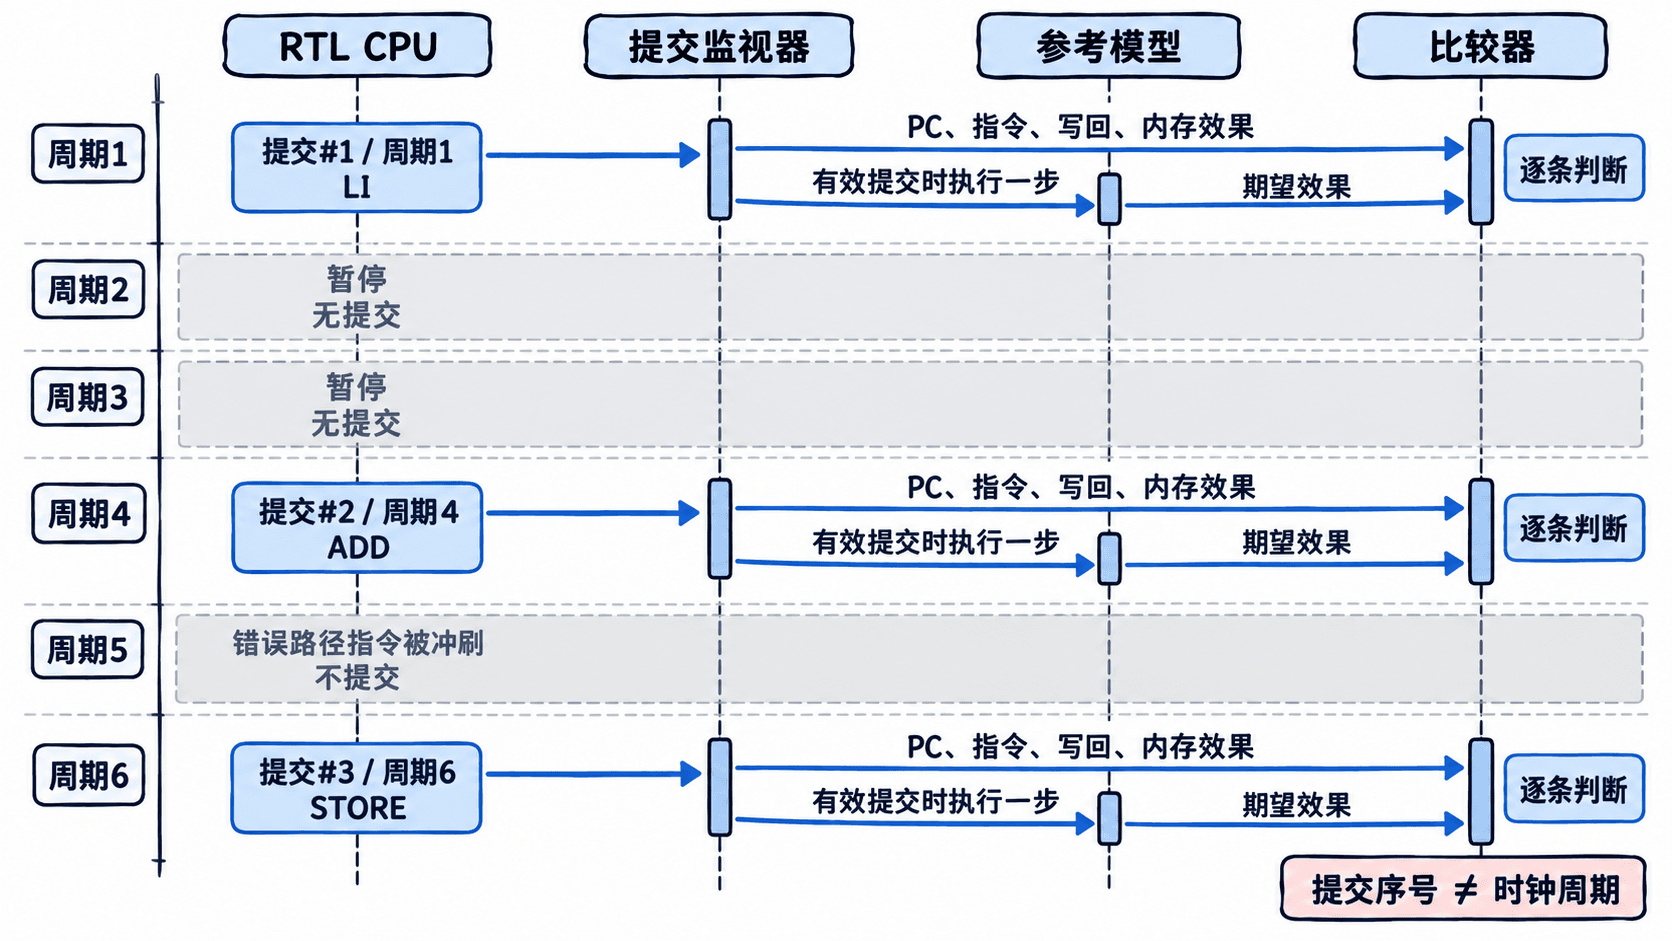
实际 RTL 的周期数通常与参考模型执行步数不同。正确做法是 RTL 每发生一次有效提交,就让参考模型执行一条指令,而不是每个时钟周期执行一条。
对单发射、顺序退休 CPU,可采用如下接入顺序:
- 复位 DUT 与参考模型,统一初始 PC、寄存器和可见内存内容。
- 仿真器每个时钟沿采样
commit_valid。只有为 1 时才产生一条记录。 - 提取提交 PC、原始指令、寄存器写使能、写回值与存储效果。
- 用本条 PC 找到参考指令,先比较 PC 和指令,再执行参考模型并比较写回效果。
- 第一处不一致立即保存提交序号、期望值、实际值及附近的波形窗口。
对于带跳转的 CPU,参考模型必须根据指令语义更新下一条 PC,不能继续使用示例里的固定 pc + 4。建议把 pc 明确定义为当前退休指令地址,把 next_pc 定义为其架构后继地址,避免在跳转检查中混用两者。完整 ISA 参考模型还需实现其规定的异常、CSR 和访存语义。
如果使用 SystemVerilog,可在测试平台中采样提交接口。下面是片段示例,依赖 DUT 已导出 clk、rst_n、commit_valid、commit_pc、commit_instr 等信号,以及测试平台自行实现的 check_commit 比较任务;它不是独立可运行的 testbench。
always @(posedge clk) begin
    if (rst_n && commit_valid) begin
        // 只检查真正退休的指令,忽略停顿与冲刷周期。
        check_commit(commit_pc, commit_instr,
                     commit_rd_we, commit_rd,
                     commit_rd_data, commit_mem_we,
                     commit_mem_addr, commit_mem_data);
    end
end
预期行为是每个 commit_valid 周期执行一次检查任务,失败时通过测试平台报告首个不一致字段。检查器接收的是架构退休事件,而不是可能被取消的早期流水线结果。
检查内存副作用与特殊边界
内存比较必须区分架构可见的存储操作与内部总线写请求。带写缓冲的 CPU 可能在指令退休后才真正更新物理 RAM;此时需要比较已确认提交的存储意图,并在适当同步点检查最终内存,而不是要求物理写入周期与参考模型一致。
| 边界情况 | 推荐检查规则 |
|---|---|
| 写入零寄存器 | r0 仍为 0,不应产生架构寄存器写回 |
| 被冲刷的指令 | 不产生提交,不推进参考模型 |
| 连续相同 PC | 允许合法循环,但每次提交均需比对 |
| 非对齐存储 | 按目标 ISA 的异常或访问规则处理 |
| 字节与半字写入 | 比较地址、数据和字节写掩码 |
| MMIO 写操作 | 检查设备可见事件,避免重复执行设备副作用 |
| 异常和中断 | 比较异常原因、异常 PC 与入口状态 |
上面的 Python 示例仅支持对齐的 32 位存储,不支持字节掩码、加载、异常或乱序退休。迁移到实际 CPU 时,应根据 ISA 扩展这些字段,不能把示例结果当成完整 CPU 正确性的证明。
对于可能产生缓存未命中或总线延迟的加载操作,参考模型应以统一初始化的内存状态计算预期值。涉及异步外设输入或非确定性数据时,需要向双方注入相同输入,或按约定对不可确定字段进行掩码处理。
利用首个错误定位 RTL 缺陷
假设回归运行到第 137 次提交时出现:PC 和指令正确,目标寄存器也是 r5,但参考写回值为 0x0000000C,RTL 写回值为 0x0000000D。推荐按证据顺序定位:
- 首先确认第 137 次提交是否与参考模型的同一条指令对齐,避免前一条丢提交引起后续全部错位。
- 查看该指令源寄存器的参考值与 RTL 读值。若输入已经不同,向前追踪首次写入该寄存器的提交。
- 如果输入相同而 ALU 输出错误,检查操作码译码、位宽、符号扩展与运算选择。
- 如果 ALU 输出正确但提交值错误,检查写回多路选择器、旁路网络和寄存器写使能。
- 修复后重新运行原测试,并增加覆盖同类型数据相关或跳转情况的定向用例。
为了避免回归测试无限等待,测试平台还应设置两类终止条件:例如最多等待 10000 个时钟周期,以及连续 200 个周期没有提交时判定为潜在死锁。阈值是教学示例,需要根据目标 CPU 的访存延迟、休眠机制和正常执行行为调整,不能将合法等待直接认定为失败。
最后应分别统计实际提交指令数、参考模型执行步数、首错提交序号和回归是否正常结束。对于本课单发射顺序退休的四条指令示例,验收条件是两侧均处理 4 条指令、所有提交效果一致,并且 r3=12、内存地址 0x100 中的字为 12。差分测试能够发现参考模型与 RTL 的执行分歧,但两者一致不代表程序覆盖充分;仍需结合定向测试、覆盖率与独立的 ISA 合规测试。