
FPGA 与数字 IC 设计 / 系统课时
建立汇编到机器码的测试入口
建立汇编到机器码的测试入口
CPU 回归测试不能只靠手工填写机器码,否则修改指令编码后,很容易出现测试程序与硬件译码不一致的问题。这里建立一个最小的汇编转换入口:使用 Python 将固定的短汇编程序转换为存储器初始化文件,再由 Verilog 仿真读取,确保每次测试运行的是同一组可追溯指令。
学习目标
- 为一个简化 CPU 定义明确的汇编语法和机器码编码规则。
- 编写可执行的汇编转换脚本,生成 Verilog 可读取的十六进制初始化文件。
- 通过指令解码检查与仿真加载验证生成结果,并固定回归测试用例。
固定测试指令集与编码格式
为了让示例不依赖特定厂商 CPU,使用一个教学用的 16 位定长指令集。它不是 RISC-V 或其他标准 ISA,只有在 CPU 的译码逻辑实现相同编码规则时才能直接执行。
| 指令 | 操作码 | 语义 | 格式 |
|---|---|---|---|
| NOP | 0x0 | 无操作 | 0000 0000 0000 0000 |
| LDI Rd, imm | 0x1 | 把立即数写入寄存器 | opcode[15:12]、Rd[11:8]、imm[7:0] |
| ADD Rd, Rs | 0x2 | Rd = Rd + Rs | opcode[15:12]、Rd[11:8]、Rs[7:4]、低 4 位为 0 |
| HALT | 0xF | 停止执行 | 1111 0000 0000 0000 |
约定寄存器只有 R0~R3,立即数是 0~255 的无符号整数。ADD 的结果截断为 8 位,超出 255 时自然回绕。每条指令占用一个 16 位存储器字,PC 每执行一条普通指令加 1。
例如 LDI R1, 7 的编码是 0x1107,ADD R1, R2 的编码是 0x2120。先定义编码,再编写汇编器,可以避免根据预期输出倒推机器码。
编写最小汇编转换器
创建目录 cpu-regression,在其中保存以下 assembler.py。脚本采用 Python 3.10 及以上版本,仅依赖标准库;支持空行、分号注释、大小写不敏感的指令名,以及十进制或 0x 前缀的立即数。
import argparse
import re
from pathlib import Path

REGISTERS = {f"R{i}": i for i in range(4)}


def assemble_line(line: str) -> int | None:
    line = line.split(";", 1)[0].strip().upper()
    if not line:
        return None

    parts = [p for p in re.split(r"[\s,]+", line) if p]
    op, args = parts[0], parts[1:]

    if op in ("NOP", "HALT") and not args:
        return 0x0000 if op == "NOP" else 0xF000

    if op == "LDI" and len(args) == 2:
        rd = REGISTERS[args[0]]
        imm = int(args[1], 0)
        if not 0 <= imm <= 255:
            raise ValueError("立即数必须在 0~255 之间")
        return 0x1000 | (rd << 8) | imm

    if op == "ADD" and len(args) == 2:
        rd, rs = (REGISTERS[name] for name in args)
        return 0x2000 | (rd << 8) | (rs << 4)

    raise ValueError(f"不支持的指令或操作数: {line}")


def main() -> None:
    parser = argparse.ArgumentParser()
    parser.add_argument("source", type=Path)
    parser.add_argument("output", type=Path)
    args = parser.parse_args()

    words = []
    for number, line in enumerate(args.source.read_text(encoding="utf-8").splitlines(), 1):
        try:
            word = assemble_line(line)
            if word is not None:
                words.append(word)
        except (ValueError, KeyError) as exc:
            raise SystemExit(f"第 {number} 行错误: {exc}") from exc

    # 每行一个 16 位存储器字,适配 $readmemh
    args.output.write_text(
        "".join(f"{word:04X}\n" for word in words),
        encoding="ascii",
    )
    print(f"已生成 {len(words)} 条指令: {args.output}")


if __name__ == "__main__":
    main()
assemble_line 只负责一条指令的编码,文件读取、错误定位及输出由 main 负责。遇到未知寄存器、参数数量错误或立即数越界时直接终止,不要悄悄截断输入,否则错误测试可能被转换成合法但意义不同的机器码。
生成固定的存储器镜像
创建 smoke.asm,编写一段能检查立即数加载、寄存器加法和停机的最小程序。
; 预期 R1 = 7 + 5 = 12
LDI R1, 7
LDI R2, 5
ADD R1, R2
HALT
在该目录执行:
python3 assembler.py smoke.asm smoke.hex预期输出:
已生成 4 条指令: smoke.hex生成的 smoke.hex 内容应当严格为:
1107
1205
2120
F000
这里的每一行对应一个存储器地址,而不是一个字节。采用 16 位宽的 Verilog 存储器时,地址 0 存放 0x1107,地址 1 存放 0x1205,依次类推。若实际 CPU 的指令存储器是 8 位宽,就必须重新规定高低字节的排列方式,不能直接复用这个文件。
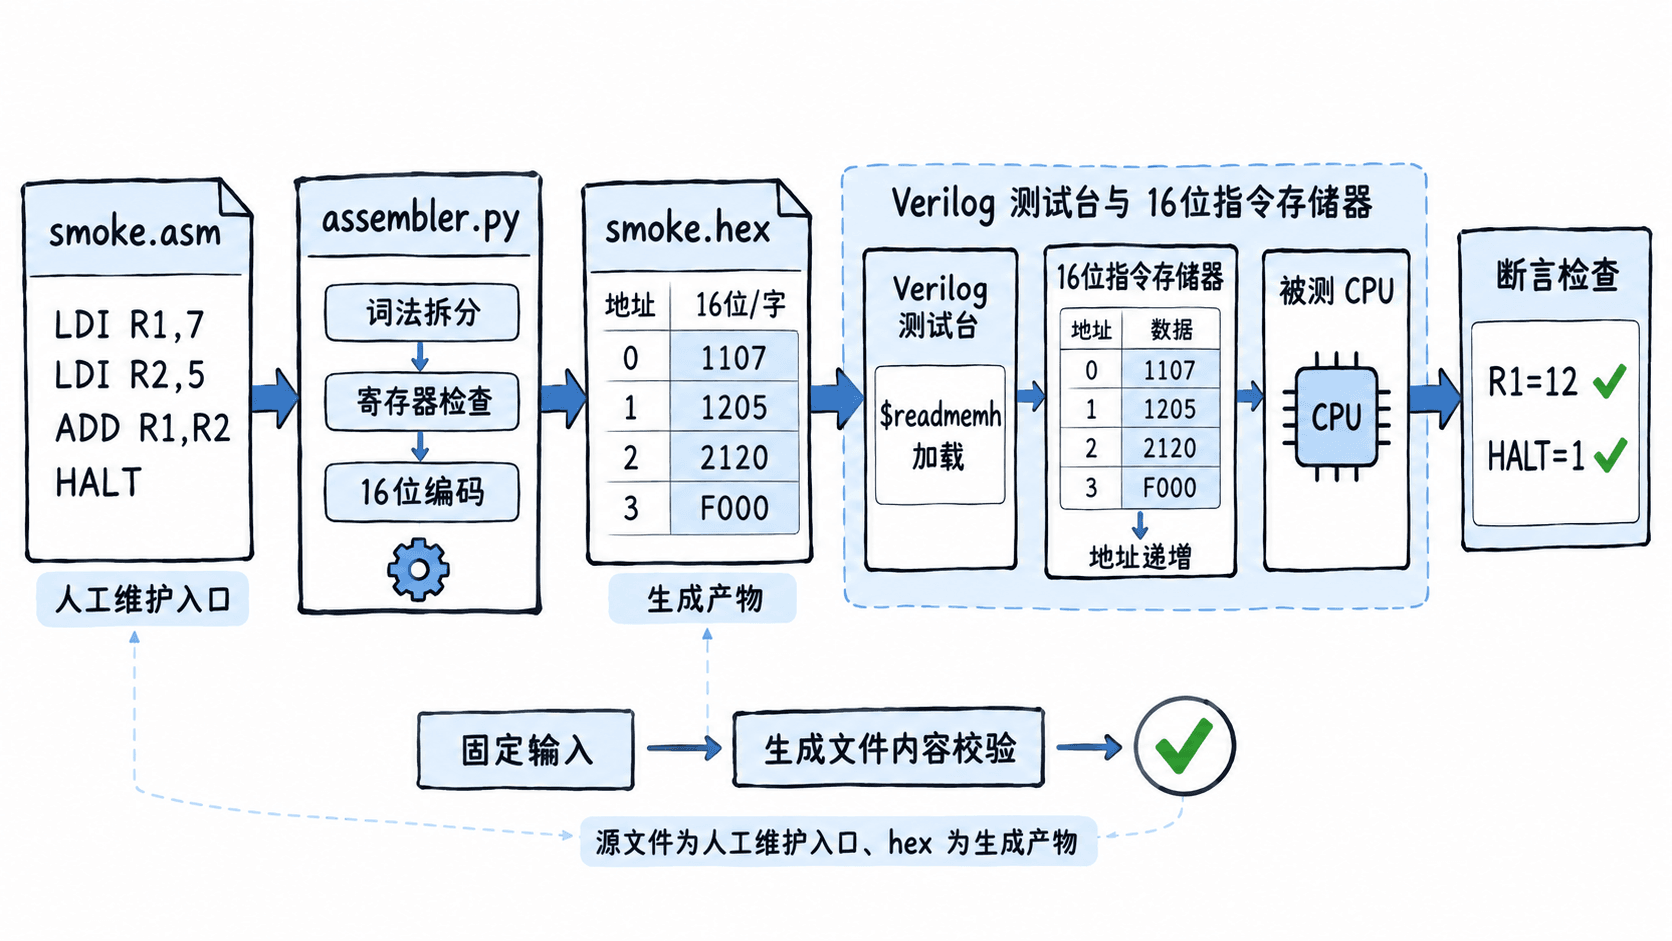
从源文件到仿真运行的完整关系如下。汇编源文件是用例的唯一人工维护入口,机器码文件是可重复生成的产物,测试台同时检查指令内容和最终执行状态。
验证 Verilog 能正确加载指令
下面使用 Icarus Verilog 验证存储器加载链路。此处先检查机器码文件与编码规则,不假设已经存在完整 CPU;后续可将存储器接到实际取指模块。
创建 tb_memory.v,使用 $readmemh 把每行十六进制数据加载到 16 位存储器,然后用严格相等比较逐字检查。
module tb_memory;
    reg [15:0] imem [0:3];
    integer i;
    reg [15:0] expected [0:3];

    initial begin
        // 固定期望值,与汇编程序的编码规则一致
        expected[0] = 16'h1107;
        expected[1] = 16'h1205;
        expected[2] = 16'h2120;
        expected[3] = 16'hF000;

        $readmemh("smoke.hex", imem);
        for (i = 0; i < 4; i = i + 1) begin
            if (imem[i] !== expected[i]) begin
                $display("FAIL addr=%0d", i);
                $fatal(1);
            end
        end
        $display("PASS: 4 instruction words verified");
        $finish;
    end
endmodule
在安装了 Icarus Verilog 的环境中,于 cpu-regression 目录执行:
iverilog -g2012 -s tb_memory -o tb_memory.vvp tb_memory.v
vvp tb_memory.vvp
预期输出:
PASS: 4 instruction words verified这说明汇编到存储器加载的路径正确,但还不能证明 CPU 真正完成了计算。把程序接入 CPU 之后,需要让测试台等待停机信号,在超时周期数内断言 R1 为 12、停机状态有效。例如,可规定 20 个时钟周期内未停机即失败。具体寄存器访问路径、复位时序和停机信号名称应依据实际 RTL 接口确定,不能直接假设所有 CPU 都有相同的信号。
把测试用例固定为回归入口
单次生成成功后,还要确保未来修改汇编器不会无声改变机器码。一个简单方法是保存人工审核过的基准文件 smoke.golden.hex,内容与当前四行 smoke.hex 相同,并将其纳入版本控制。
下面的命令先重新生成机器码,再逐字节比较基准文件,最后运行存储器测试台。适用于 Linux、macOS 或具有所需工具的类 Unix 环境。
python3 assembler.py smoke.asm smoke.hex && \
cmp smoke.hex smoke.golden.hex && \
iverilog -g2012 -s tb_memory -o tb_memory.vvp tb_memory.v && \
vvp tb_memory.vvp
预期输出:
已生成 4 条指令: smoke.hex
PASS: 4 instruction words verified
cmp 比较成功时没有输出;任何一步返回非零退出码,后续步骤就不会执行。应提交 smoke.asm、smoke.golden.hex、assembler.py 和 tb_memory.v,而把 smoke.hex 与 tb_memory.vvp 视为可重新生成的构建产物。
维护更多用例时,可以采用 add-basic.asm、branch-loop.asm 等独立名称,并分别保存对应的基准机器码和执行断言。每次指令编码发生有意变更时,应同时审核 RTL 译码、汇编器以及基准文件,不要单纯覆盖 golden 文件让失败测试变绿。
最容易遗漏的三个检查点是:指令存储器的字宽是否为 16 位、立即数与寄存器字段是否和硬件译码完全一致、回归测试是否真正检查 CPU 执行后的状态。这三项全部通过,汇编程序才真正成为可重复使用的 CPU 测试输入。