
FPGA 与数字 IC 设计 / 系统课时
拆解 CPU 所需的组合与时序模块
拆解 CPU 所需的组合与时序模块
设计一颗最小 CPU,首先要弄清每个模块负责什么、数据从哪里来、结果保存在哪里,以及时钟何时推动状态变化。本篇以一颗 8 位单周期教学 CPU 为例,拆解取指、译码、运算、寄存器与控制模块,并通过可仿真的 RTL 示例验证数据路径和时序边界。
学习目标
- 区分组合逻辑与时序逻辑,识别 CPU 中的主要模块及其输入输出。
- 沿一条指令追踪取指、译码、执行和状态更新的数据路径。
- 使用 SystemVerilog 编写最小执行数据通路,并通过仿真检查寄存器更新时机。
先确定最小 CPU 的设计边界
为了避免一开始就陷入复杂指令集,先定义一颗用于教学的 8 位 CPU。它采用单周期执行模型:一条指令在两个相邻有效时钟沿之间完成组合计算,并在下一个有效沿更新架构状态。
| 设计项目 | 本例规格 |
|---|---|
| 数据宽度 | 8 位,无符号数据 |
| 指令宽度 | 16 位 |
| 程序计数器 PC | 8 位,按指令地址递增 |
| 通用寄存器 | 4 个,每个 8 位 |
| 算术逻辑单元 ALU | 加法、减法、按位与 |
| 指令存储器 | 256 条,每条 16 位 |
| 时钟 | 10 MHz,周期 100 ns |
| 复位 | 高电平有效,同步复位 |
这里的 10 MHz 只是教学仿真的目标频率,不代表该 RTL 在任何 FPGA 或 ASIC 工艺下都能通过时序收敛。实际最高频率必须通过综合和静态时序分析确定。
约定 16 位指令格式:[15:12] 为操作码,[11:10] 为目的寄存器编号,[9:8] 为源寄存器编号,[7:0] 为立即数。示例指令包括 ADD、SUB、AND 和 LDI(加载立即数)。这是自行定义的教学格式,不对应现成商业 CPU 的 ISA。
组合逻辑负责计算,时序逻辑负责记忆
判断一个模块属于哪一类,最简单的方法是问:输入变化后,输出是否可以不等时钟沿就发生变化?
组合逻辑不保存历史状态。加法器根据输入 A、B 计算结果,多路选择器根据选择信号决定输出,译码器根据指令位生成控制信号。实际电路存在传播延迟,但不需要时钟沿触发。
时序逻辑保存状态。本例中的 PC 和通用寄存器在时钟上升沿更新。即使 ALU 的结果在两个上升沿之间多次变化,寄存器也不会因此连续写入。
| 模块 | 类型 | 主要输入 | 主要输出或状态 |
|---|---|---|---|
| 指令存储器 ROM | 组合读取模型 | PC | 16 位指令 |
| 指令译码器 | 组合 | 指令字段 | 操作码、寄存器编号 |
| 控制单元 | 组合 | 操作码 | ALU 操作、写使能、数据选择 |
| 寄存器堆 | 时序写、组合读 | 读地址、写地址、写数据、时钟 | 两路读数据、内部寄存器状态 |
| ALU | 组合 | 两个操作数、操作码 | 8 位计算结果 |
| PC 寄存器 | 时序 | 下一条 PC、时钟 | 当前 PC |
| 下一 PC 逻辑 | 组合 | 当前 PC、跳转条件 | 下一条 PC |
寄存器堆的组合读、同步写只是本例采用的实现方式。实际设计也可能采用同步读 SRAM 或 FPGA Block RAM,此时读取数据的时序需要额外处理。
把取指到写回连接成完整数据路径
CPU 的数据通路可以理解为两条相互配合的链路:数据路径负责搬运和计算指令、操作数与结果;控制路径负责决定使用哪个操作数、执行何种运算、是否写回以及如何更新 PC。
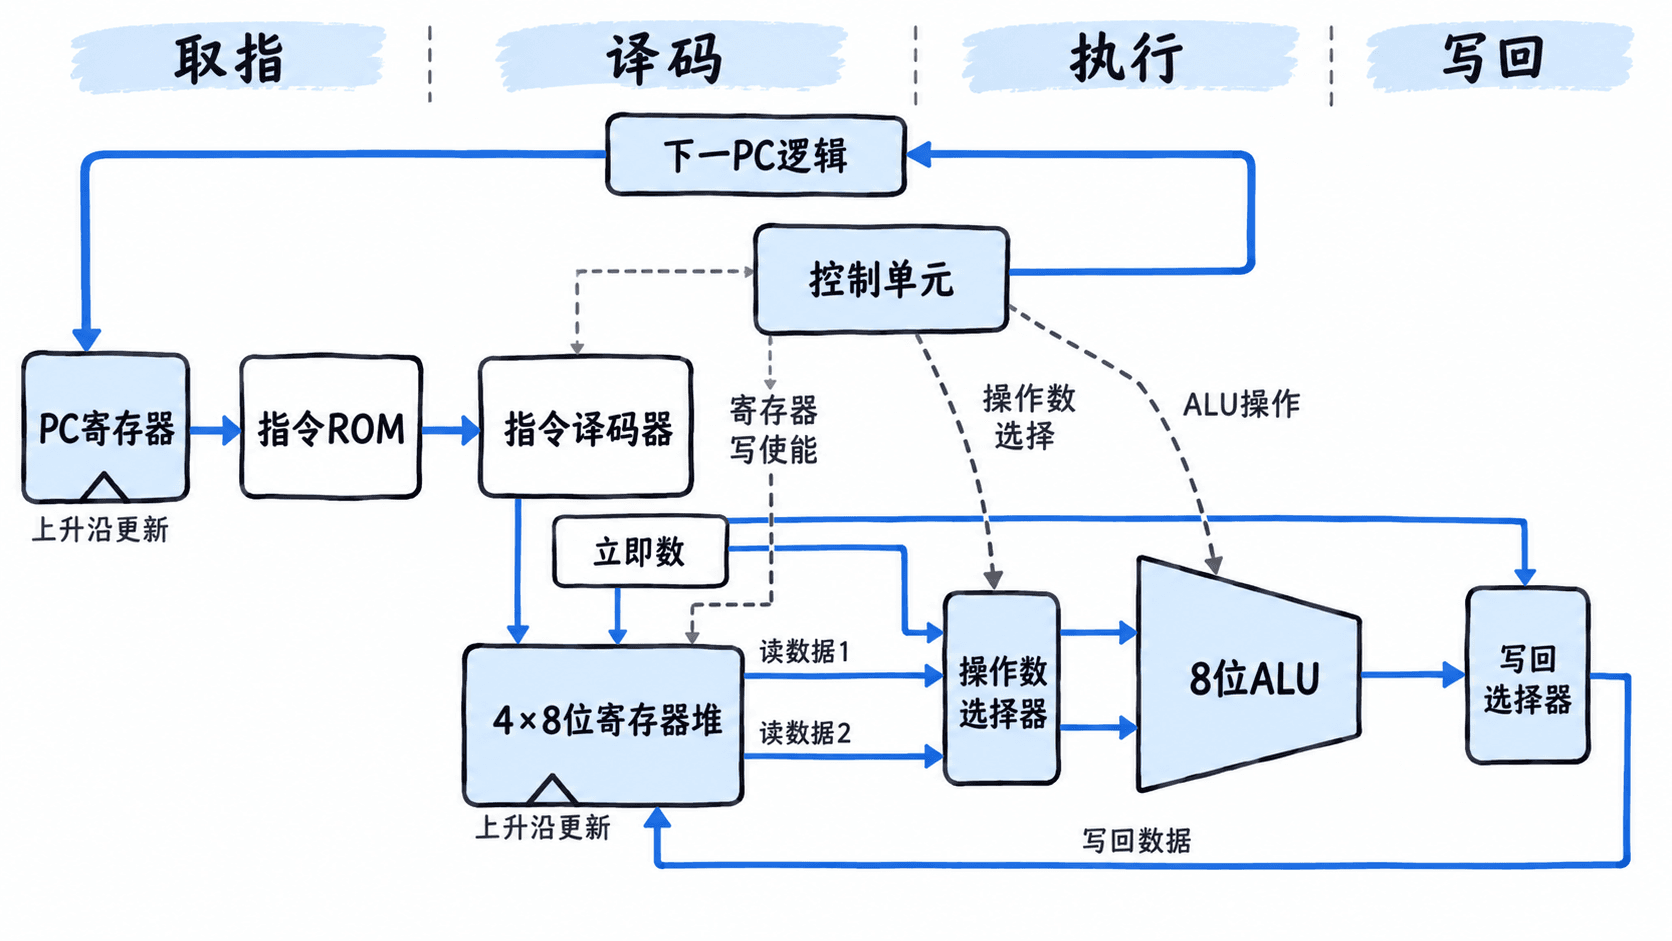
一条普通算术指令按以下顺序经过电路:
- 取指:PC 给出地址,指令 ROM 输出对应的 16 位指令。
- 译码:拆出操作码、源寄存器编号和目的寄存器编号,控制单元生成选择信号。
- 读操作数:寄存器堆输出源操作数;目的寄存器旧值可作为另一个操作数。
- 执行:ALU 按操作码计算加、减或按位与,得到 8 位结果。
- 写回:时钟上升沿到来时,写使能有效则更新目的寄存器,同时 PC 更新为下一条指令地址。
例如,执行 ADD R1, R2,假设原先 R1=5、R2=3。组合路径会计算出 8,随后在有效上升沿把 8 写入 R1。若采用模 256 的 8 位运算,则 250+10 的结果是 4,溢出的第 9 位被截断。
本例没有流水线寄存器,因此不能把取指、译码、执行、写回误认为四个独立时钟周期。它们是同一个周期内的组合传播阶段,只有状态更新由时钟沿触发。
用最小 RTL 验证组合与时序边界
下面使用 SystemVerilog 编写独立的最小执行单元,验证 ALU 输出是组合结果,而寄存器必须在时钟上升沿才更新。它不是完整 CPU:指令由测试平台提供,尚未加入 PC、ROM 和完整指令译码。
保存为 mini_execute.sv,包含被测模块与测试平台;示例适用于支持 -g2012 的 Icarus Verilog。
module mini_execute (
    input  logic       clk,
    input  logic       rst,
    input  logic       write_en,
    input  logic [1:0] op,
    input  logic [7:0] operand,
    output logic [7:0] acc,
    output logic [7:0] alu_result
);
    // ALU 为组合逻辑,输入变化即可重新计算。
    always_comb begin
        case (op)
            2'b00: alu_result = acc + operand;
            2'b01: alu_result = acc - operand;
            2'b10: alu_result = acc & operand;
            default: alu_result = acc;
        endcase
    end

    // acc 保存架构状态,只在时钟上升沿更新。
    always_ff @(posedge clk) begin
        if (rst)
            acc <= 8'd0;
        else if (write_en)
            acc <= alu_result;
    end
endmodule

module tb;
    logic clk = 0;
    logic rst = 1;
    logic write_en = 0;
    logic [1:0] op = 0;
    logic [7:0] operand = 0;
    logic [7:0] acc;
    logic [7:0] alu_result;

    mini_execute dut (.*);
    always #5 clk = ~clk;

    initial begin
        #6;
        rst = 0;
        operand = 8'd5;
        write_en = 1;
        #1;
        $display("before edge: acc=%0d alu=%0d", acc, alu_result);
        #4;
        #1;
        $display("after edge:  acc=%0d", acc);
        operand = 8'd3;
        #10;
        #1;
        $display("second edge: acc=%0d", acc);
        $finish;
    end
endmodule
安装 Icarus Verilog 后,在保存文件的目录执行:
iverilog -g2012 -s tb -o mini_execute.vvp mini_execute.sv
vvp mini_execute.vvp
预期输出:
before edge: acc=0 alu=5
after edge:  acc=5
second edge: acc=8
测试平台每 5 ns 翻转一次时钟,因此完整时钟周期为 10 ns。第一个上升沿发生在 5 ns,用于同步复位;随后在 15 ns 写入 5,在 25 ns 写入 8。命令无须传入 CPU 实际运行频率,因为这里仿真的是功能时序;测试平台采用的时间单位由工具对未声明 timescale 的处理决定,不应把 #5 直接视作固定的物理 5 ns。
观察第一行:acc 仍为 0,但 alu_result 已经是 5,说明组合计算不等待写回。第二、三行说明状态分别在后续上升沿变为 5 和 8。使用非阻塞赋值 <= 描述寄存器更新,可避免将多个时序寄存器错误地写成按代码顺序即时传递。
把执行单元扩展为 CPU 时需要补什么
执行单元跑通后,再按模块边界扩展,而不是一次加入完整流水线、缓存和中断控制器。
| 扩展顺序 | 新增内容 | 最小验证条件 |
|---|---|---|
| 1 | 8 位 PC 与递增逻辑 | 连续两个周期 PC 增加 1 |
| 2 | 256×16 指令 ROM | PC=0 能读到预设第一条指令 |
| 3 | 操作码译码与控制信号 | LDI 选择立即数,ADD 选择 ALU 结果 |
| 4 | 4×8 位寄存器堆 | 只有写使能有效时指定寄存器更新 |
| 5 | 取指、执行、写回联调 | 连续执行 LDI、ADD 得到指定数值 |
一个可检查的验收程序是先执行 LDI R0, 5,再执行 LDI R1, 3,最后执行 ADD R0, R1。预期第三条指令写回后,R0=8、R1=3、PC=3。这里约定 PC 初始为 0,每次指令执行成功后递增 1,不考虑跳转与停机指令。
还需要检查一个常见隐患:若组合路径写成反馈环,例如 ALU 输出未经寄存器隔离又影响自己的输入,就可能导致仿真无法收敛或综合出不符合预期的电路。正确的反馈应跨越寄存器状态边界,例如 acc 经 ALU 计算后,在时钟上升沿重新写入 acc。
对于单周期 CPU,时钟周期必须覆盖寄存器时钟到输出延迟、ROM 读取、译码、操作数选择、ALU 运算、写回选择及目标寄存器建立时间,并考虑时钟偏斜等约束。功能仿真通过只能说明逻辑行为符合预期,不能证明硬件满足目标频率。
完成上述验收后,就能明确区分 CPU 中负责即时计算的组合模块与负责保存架构状态的时序模块,也有了后续增加跳转、访存和时序约束的可靠起点。