
FPGA 与数字 IC 设计 / 系统课时
综合 RTL 检查资源与最长路径
综合 RTL 检查资源与最长路径
CPU 的 RTL 仿真通过,并不代表硬件实现足够经济或运行速度足够快。本课使用 Yosys 综合一个包含寄存器、加法器和结果选择逻辑的简化数据通路,读取逻辑单元数量与最长组合路径,判断资源消耗和时序瓶颈,并验证优化是否真正有效。
学习目标
- 使用 Yosys 综合 Verilog RTL,读取触发器与组合逻辑资源统计。
- 通过静态时序分析识别最长组合路径及其延迟来源。
- 区分资源统计、逻辑深度和实际芯片时序,并建立可重复的优化对比方法。
准备可综合的 CPU 数据通路
本课使用 Yosys 的通用逻辑单元进行演示,适合学习 RTL 到门级逻辑的变化。示例命令以支持 synth、stat、ltp 和 write_json 的 Yosys 0.40 及后续兼容版本为参考;具体资源数量和路径长度以本机综合结果为准。
先检查工具是否安装:
yosys -V预期输出:
Yosys <VERSION> (...)其中 <VERSION> 为实际安装版本,版本信息后面的构建标识可能不同。
创建 cpu_datapath.v,设计两个 8 位操作数寄存器、一个加法器,以及一个在加法和按位异或之间切换的结果寄存器。该结构足够小,可以观察综合报告,又保留了真实 CPU 数据通路的典型特征。
module cpu_datapath (
    input wire clk,
    input wire rst,
    input wire [7:0] a_in,
    input wire [7:0] b_in,
    input wire op,
    output reg [7:0] result
);
    reg [7:0] a_reg;
    reg [7:0] b_reg;

    // 操作数先进入寄存器,形成明确的组合路径起点
    always @(posedge clk) begin
        if (rst) begin
            a_reg <= 8'd0;
            b_reg <= 8'd0;
            result <= 8'd0;
        end else begin
            a_reg <= a_in;
            b_reg <= b_in;
            // 加法与异或共用输出选择逻辑
            result <= op ? (a_reg ^ b_reg) : (a_reg + b_reg);
        end
    end
endmodule
这里的 op=0 表示加法,op=1 表示按位异或。result 使用非阻塞赋值,因此当前时钟沿保存的是上一周期寄存的 a_reg、b_reg 所计算出的结果,而不是刚输入的 a_in、b_in。
设计共有 24 位需要保存状态的寄存器:两个 8 位操作数和一个 8 位结果。寄存器之外,还有加法、异或和结果选择逻辑。
执行综合并读取资源统计
在包含 cpu_datapath.v 的目录中执行:
yosys -p 'read_verilog cpu_datapath.v; hierarchy -check -top cpu_datapath; synth -top cpu_datapath; stat; write_json cpu_netlist.json' > synth.log预期结果:命令成功退出,生成 synth.log 和 cpu_netlist.json。synth.log 中应包含顶层模块 cpu_datapath 的资源统计,且能找到 Number of cells 一类统计项。未使用目标工艺库时,Yosys 默认综合结果不是 ASIC 标准单元的真实面积报告。
可以用以下命令定位统计内容:
grep -A 25 '=== cpu_datapath ===' synth.log | tail -n 25预期结果:显示与顶层模块有关的部分报告。由于日志中可能多次出现模块统计,不同 Yosys 版本下这条命令显示的具体段落可能不同;应以最后一次综合完成后的 stat 段落为准。
读取统计时,重点区分以下指标:
| 指标 | 含义 | 判断方法 |
|---|---|---|
| Number of cells | 综合后的逻辑单元总数 | 同一综合流程下比较变化 |
$_DFF_P_ 或复位型 DFF |
触发器类别 | 结合位宽检查状态是否保留 |
$_AND_、$_XOR_ 等 |
映射后的基本逻辑门 | 观察组合逻辑的构成 |
$_MUX_ |
选择逻辑单元 | 检查条件选择是否增加逻辑开销 |
示例中明确需要保存 24 位寄存器状态,但实际触发器类型可能因同步复位及工艺映射发生变化。不要直接用 Number of cells 作为芯片面积,更不能把不同综合目标下的门数直接进行公平比较。
找出最长组合路径
CPU 时钟频率受寄存器之间的组合逻辑延迟限制。对于本例,关键候选路径是操作数寄存器输出经过加法器与结果选择逻辑,最终到达 result 寄存器输入。
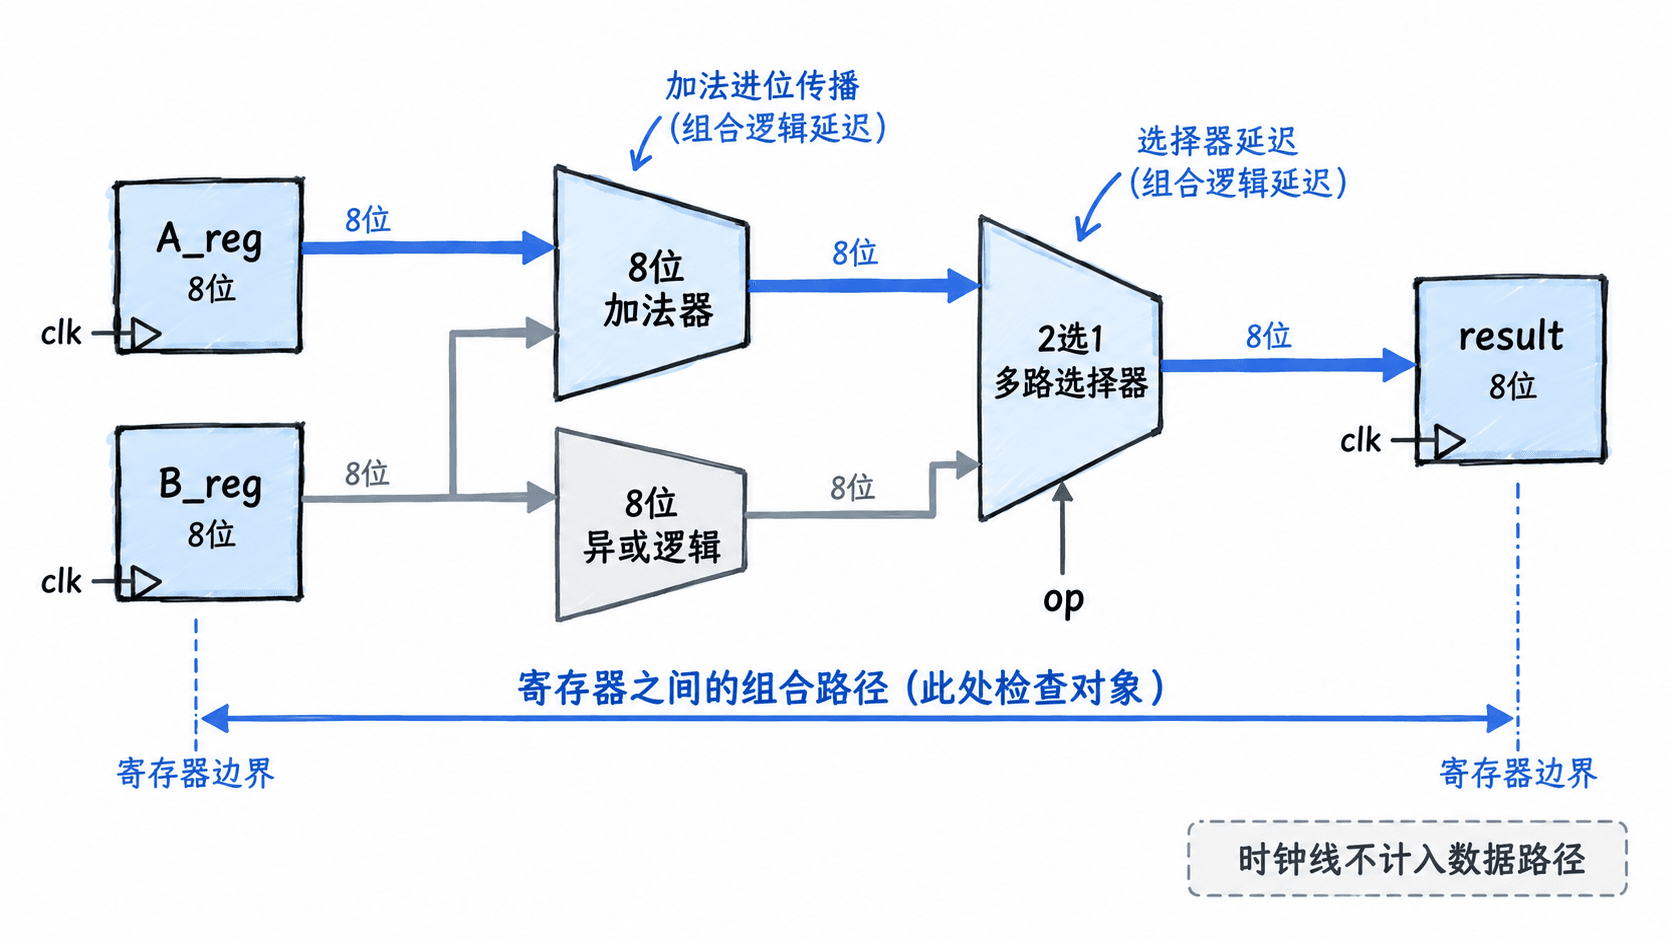
Yosys 提供 ltp 命令分析逻辑层级意义上的最长拓扑路径。执行:
yosys -p 'read_verilog cpu_datapath.v; synth -top cpu_datapath; ltp -noff' > path.log预期结果:path.log 中包含最长拓扑路径分析信息,可搜索:
grep -E 'longest topological path|length=' path.log预期输出格式示意,具体数值取决于 Yosys 版本和映射结果:
length=<N>这里的 <N> 表示路径级数,实际日志还可能包含其他路径说明。-noff 用于让触发器不作为组合路径的贯通节点,避免跨多个时钟周期错误串接路径。
需要注意,ltp 报告的是拓扑层级,不是纳秒延迟。同样经过 5 级逻辑门的两条路径,可能由于门类型、负载、扇出和工艺不同,产生完全不同的实际延迟。
从逻辑深度转换为真实时序判断
对于采用单一时钟的寄存器到寄存器路径,基本建立时间约束为:
这里将时钟偏斜定义为使建立时间要求变严的有效偏斜量;若采用其他偏斜符号约定,公式的符号需要相应调整。
假设目标标准单元和布线条件下测得:
| 延迟组成 | 数值 |
|---|---|
| 寄存器时钟到输出 | 0.12 ns |
| 组合逻辑 | 1.65 ns |
| 建立时间 | 0.10 ns |
| 不利时钟偏斜 | 0.08 ns |
| 合计最小时钟周期 | 1.95 ns |
对应理想情况下的最高时钟频率约为 。以上数据是用于说明计算方法的假设值,并非本例 Yosys 命令测得的真实芯片延迟。
如果设计要求 500 MHz,时钟周期为 2.00 ns,按上述假设数据计算仅剩 0.05 ns 建立时间余量。如果目标变成 600 MHz,周期约为 1.667 ns,则建立时间余量约为 -0.283 ns,表示路径不满足目标约束。
获取真实时序,需要先选择工艺库并完成技术映射,再使用支持 Liberty、SDC 和寄生参数的静态时序分析工具(例如 OpenSTA)进行分析。报告至少应检查 Startpoint、Endpoint、Arrival Time、Required Time 与 Slack。
对比优化前后的资源与路径
假设综合报告显示加法器所在路径层级较深,不能立即判断是加法器、选择器还是高扇出造成瓶颈。推荐采用一次只改变一个因素的实验方法。
例如将原来的加法分支替换为分段或不同结构的加法器,保持端口、寄存器边界、复位方式和输入位宽完全不变。新版本保存为 cpu_datapath_opt.v,顶层模块名仍保持 cpu_datapath,之后使用相同 Yosys 命令和相同工具版本重新综合。
yosys -p 'read_verilog cpu_datapath_opt.v; hierarchy -check -top cpu_datapath; synth -top cpu_datapath; stat; ltp -noff' > opt.log预期结果:opt.log 包含优化版本的单元统计与最长拓扑路径信息,可以同原版本 synth.log、path.log 进行对照。具体资源和路径差异由实际优化代码决定。
记录一张对比表,下面的数字仅是演示如何判断的假设数据:
| 指标 | 原版本 | 优化版本 |
|---|---|---|
| 逻辑单元数 | 110 | 124 |
| 最长组合路径层级 | 15 | 11 |
| 状态寄存器位数 | 24 | 24 |
| 单元数变化 | 基准 | +12.7% |
| 逻辑层级变化 | 基准 | -26.7% |
该结果意味着以约 12.7% 的逻辑单元数量增长换取约 26.7% 的路径层级下降,但不能据此认定实际时延也下降 26.7%。最终应在同一个目标技术库和约束条件下比较时序余量与面积。
还有两个容易造成错误结论的问题:
- 修改 RTL 后删除了不再使用的结果位,单元数减少可能只是功能被裁剪,必须先运行等价验证或回归测试。
- 在优化版中插入额外流水线寄存器虽然能缩短单周期组合路径,但会改变结果延迟,必须调整接口时序与测试基准,不能直接当作功能完全等价。
实际 CPU 项目建议把综合资源表、最长路径报告、工具版本和综合脚本一起归档。只比较同一目标工艺、相同综合约束及相同功能条件下的结果;确认功能回归通过后,再根据面积、时序余量和功耗目标决定是否保留优化。