
FPGA 与数字 IC 设计 / 系统课时
用 CPI 量化流水线停顿开销
用 CPI 量化流水线停顿开销
五级流水线能够让多条指令重叠执行,但数据相关、分支跳转和存储器等待都会增加执行周期。只观察仿真波形很难判断性能是否真的提升。本课使用提交指令数、总周期和停顿计数器计算 CPI,并与单周期 CPU 比较,定位最值得优化的流水线瓶颈。
学习目标
- 正确区分提交指令数、总周期、CPI 和 IPC,计算实际流水线吞吐率。
- 为数据冒险、控制冒险和结构冒险设计互斥的周期统计口径。
- 使用可运行的 Python 脚本核对 CPI,比较单周期与五级流水线的性能。
从理想 CPI 到实际 CPI
CPI(Cycles Per Instruction)表示平均每提交一条指令需要多少个时钟周期。最直接的计算方式是:
其中, 为测量区间内的有效时钟周期数, 为该区间内成功提交的架构指令数。对顺序五级流水 CPU,可以在 WB 阶段依据有效位及提交条件产生 retire_valid,每次有效提交计数一次。
典型五级流水包括 IF 取指、ID 译码、EX 执行、MEM 访存和 WB 写回。理想情况下,流水线填满后每周期最多提交一条指令,因此稳态 CPI 接近 1,而不是 5。单周期 CPU 每周期完成一条指令,其 CPI 同样为 1,但二者时钟周期长度往往不同。
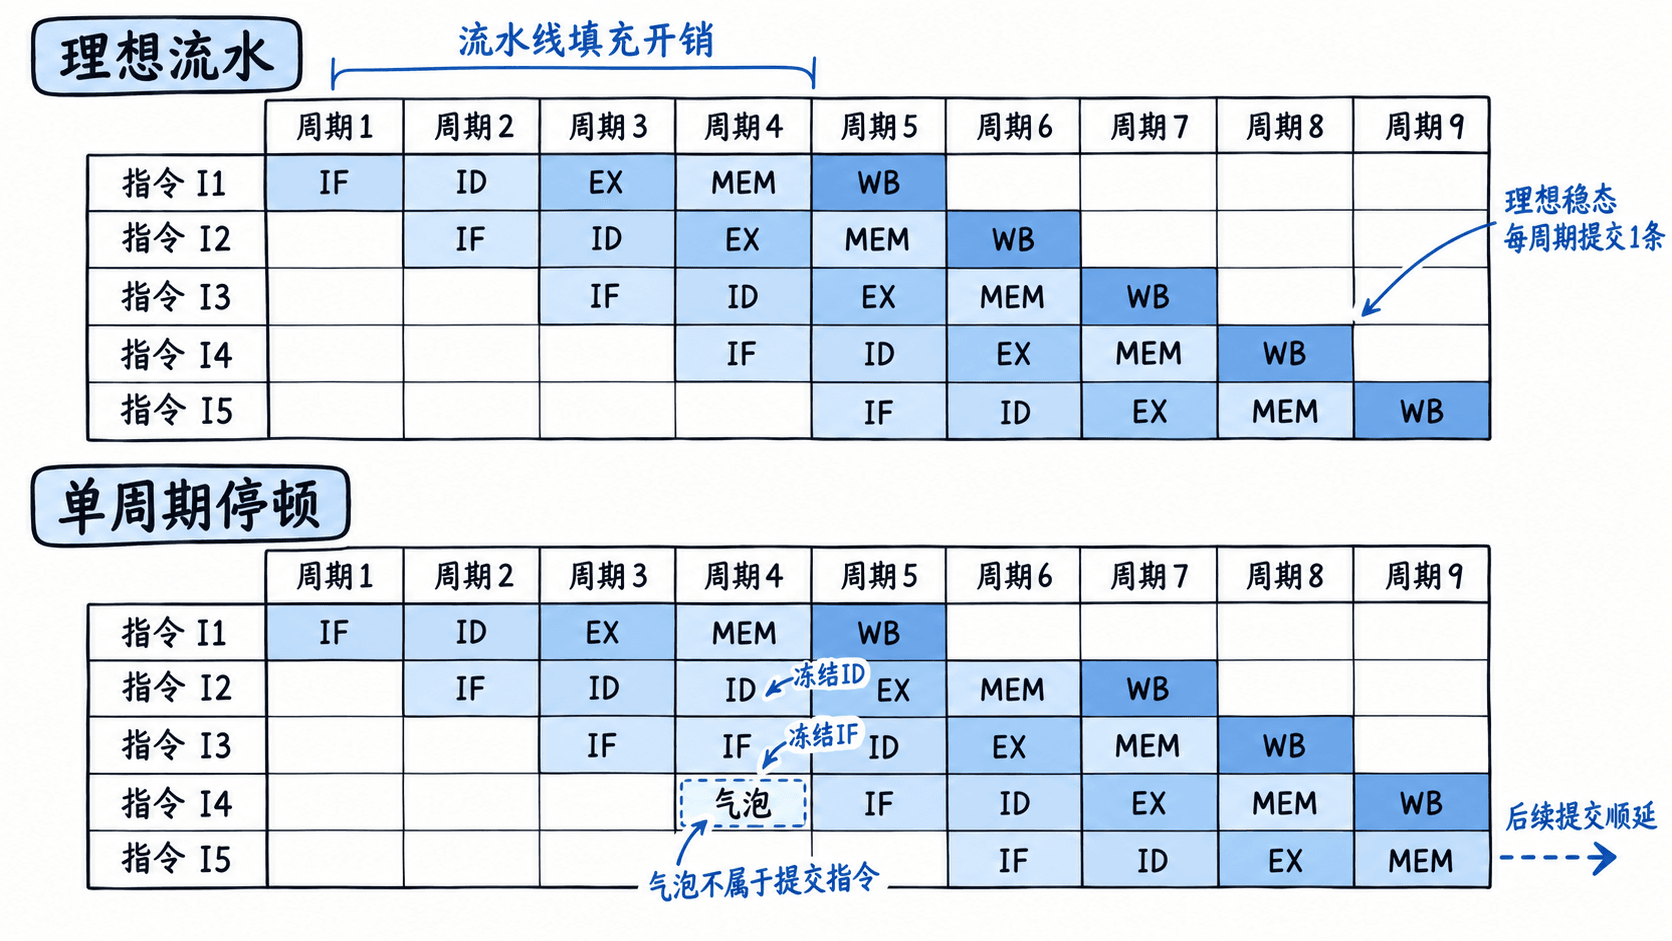
如果从空流水线开始执行 条指令,并且最后等待全部指令离开流水线,在没有停顿的理想五级流水中:
例如执行 100 条指令,需要 104 个周期,CPI 为 1.04。多出的 4 个周期是流水线填充和排空所对应的固定开销,不应误判为数据冒险。
统计提交指令与停顿周期
为了定位 CPI 损失,需要同时记录提交数量和导致吞吐率下降的周期。建议在 CPU 顶层性能监控模块设置以下计数器,所有计数器在复位或测量开始时清零。
| 计数器 | 计数条件 | 用途 |
|---|---|---|
cycle_count |
测量窗口内每个有效时钟上升沿 | 计算总周期 |
instret_count |
指令在统一提交点成功退休 | 计算 CPI 分母 |
load_stall_count |
Load-Use 相关导致流水冻结 | 数据冒险归因 |
branch_penalty_count |
分支重定向造成的实际空泡周期 | 控制冒险归因 |
mem_stall_count |
存储器等待阻止流水推进 | 访存等待归因 |
instret_count 不能简单统计 IF 取指次数。分支预测错误或跳转冲刷的指令可能已进入 IF、ID,却不会最终提交。重复取指也不代表重复退休。
对于带异常处理的 CPU,应先定义退休语义:通常只有真正提交架构状态的指令才计入;被冲刷、被取消的指令不计入。Store 等不写通用寄存器的指令也需要通过统一提交事件计数,不能只依据寄存器写使能。
避免重复归因
同一周期可能同时存在分支重定向、缓存等待和数据相关。如果三个停顿计数器各自累加,累计数就可能超过实际额外周期。
一种便于教学验证的做法是按优先级为每个损失周期分配唯一主因:
- 存储器等待已经阻塞流水时,计入
mem_stall_count。 - 否则,如果控制流冲刷直接造成提交空泡,计入
branch_penalty_count。 - 否则,如果 Load-Use 冒险导致空泡,计入
load_stall_count。 - 其余不归属于上述原因的额外周期进入
other_penalty_count。
上述分类是性能归因口径,不是硬件必须遵循的仲裁优先级。必须使用真实的有效位、提交事件和阻塞信号识别损失,不能把所有 stall 信号为高的周期都直接当作新增 CPI 周期。尤其是流水线排空、多个冒险重叠时,简单累加原始信号次数通常不成立。
用周期账本计算 CPI
假设从空流水线开始执行 1000 条有效指令,处理器为单发射、顺序提交、五级流水结构。实验统计如下:
| 来源 | 周期数 |
|---|---|
| 有效提交指令对应的理想周期 | 1000 |
| 流水线填充与排空固定开销 | 4 |
| Load-Use 相关损失 | 80 |
| 分支控制损失 | 120 |
| 存储器等待损失 | 60 |
| 其他未归因损失 | 0 |
| 总周期 | 1264 |
这里假设每个损失周期已经互斥归因,没有重叠计数,且测量区间覆盖全部指令的执行及流水线排空。
因此:
相对于理想稳态 CPI 为 1,额外开销为 0.264 周期/指令。其中分支损失贡献 0.120,Load-Use 贡献 0.080,存储器等待贡献 0.060,固定开销贡献 0.004。
IPC(Instructions Per Cycle)表示平均每周期提交多少条指令:
对同一个测量窗口,。因此 CPI 越小、IPC 越大,意味着每个周期的指令吞吐率越高。但 IPC 不包含时钟频率,不能单独代表每秒性能。
编写脚本复核统计结果
下面使用 Python 3 标准库编写一个完整的统计程序。脚本不依赖额外安装的第三方包,适合先验证仿真导出的聚合计数,再替换为真实硬件统计结果。
from dataclasses import dataclass


@dataclass
class CpuStats:
    retired: int
    cycles: int
    fill_drain: int
    load_stall: int
    branch_penalty: int
    mem_stall: int


def analyze(stats: CpuStats) -> None:
    # 仅适用于单发射、顺序提交、从空流水线开始的完整测量窗口
    if stats.retired <= 0 or stats.cycles <= 0:
        raise ValueError("retired 和 cycles 必须大于零")

    overhead = (stats.fill_drain + stats.load_stall
                + stats.branch_penalty + stats.mem_stall)
    # 检查互斥归因后的周期账本是否闭合
    if stats.cycles != stats.retired + overhead:
        raise ValueError("周期账本不一致,请检查重叠计数或遗漏来源")

    cpi = stats.cycles / stats.retired
    ipc = stats.retired / stats.cycles
    print(f"CPI={cpi:.3f}")
    print(f"IPC={ipc:.4f}")
    for name, cycles in [
        ("Load-Use", stats.load_stall),
        ("Branch", stats.branch_penalty),
        ("Memory", stats.mem_stall),
    ]:
        print(f"{name}: {cycles / stats.retired:.3f} CPI")


if __name__ == "__main__":
    analyze(CpuStats(1000, 1264, 4, 80, 120, 60))
预期输出:
CPI=1.264
IPC=0.7911
Load-Use: 0.080 CPI
Branch: 0.120 CPI
Memory: 0.060 CPI
该脚本采用严格的周期账本模型,适用于本算例,不适合直接套用到超标量、乱序执行或复杂重叠等待的处理器。如果实际计数器记录的是原始事件次数而不是互斥的损失周期,应先在波形和提交轨迹中完成归因,再执行账本检查。
比较单周期与流水线的真实执行时间
单周期和流水线的 CPI 不能直接比较出速度优势,因为每个周期对应的时间不同。执行时间应按以下公式计算:
假设相同程序在两个 CPU 上均提交 1000 条指令,单周期时钟周期为 10 ns,流水线时钟周期为 2.5 ns:
| 指标 | 单周期 CPU | 五级流水 CPU |
|---|---|---|
| 提交指令数 | 1000 | 1000 |
| 总周期数 | 1000 | 1264 |
| CPI | 1.000 | 1.264 |
| 时钟周期 | 10 ns | 2.5 ns |
| 总执行时间 | 10000 ns | 3160 ns |
流水线方案的加速比为:
虽然流水线 CPI 更高,但较短的时钟周期使它在本实验中约快 3.16 倍。不能简单断言五级流水必然提升 5 倍:流水寄存器延迟、关键路径、前递逻辑和停顿都会影响最终结果。
这里的 10 ns 与 2.5 ns 是用于计算的假设值。真实工程需要使用综合与静态时序分析获得可实现的时钟周期,并在相同指令集、相同程序、相同输入和一致的存储器延迟模型下比较。
根据 CPI 损失选择优化方向
本算例中,分支损失为 120 周期,是三类停顿中的最大来源。若把分支损失降到 60 周期,其他条件不变,总周期变成 1204,CPI 降为 1.204,原流水方案执行时间由 3160 ns 降为 3010 ns。
可以据此建立有数字依据的优化顺序:
- 先检查分支决策发生在 EX 还是更早的阶段,以及错误路径冲刷了多少有效指令。
- 再检查 Load-Use 相关是否每次固定停顿一周期,是否已经通过 EX/MEM 或 MEM/WB 前递消除了不必要的等待。
- 最后检查存储器响应延迟及结构冲突,区分真实请求等待和测试平台人为插入的空周期。
实际验收时,用同一段确定性程序分别记录 cycle_count、instret_count、各类损失周期及最终寄存器和内存状态。先确认两种 CPU 计算结果一致,再核对计数器与提交轨迹;若 CPI 异常,优先检查提交重复计数、冲刷指令误计和统计窗口边界,而不是立即修改流水线控制逻辑。
最终性能报告至少保留指令数、总周期、CPI、时钟周期、执行时间和主要损失来源六项数据,才能把一次流水线优化从波形上的直观改善转化为可复现的量化结论。