
FPGA 与数字 IC 设计 / 系统课时
按一个时钟周期核对指令结果
按一个时钟周期核对指令结果
单周期 CPU 最容易出现的错误,是仿真波形看起来正常,实际却写错寄存器、跳错地址或修改了不该修改的存储器。本篇使用一组可复现的指令和 SystemVerilog 检查代码,在每个有效时钟沿后核对 PC、寄存器和数据存储器,并根据首次出现的差异定位连接或译码错误。
学习目标
- 区分时钟沿前的组合逻辑结果与时钟沿后的架构状态。
- 为算术、访存和分支指令建立逐周期预期状态表。
- 编写自动检查程序,并从失败位置反查控制信号和数据通路。
明确单周期 CPU 的检查边界
采用一个教学用 RV32I 单周期 CPU 作为示例:32 位 PC、32 个通用寄存器、独立指令存储器和数据存储器,不考虑流水线、缓存和等待周期。每条支持的指令在一个上升沿完成状态提交,复位时 PC 为 0,寄存器 x0 恒为 0。
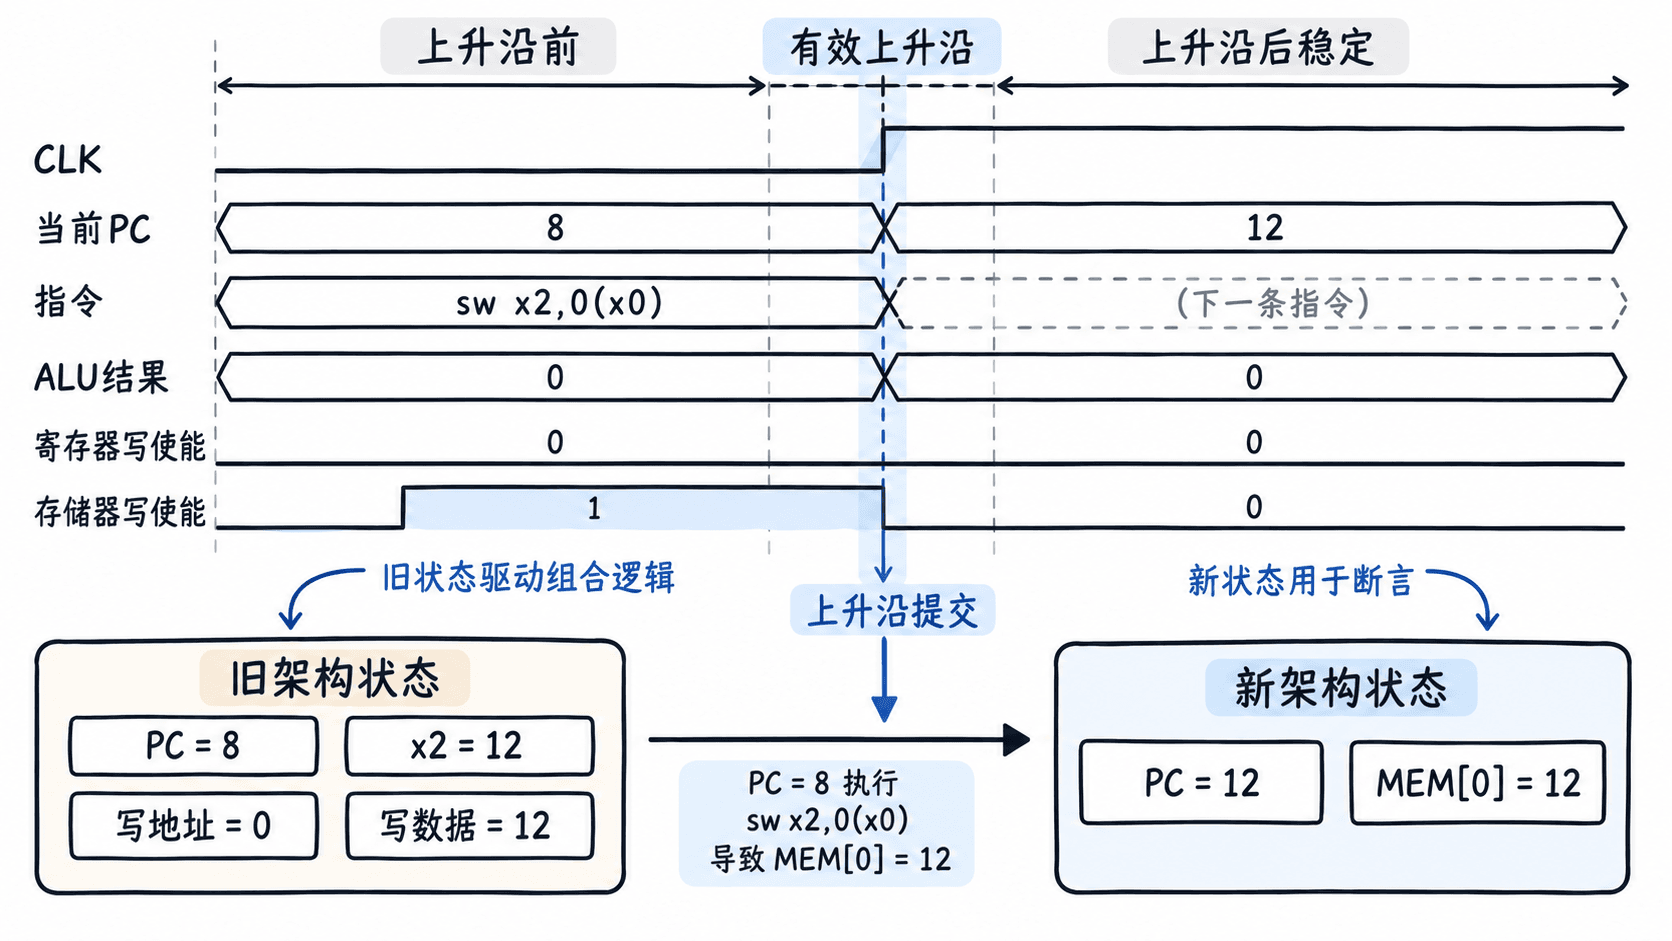
一个时钟周期的检查应分为两个观察点:
- 上升沿前:当前 PC 指向待执行指令;组合逻辑产生寄存器读数、立即数、ALU 结果、分支判断和写使能。
- 上升沿到来:PC 寄存器、寄存器堆和同步写数据存储器根据旧状态及组合逻辑结果更新。
- 上升沿后:等待非阻塞赋值和组合逻辑稳定,再比较新 PC、目标寄存器及存储器内容。
例如 PC=8 的 sw x2, 0(x0) 应在上升沿将旧 x2 的值写入数据存储器地址 0,同时 PC 更新为 12。不能用更新后的 PC=12 再去判断本周期执行的指令。
准备一段具有明确预期的指令序列
使用以下 RV32I 指令,所有地址均按字节编址,数据存储器允许对齐的 32 位字访问,分支偏移相对于当前指令 PC 计算。
| 执行周期 | 当前 PC | 指令 | 上升沿后 PC | 状态变化 |
|---|---|---|---|---|
| 1 | 0 | addi x1,x0,5 |
4 | x1=5 |
| 2 | 4 | addi x2,x1,7 |
8 | x2=12 |
| 3 | 8 | sw x2,0(x0) |
12 | MEM[0]=12 |
| 4 | 12 | lw x3,0(x0) |
16 | x3=12 |
| 5 | 16 | beq x3,x2,8 |
24 | 分支成立,跳过 PC=20 |
| 6 | 24 | add x4,x1,x3 |
28 | x4=17 |
PC=20 放置 addi x4,x0,99,专门用于检测分支失败或错误的顺序执行。测试前将 x1~x4 与 MEM[0] 初始化为 0,确保每次运行结果一致。
对应的 32 位机器码如下,可按地址顺序加载到指令存储器:
// 指令存储器初始化片段:依赖已声明的 logic [31:0] imem [0:63]
initial begin
    imem[0] = 32'h00500093; // addi x1,x0,5
    imem[1] = 32'h00708113; // addi x2,x1,7
    imem[2] = 32'h00202023; // sw x2,0(x0)
    imem[3] = 32'h00002183; // lw x3,0(x0)
    imem[4] = 32'h00218463; // beq x3,x2,8
    imem[5] = 32'h06300213; // addi x4,x0,99
    imem[6] = 32'h00308233; // add x4,x1,x3
end
这是片段示例,依赖 CPU 的指令存储器采用 imem[PC[31:2]] 一类的字索引读取方式,且测试地址位于有效存储范围内。若指令存储器使用字节数组,加载方式需要调整,但每条指令的机器码不变。
检查时必须保留 PC=20 的陷阱指令。若分支译码或下一 PC 选择器接错,x4 可能被暂时写为 99,立即暴露错误,而不是在最终算术结果中被覆盖后难以发现。
编写逐周期自动核对程序
下面提供可运行的独立 SystemVerilog 参考模型。它不是完整 RTL CPU,而是用于验证测试顺序、时钟采样和预期状态的最小检查程序。真实 CPU 联调时,将模型中的状态读取替换为 DUT 的 PC、寄存器堆和数据存储器观察信号,并保持同一组预期值。
将代码保存为 cycle_check.sv,使用支持 SystemVerilog 的 Icarus Verilog 11.0 或兼容版本执行。
module cycle_check;
    logic clk = 0;
    logic [31:0] pc = 0;
    logic [31:0] regs [0:31];
    logic [31:0] mem0 = 0;
    integer cycle = 0;

    always #5 clk = ~clk;

    // 用固定指令行为模拟状态提交,形成可核对的参考轨迹。
    always @(posedge clk) begin
        case (pc)
            0:  begin regs[1] <= 5;  pc <= 4;  end
            4:  begin regs[2] <= regs[1] + 7; pc <= 8; end
            8:  begin mem0 <= regs[2]; pc <= 12; end
            12: begin regs[3] <= mem0; pc <= 16; end
            16: begin pc <= (regs[3] == regs[2]) ? 24 : 20; end
            20: begin regs[4] <= 99; pc <= 24; end
            24: begin regs[4] <= regs[1] + regs[3]; pc <= 28; end
            default: pc <= pc;
        endcase
    end

    task automatic check_state(
        input logic [31:0] expected_pc,
        input logic [31:0] expected_x1,
        input logic [31:0] expected_x2,
        input logic [31:0] expected_x3,
        input logic [31:0] expected_x4,
        input logic [31:0] expected_mem0
    );
        begin
            @(posedge clk);
            #1; // 等待非阻塞赋值完成,再观察状态。
            cycle = cycle + 1;
            if (pc !== expected_pc || regs[1] !== expected_x1 ||
                regs[2] !== expected_x2 || regs[3] !== expected_x3 ||
                regs[4] !== expected_x4 || mem0 !== expected_mem0)
                $fatal(1, "FAIL cycle=%0d pc=%0d x1=%0d x2=%0d x3=%0d x4=%0d mem0=%0d",
                    cycle, pc, regs[1], regs[2], regs[3], regs[4], mem0);
            $display("PASS cycle=%0d pc=%0d", cycle, pc);
        end
    endtask

    initial begin
        for (integer i = 0; i < 32; i = i + 1)
            regs[i] = 0;
        check_state(4,  5, 0,  0,  0,  0);
        check_state(8,  5, 12, 0,  0,  0);
        check_state(12, 5, 12, 0,  0, 12);
        check_state(16, 5, 12, 12, 0, 12);
        check_state(24, 5, 12, 12, 0, 12);
        check_state(28, 5, 12, 12, 17, 12);
        $display("ALL CHECKS PASSED");
        $finish;
    end
endmodule
运行命令:
iverilog -g2012 -s cycle_check -o cycle_check.vvp cycle_check.sv
vvp cycle_check.vvp
预期输出:
PASS cycle=1 pc=4
PASS cycle=2 pc=8
PASS cycle=3 pc=12
PASS cycle=4 pc=16
PASS cycle=5 pc=24
PASS cycle=6 pc=28
ALL CHECKS PASSED
该模型中 #1 仅用于仿真采样,不能综合成硬件延迟。测试在 10 个仿真时间单位的周期内、上升沿后 1 个单位检查,因此不会采到下一次上升沿。真实 DUT 还应在复位释放后开始计数,并显式检查 x0 始终为 0。
根据第一次失败的周期定位错误
不要直接从最后的寄存器值倒推故障。先找到第一次 FAIL,再检查执行该指令时的旧 PC、机器码、控制信号和操作数。
| 首次失败 | 典型现象 | 优先检查 |
|---|---|---|
| 周期 1 | x1 不为 5 | I 型立即数扩展、RegWrite、写回选择 |
| 周期 2 | x2 不为 12 | rs1 地址、寄存器读端口、ALU 加法 |
| 周期 3 | MEM[0] 不为 12 | MemWrite、rs2 数据、存储器地址 |
| 周期 4 | x3 不为 12 | MemRead、load 写回选择、RegWrite |
| 周期 5 | PC 不为 24 | beq 比较、B 型立即数、PC 多路选择器 |
| 周期 6 | x4 不为 17 | R 型译码、ALU 输入、rd 写回地址 |
以周期 5 为例:若实际 PC=20,而 x2=x3=12,说明寄存器数据已经正确,问题更可能位于比较结果、Branch 控制或下一 PC 选择器,而不是 load 数据通路。
进一步在执行 beq 的上升沿前核对以下信号:
rs1_data=12,rs2_data=12。- ALU 比较相等,分支成立条件为真。
- B 型立即数为 8,分支目标为 16+8=24。
RegWrite=0、MemWrite=0,本指令不得修改通用寄存器或数据存储器。
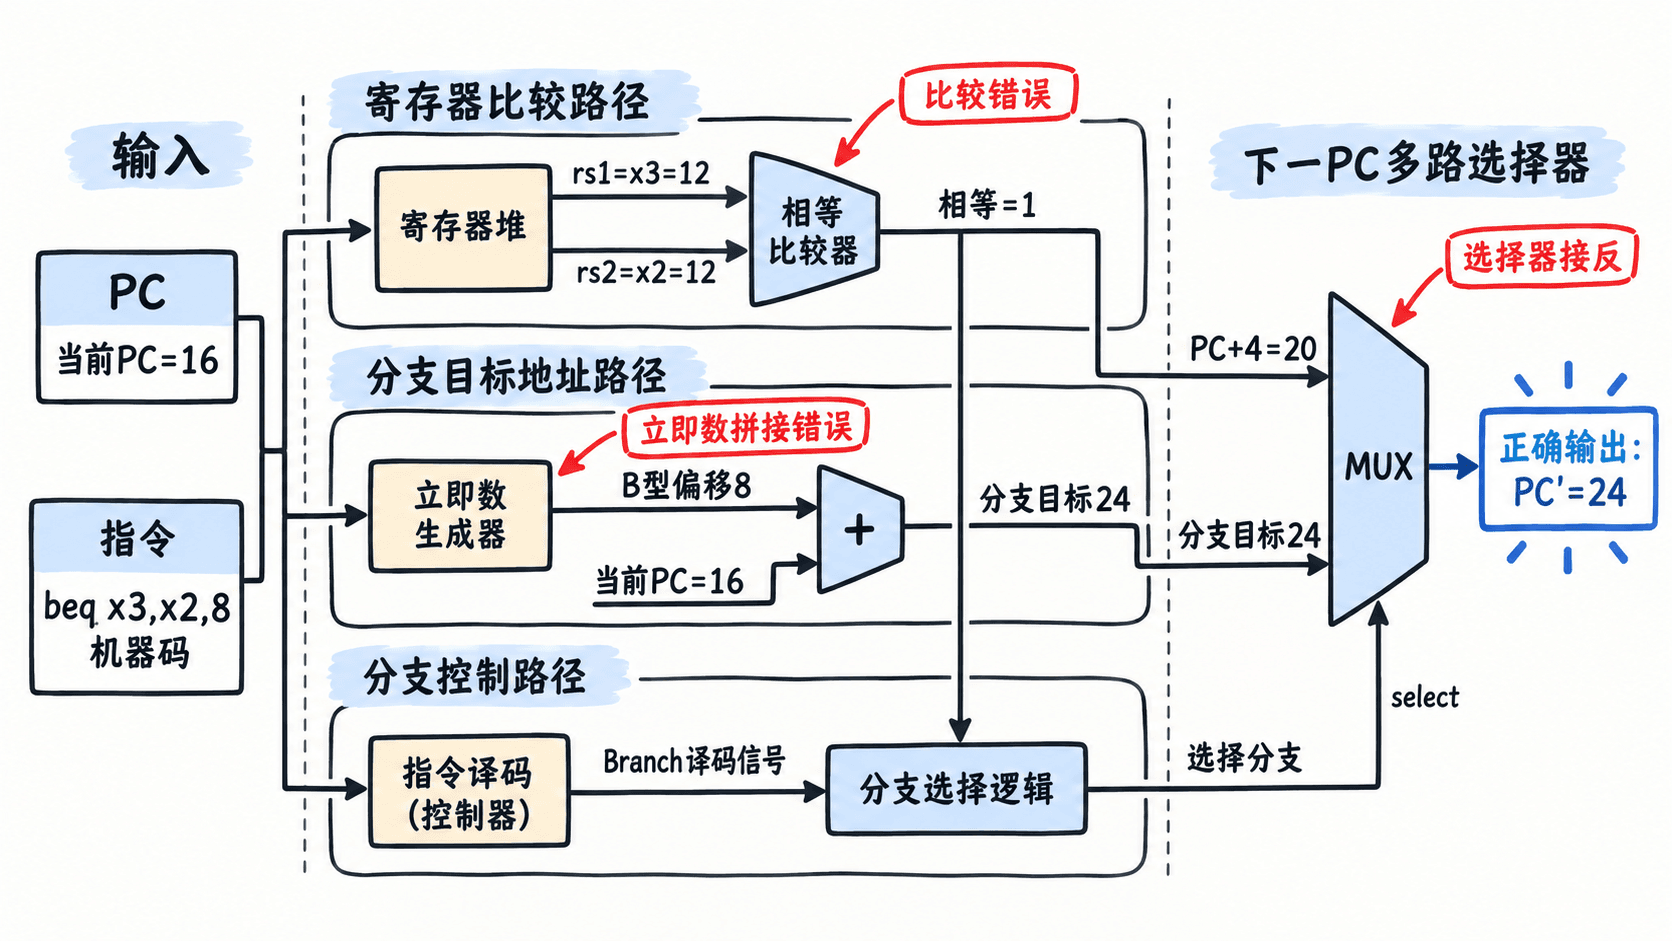
如果分支目标变为 20 或 28,应重点检查 B 型立即数的位拼接、符号扩展和最低位补零。若 PC 正确跳到 24,但 x4 在周期 5 已变化,则还存在错误写使能,必须单独修复。
把检查代码接入真实 RTL
真实单周期 CPU 的寄存器堆和存储器通常位于子模块内部。仿真阶段可以先通过层次路径读取,例如 dut.pc、dut.u_regfile.regs[1];这些名称只是接线示例,必须与实际 RTL 层次一致,不能当作固定接口。
更稳妥的做法是在仿真包装模块中统一导出观察信号:当前 PC、指令、寄存器写使能、目的寄存器编号、写回数据、存储器写使能、写地址和写数据。这样定位错误时不必依赖波形里临时查找深层实例。
联调按照以下顺序验收:
- 复位后 PC=0、x0=0,并确认测试用寄存器和存储器已初始化。
- 每个上升沿前记录实际执行的 PC 与指令编码,确认没有指令地址错位。
- 每个上升沿后核对完整预期状态,而不仅是当前指令修改的字段。
- 若首次失败,记录期望值、实际值和译码信号,修正后从复位重新运行六个周期。
- 最终确认 PC=28、x1=5、x2=12、x3=12、x4=17、MEM[0]=12,且被跳过的指令没有产生架构状态变化。
当六个周期全部通过后,再加入 bne 不跳转、负立即数、非零存储器偏移和写 x0 等边界测试。每新增一条指令,都同时写明执行前状态、期望 PC 和允许发生的状态修改,保证错误能够定位到第一次偏离预期的周期。