
质量与可靠性 / 系统课时
用故障和修复时间计算可用度
用故障和修复时间计算可用度
一台设备在 720 小时内发生三次故障,仅凭故障次数无法判断它实际能提供多长时间的服务。通过整理正常运行与故障恢复记录,可以计算观察期可用度;在满足长期稳定运行的假设时,还能利用平均正常运行时间和平均恢复时间估算稳态可用度。
学习目标
- 从故障和恢复日志中统计正常运行时间、不可用时间及观察期可用度。
- 使用平均正常运行时间与平均恢复时间估算稳态可用度,并判断适用条件。
- 用 Python 复核计算结果,避免停机口径、重复计数和截尾数据造成的错误。
把事件整理成时间账本
可用度衡量的是设备在指定时间范围内处于可执行规定功能状态的时间比例。 对可维修设备,发生故障后可以恢复运行,因此同一观察窗口内可能出现多段正常运行和多段停机。
假设一台工业水泵需要全天连续提供服务,观察窗口为连续 720 小时,期间没有计划检修。以观察开始时刻为第 0 小时,故障与恢复记录整理如下。
| 顺序 | 正常运行时间 | 随后的不可用时间 |
|---|---|---|
| 第 1 段 | 100 小时 | 2 小时 |
| 第 2 段 | 150 小时 | 3 小时 |
| 第 3 段 | 250 小时 | 5 小时 |
| 第 4 段 | 210 小时 | 观察结束时仍在运行 |
由此得到:
- 正常运行时间:100 + 150 + 250 + 210 = 710 小时。
- 故障恢复期间的不可用时间:2 + 3 + 5 = 10 小时。
- 观察窗口总长度:710 + 10 = 720 小时。
- 故障次数:3 次,且三次故障均已恢复。
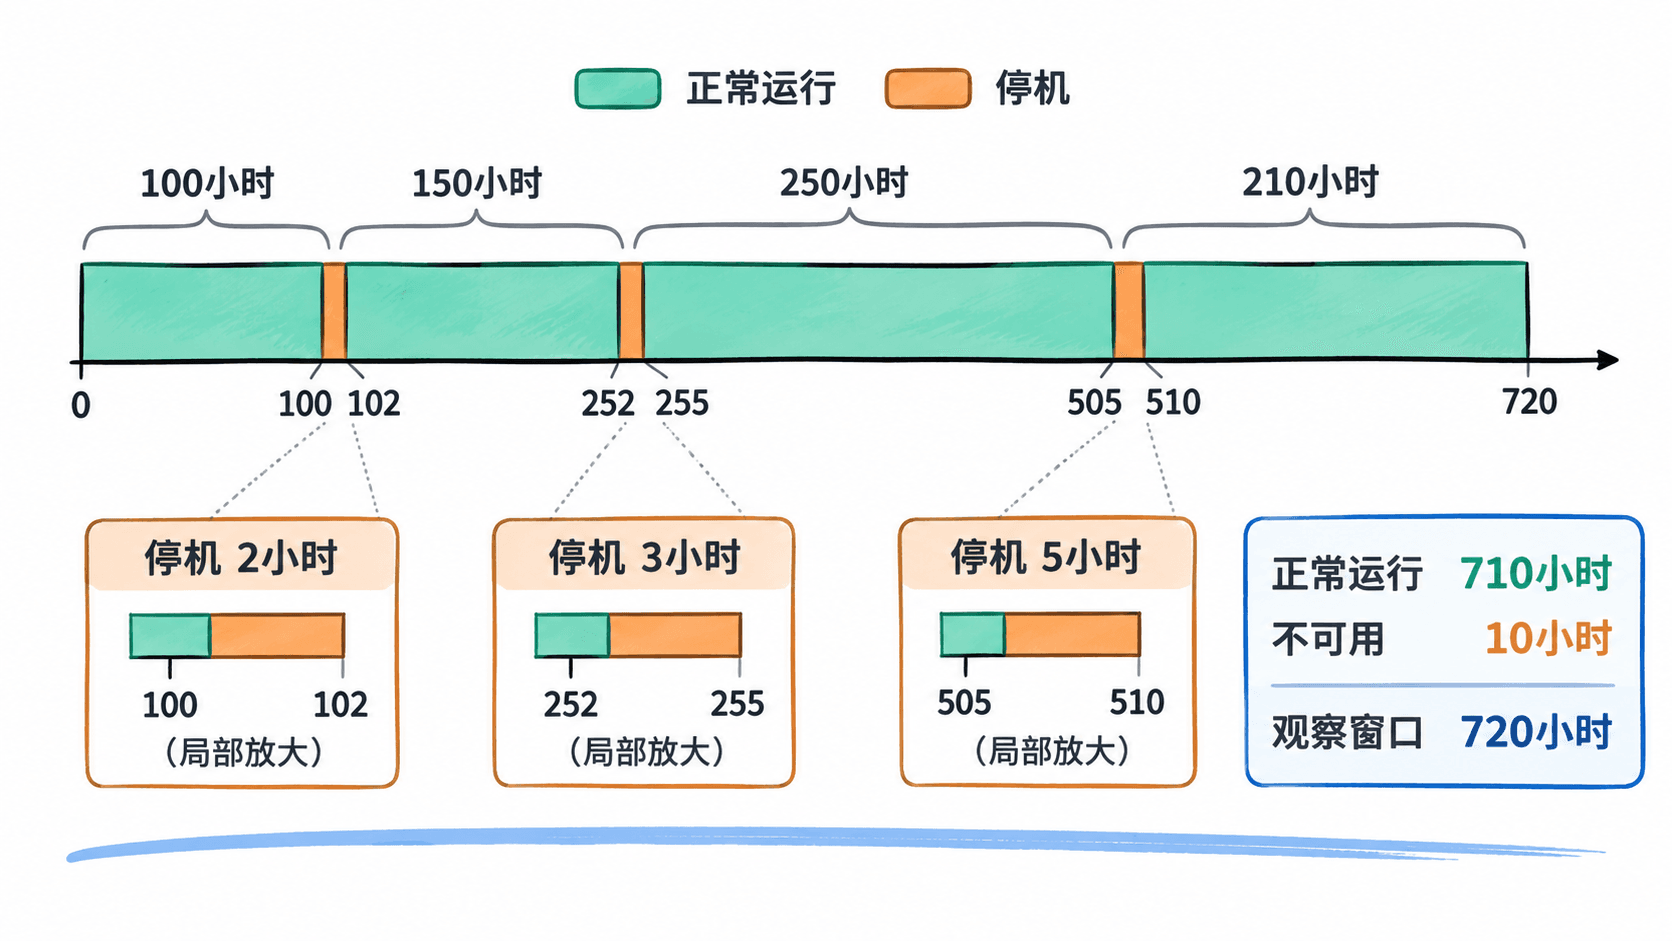
这里把设备无法完成规定功能、等待维修、实际维修及恢复确认期间的时间都计入不可用时间。若只统计维修人员实际动手的工时,忽略等待备件的时间,就可能高估实际服务可用度。
计算观察期可用度
观察期可用度是指定窗口内的实测时间比例。设正常运行累计时间为 ,不可用累计时间为 ,则:
代入水泵记录:
结果说明,在这 720 小时观察窗口内,水泵约有 98.61% 的时间能够执行规定功能,累计不可用时间为 10 小时。
这个比例不等于设备未来每个月必然达到的可用度,也不能直接解释为单次任务的可靠度。观察期可用度描述已经发生的时间占比;可靠度通常描述设备从某时刻开始,在规定任务时间内不发生失效的概率。
用平均时长估算稳态可用度
实际运行中,经常需要在尚未得到完整未来运行记录时估算设备长期可用度。这时可以使用平均正常运行时间 MUT(Mean Up Time)和平均不可用时间 MDT(Mean Down Time)。
对于故障后可修复、正常运行与停机恢复交替发生的系统,如果长期运行规律稳定,各阶段平均时长存在且有限,那么长期时间平均可用度可以写成:
假设另外收集了这类水泵更长时期的历史记录,估计得到:
| 指标 | 历史估计值 | 含义 |
|---|---|---|
| MUT | 240 小时 | 每个完整运行阶段平均持续时间 |
| MDT | 4 小时 | 每次失效后平均不可用时间 |
那么稳态可用度的估计为:
如果一个系统长期符合该统计模型,那么每累计约 244 小时的运行与恢复周期,平均约有 240 小时可用、4 小时不可用。这个比值不要求故障时间必须服从指数分布,但需要交替过程的长期平均具有代表性。
工程资料中也常见 。只有当 MTBF 被明确用于表示平均正常运行时间、MTTR 表示包含所需恢复过程的平均不可用时间时,才与这里的计算口径一致。某些资料把 MTBF 定义为包含维修时间的故障发生间隔,或者把 MTTR 仅定义为实际维修工时,此时不能直接套用同一表达式。
另外,720 小时观察窗口中的最后 210 小时尚未发生下一次故障,属于右删失的运行记录,不能把它当成已经完成的故障间隔,直接用于计算完整周期的平均运行时间。
本例观察期可用度为 98.61%,稳态估计为 98.36%。两者数值不同不代表计算错误:前者使用指定窗口内的实际时间,后者使用独立历史资料估计长期平均表现。只有三个故障周期的小样本通常不足以证明系统已经达到稳态。
用 Python 复核并检查口径
下面使用 Python 3 标准库完成计算,无须安装第三方依赖。将代码保存为 availability.py,运行 python availability.py 即可。
# 四段正常运行时间,最后一段在观察结束时仍在运行
up_hours = [100, 150, 250, 210]
# 三次从功能失效到恢复可用的完整停机时间
down_hours = [2, 3, 5]
window_hours = 720

up_total = sum(up_hours)
down_total = sum(down_hours)

# 检查全部状态区间是否覆盖观察窗口
assert up_total + down_total == window_hours

observed_availability = up_total / window_hours

# 长期均值来自独立历史样本,不由本窗口直接推算
mean_uptime = 240
mean_downtime = 4
steady_availability = mean_uptime / (mean_uptime + mean_downtime)

print(f"正常运行:{up_total} 小时")
print(f"累计不可用:{down_total} 小时")
print(f"观察期可用度:{observed_availability:.2%}")
print(f"稳态估计可用度:{steady_availability:.2%}")
预期输出:
正常运行:710 小时
累计不可用:10 小时
观察期可用度:98.61%
稳态估计可用度:98.36%
程序中的断言只能检查累计时长与窗口总长是否一致。实际分析还需要核查事件时间戳,确认没有遗漏区间、重复累计重叠停机或把同一次故障的多个报警工单当成多次独立失效。
例如,同一故障在 100 小时发生,维修完成于 102 小时,中间重复创建两张报修工单,仍然只应记录一次连续 2 小时的不可用事件,而不是累加为 4 小时。
对于只有一个观察窗口的设备,优先报告实测可用度和停机时长;只有在故障与修复过程具有足够历史样本、运行条件可比且长期统计规律合理时,才把平均时长计算结果作为稳态可用度的估计。