
质量与可靠性 / 系统课时
给出指定任务时间的可靠度预测
给出指定任务时间的可靠度预测
面对“设备必须连续运行 500 小时”的要求,不能用各部件平均寿命代替任务可靠度。本篇使用含右删失的演示样本,估计电源、控制器和执行器的寿命参数,再依照实际成功条件计算系统可靠度,并用程序复核预测及其适用边界。
学习目标
- 根据失效和右删失记录估计指数寿命模型的失效率。
- 按功能成功条件建立串并联可靠性框图,预测 500 小时系统可靠度。
- 使用 Python 复算结果,并识别独立性与失效机理假设的限制。
固定任务判据与数据口径
假设新设备连续执行 500 小时任务,期间不维修。只有电源 P、控制器 C 均正常,且两台执行器 M1、M2 至少有一台能独立提供全部额定输出,任务才算成功;两台 M 为同型号,寿命分布相同。
以下是演示数据而非项目实测。每组记录采用 : 是自投入使用起的运行小时数; 表示首次失效, 表示到观察结束仍未失效(右删失)。
| 部件类型 | 清洗后的 (小时, 事件) 记录 |
|---|---|
| P 电源 | (500,1)、(1200,0)、(1600,1)、(700,0) |
| C 控制器 | (600,1)、(700,1)、(800,0)、(900,1) |
| M 执行器 | (500,1)、(600,0)、(800,1)、(900,1)、(1200,1) |
实际导入时,应按部件序列号及寿命起点去重,统一为小时,核查非正时长和缺失事件标记。试验正常结束、计划退役不是失效;换件后的新寿命要另建记录,不能把维修后的累计时长拼作一次无故障寿命。
从右删失估计部件失效率
在同类部件恒定失效率、独立样本、删失与潜在失效时间独立的假设下,采用指数寿命模型。若失效数为 ,所有失效与删失样本的观察时长合计为 ,其极大似然估计及可靠度为:
| 部件 | 失效数 d | 总暴露 T(小时) | 失效率 λ(/小时) | R(500) |
|---|---|---|---|---|
| P | 2 | 4000 | 0.000500 | 0.778801 |
| C | 3 | 3000 | 0.001000 | 0.606531 |
| M | 4 | 4000 | 0.001000 | 0.606531 |
例如 P 虽有 4 条记录,却只有 2 次失效;其余 2 条右删失记录的 1900 小时也要计入总暴露。把删失误当故障,或只累计失效件的时长,都会扭曲失效率。上述样本量很小,表内是演示用点估计,不代表已证明实际失效率恒定。
将任务成功条件转换为框图
P 与 C 是公共串联部件,任一失效就中断任务。M1、M2 是功能并联部件,两者只要有一台存活便可维持规定输出。框图中的并联表示任务成功的逻辑关系,不等于现场随意放置两台机器就有冗余。
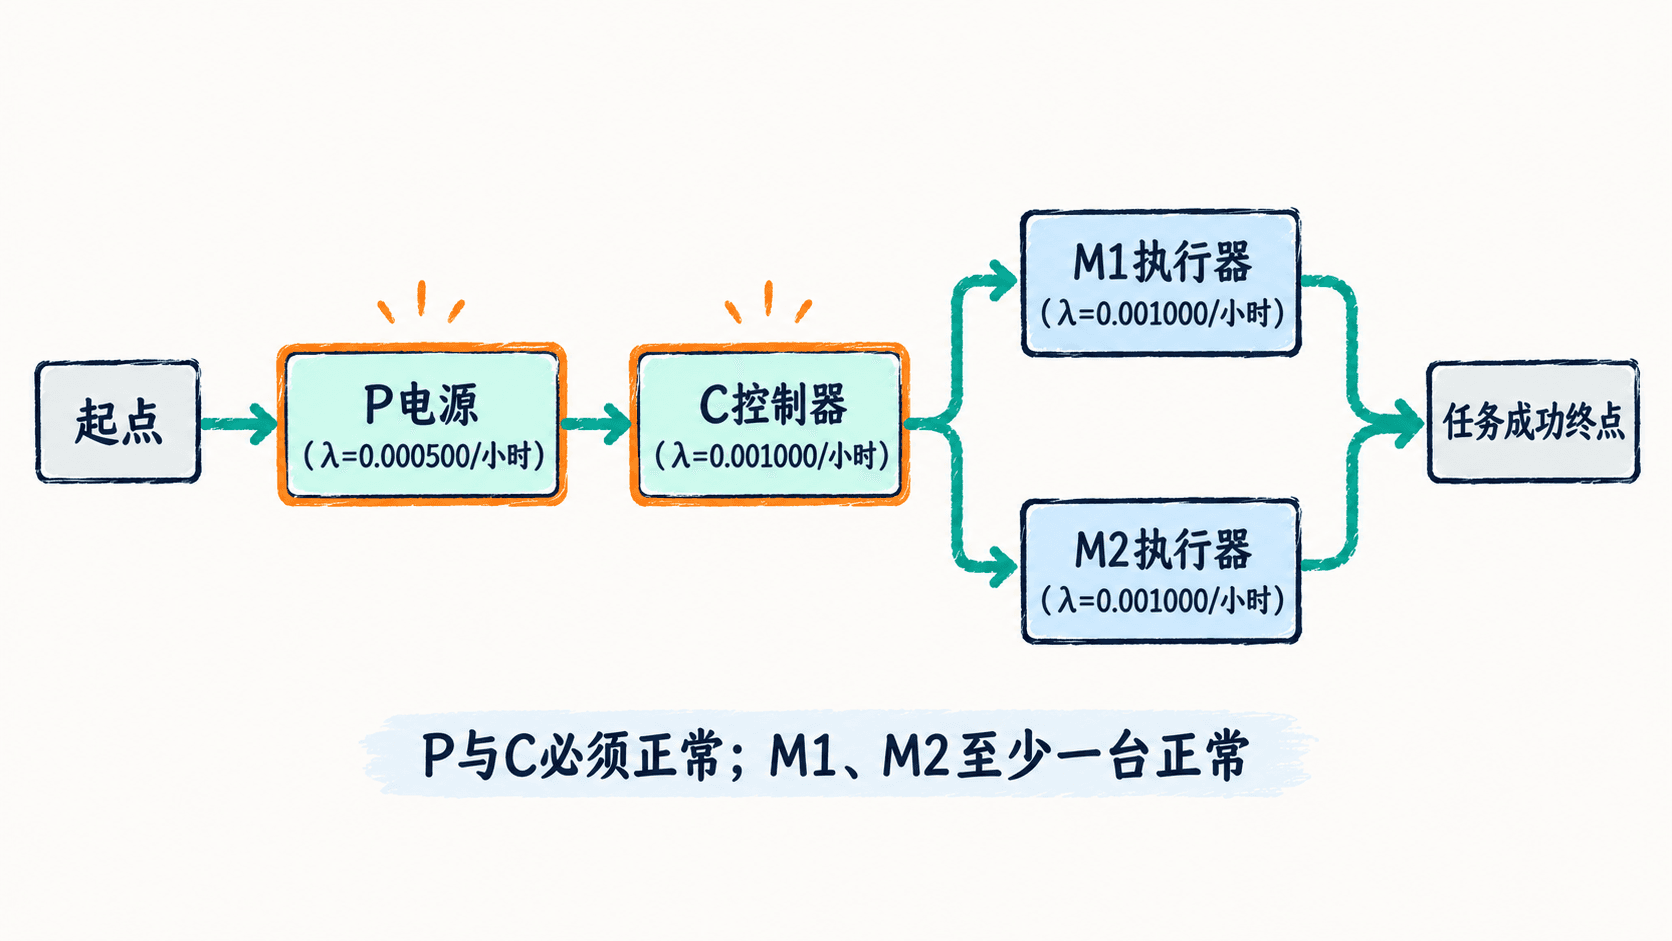
若三个部件类型相互独立,且 M1、M2 的失效也相互独立,系统可靠度为:
在 500 小时,双执行器支路可靠度为 ,整机约为 0.399236(39.92%)。不要把公共电源与控制器复制进两条冗余支路,否则会高估系统可靠度。
用 Python 复算数值
将下面内容保存为 reliability.py,使用 Python 3.9 或更新版本执行 python reliability.py;无需安装第三方库。示例中的观察时长、事件标记和任务时长都可以替换为项目数据。
import math

observations = {
    'P': [(500, 1), (1200, 0), (1600, 1), (700, 0)],
    'C': [(600, 1), (700, 1), (800, 0), (900, 1)],
    'M': [(500, 1), (600, 0), (800, 1), (900, 1), (1200, 1)],
}
mission_hours = 500
rates = {}

for name, rows in observations.items():
    # 1=失效,0=右删失;两种观察时长都计入暴露
    if not all(t > 0 and event in (0, 1) for t, event in rows):
        raise ValueError('寿命时长或事件标记不合法')
    d = sum(event for _, event in rows)
    T = sum(t for t, _ in rows)
    if d == 0:
        raise ValueError(f'{name} 无失效:需另做不确定性分析')
    rate = d / T
    rates[name] = rate
    r = math.exp(-rate * mission_hours)
    print(f'{name}: d={d}, T={T}h, lambda={rate:.6f}/h, R({mission_hours}h)={r:.6f}')

# 公共P、C串联,两台同型M独立并联
r_p = math.exp(-rates['P'] * mission_hours)
r_c = math.exp(-rates['C'] * mission_hours)
r_m = math.exp(-rates['M'] * mission_hours)
r_system = r_p * r_c * (1 - (1 - r_m) ** 2)
print(f'R_system({mission_hours}h)={r_system:.6f}')
预期输出:
P: d=2, T=4000h, lambda=0.000500/h, R(500h)=0.778801
C: d=3, T=3000h, lambda=0.001000/h, R(500h)=0.606531
M: d=4, T=4000h, lambda=0.001000/h, R(500h)=0.606531
R_system(500h)=0.399236
复核时先对照每类的 、,再确认系统值不大于 。把 mission_hours 改成 0,所有可靠度都应为 1.000000;改成更长的正任务时长,可靠度不应上升。
判断预测能否用于项目决策
若项目规定 500 小时可靠度不低于 0.90,演示模型的 0.399236 明显未达门槛,但不能用 13 条演示记录下实际产品的合格结论。正式报告至少注明数据批次、设备工况、清洗规则、每类 、任务时长、公式、框图版本及复算脚本。
还要检查三个边界:首先,指数模型要求目标时段内失效率近似恒定;出现磨损趋势时应改用带删失似然的 Weibull 等模型。其次,两台 M 若共用冷却、环境或切换机构,相关失效必须另行建模;若单台 M 无法满足额定输出,不能直接采用并联成功公式。最后,本例样本少,应补充参数置信区间或似然轮廓分析,报告系统可靠度的不确定性,而不能把六位小数当作预测精度。