
质量与可靠性 / 系统课时
用 KM 曲线估计删失样本可靠度
用 KM 曲线估计删失样本可靠度
当寿命试验结束时,尚未失效的设备并不是“寿命等于观察时长”。本篇用 8 台水泵的失效与右删失记录,从风险集逐时点计算 Kaplan–Meier(KM)可靠度,复核台阶位置,并说明为什么曲线尾部不能直接外推。
学习目标
- 区分真实失效和右删失,整理单台设备的末次观测记录。
- 用风险集与失效数逐阶计算 KM 可靠度,并通过代码复核。
- 识别删失刻度、并列失效和尾部不确定性,避免错误外推。
区分失效与右删失
假设 8 台同型号水泵从投入试验的时刻开始计时,每台只记录首次达到失效判据的时间,或最后一次确认仍正常运行的时间。后者称为右删失:只知道真实寿命大于该观察时长,不能把它当作那一刻的失效。
| 设备 | 观测时间(小时) | 结局 |
|---|---|---|
| A | 100 | 失效 |
| B | 150 | 右删失 |
| C | 200 | 失效 |
| D | 200 | 失效 |
| E | 260 | 右删失 |
| F | 300 | 失效 |
| G | 360 | 右删失 |
| H | 400 | 右删失 |
本例假定所有水泵均在 0 小时进入观察,且设备退出试验的原因与其尚未观测到的失效时间独立。如果有故障征兆的设备更容易提前退出,普通 KM 估计可能产生偏差。
按失效时点更新风险集
设 为失效时点 到来前仍在观察、尚未失效的设备数(风险集), 为该时点的失效台数。把每次“条件下继续存活的比例”相乘,就得到 KM 可靠度估计:
计算时按时间排序,失效使曲线下降;右删失本身不改变曲线高度,只使后续风险集减少。若一个时点既发生失效又有右删失,通常把该时点删失者计入失效计算时的风险集,之后再一并移出。
本例可以分三次更新:
- 100 小时:,得到 。
- 150 至 200 小时:150 小时有 1 台删失,200 小时开始时 ;C、D 同时失效,,因此 。
- 260 至 300 小时:260 小时又删失 1 台,300 小时开始时 ,所以 。
360 和 400 小时只发生删失,不再出现失效台阶。不能把两台同时失效拆成两个不同时间的下降,也不能将删失当作失效参与 。
用 Python 复算每个时点
以下代码使用 Python 3 标准库,按时间汇总失效与右删失,打印每个观测时点开始时的风险集及更新后的可靠度。状态值 1 代表失效、0 代表右删失。
# 每条记录为:设备、观测小时、状态(1=失效,0=右删失)
records = [
    ("A", 100, 1), ("B", 150, 0),
    ("C", 200, 1), ("D", 200, 1),
    ("E", 260, 0), ("F", 300, 1),
    ("G", 360, 0), ("H", 400, 0),
]

at_risk = len(records)
reliability = 1.0
print("hour,risk,failed,censored,R")

for hour in sorted({time for _, time, _ in records}):
    failed = sum(1 for _, t, s in records if t == hour and s == 1)
    censored = sum(1 for _, t, s in records if t == hour and s == 0)
    # 同时点的删失者仍计入该时点风险集,随后统一移出
    if failed:
        reliability *= (at_risk - failed) / at_risk
    print(f"{hour},{at_risk},{failed},{censored},{reliability:.4f}")
    at_risk -= failed + censored
预期输出:
hour,risk,failed,censored,R
100,8,1,0,0.8750
150,7,0,1,0.8750
200,6,2,0,0.5833
260,4,0,1,0.5833
300,3,1,0,0.3889
360,2,0,1,0.3889
400,1,0,1,0.3889
核对时重点看 150 和 260 小时:可靠度保持不变,但后续风险集分别减少 1;200 小时两台同时失效,应只在这一时点计算一次 的下降系数。
读取曲线及尾部可信范围
KM 曲线是右连续的阶梯线:仅在真实失效时点下降,删失时点用短刻度标记而不产生下降。曲线旁或下方应同时标出风险集,否则很容易把尾部水平段误认为长期稳定的可靠度。
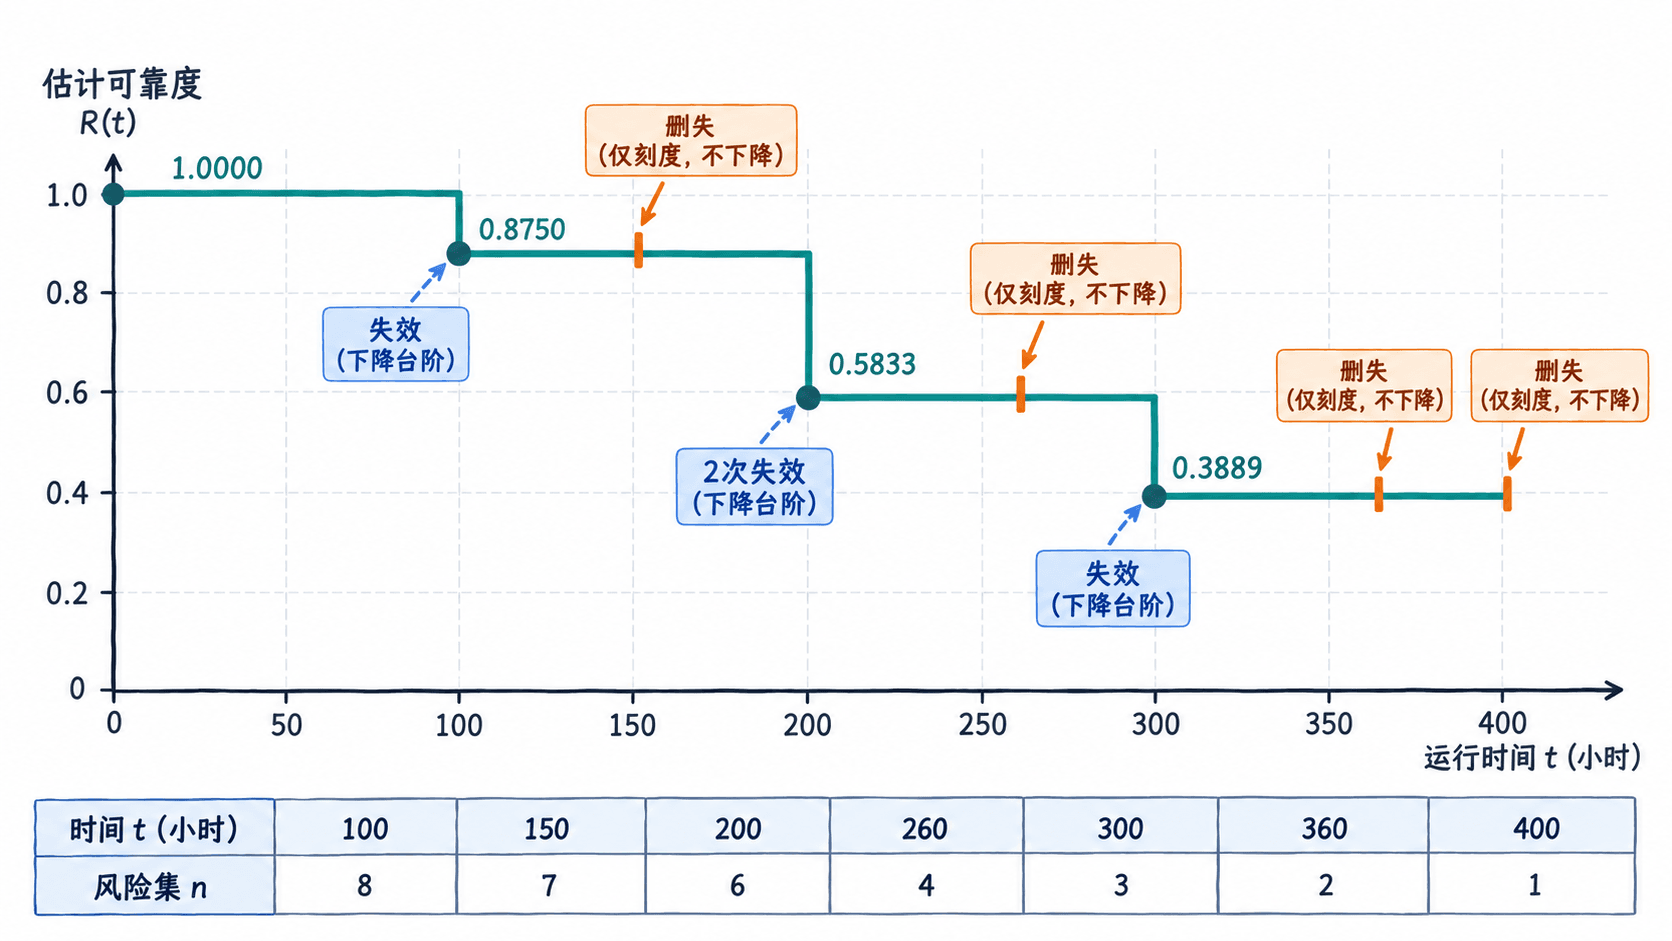
从曲线可读出,200 小时可靠度约为 58.33%,300 小时约为 38.89%;由于首次在 300 小时降至 50% 以下,样本的 KM 中位寿命估计为 300 小时,这不是平均寿命。
但 300 小时的失效台阶计算时只有 3 台在险,360 和 400 小时剩余的两台又相继删失,之后已无人继续观察。曲线没有继续下降,不代表 400 小时以后仍能保证 38.89% 的可靠度。
需要报告估计精度时,可用 Greenwood 公式计算标准误。本例在 300 小时的近似标准误为 ,已相当于点估计的一半左右。正式报告宜连同风险集、删失数量和适当方法计算的置信区间一起展示,并限制解释范围,避免在最后删失时点之后外推。